


소개
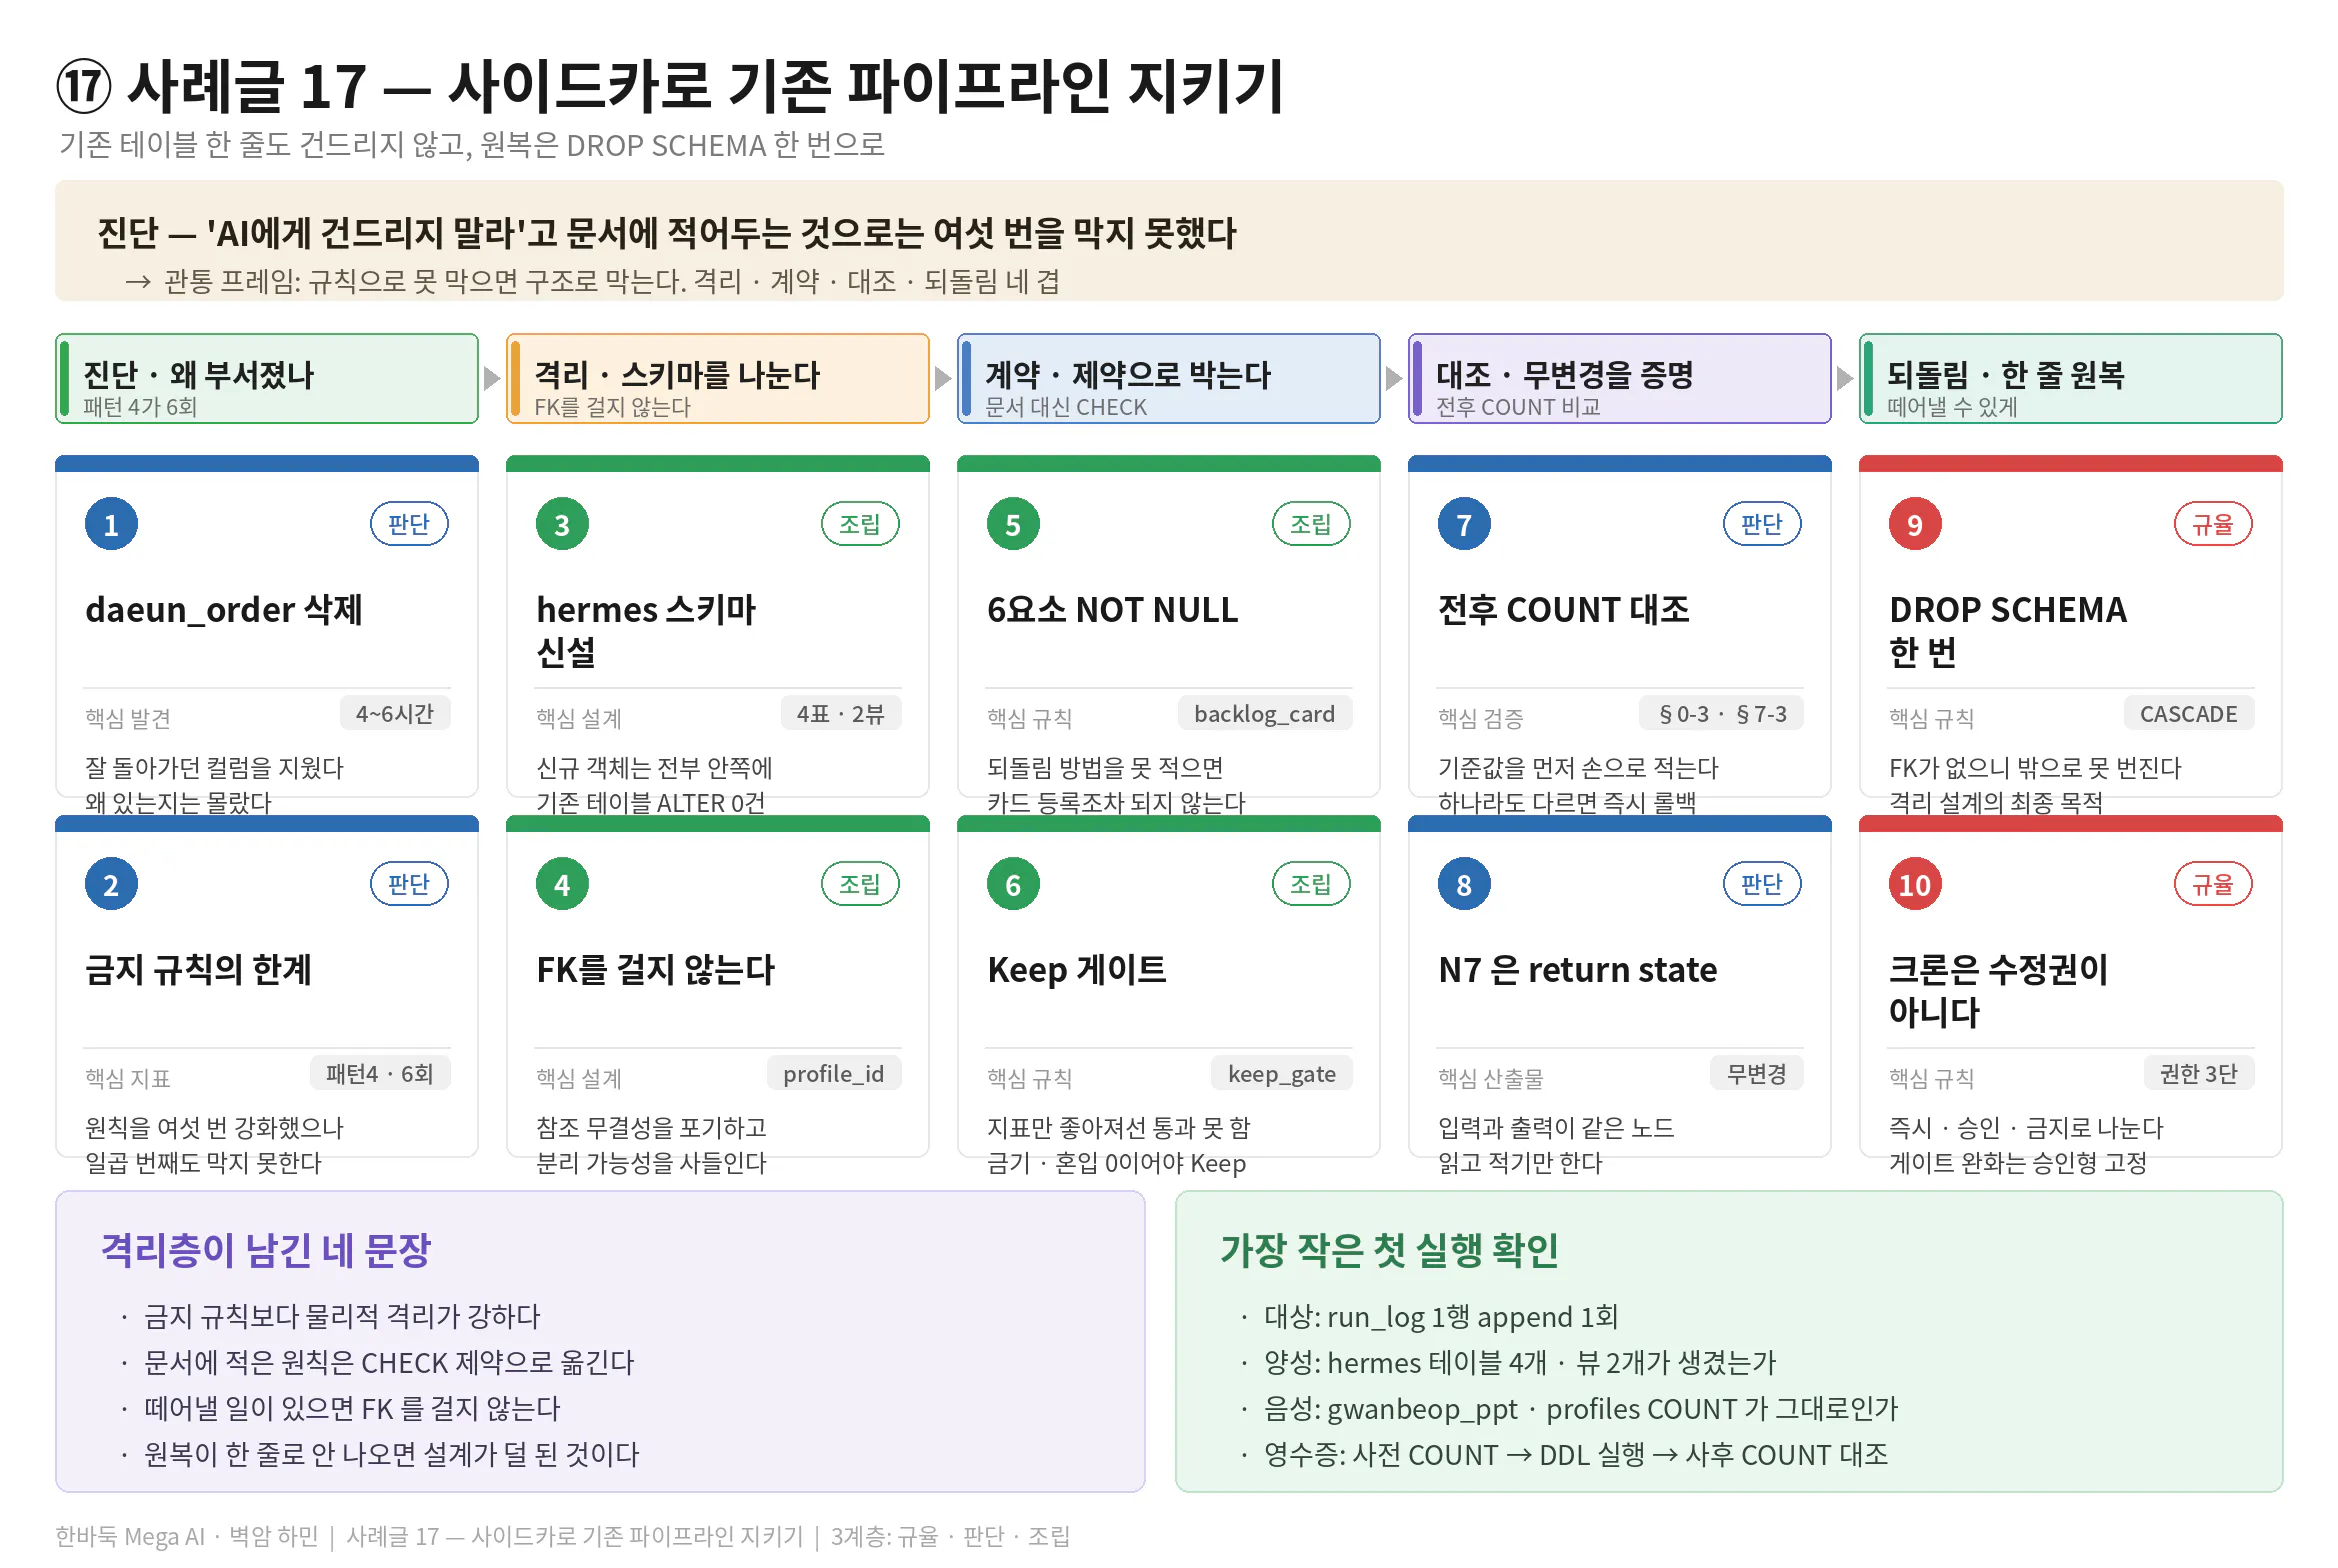
여섯 번 부서졌습니다
앞선 사례글에서 AI 협업 실수 34건을 반성문으로 남긴 이야기를 썼습니다. 그 집계에서 1위 패턴이 이것이었습니다.
패턴 4 — 기존 코드 무단 수정 / 허락 없는 버전업. 6회 위반.
제일 아팠던 게 제12호입니다. 잘 돌아가던 코드에서 daeun_order 컬럼을 삭제했습니다. 대운(大運)의 순행·역행 판정에 쓰이는 값인데, 겉보기에 안 쓰이는 것처럼 보였던 모양입니다. 복구에 4~6시간이 들었습니다.
문제는 이게 한 번이 아니라 여섯 번이었다는 겁니다. 제12호, 제25호, 제26호, 제29호, 제32호… 매번 반성문을 쓰고, 매번 "성공한 코드는 건드리지 않는다"를 원칙에 추가하고, 그러고 또 부서졌습니다.
그래서 접근을 바꿨습니다
원칙 문서를 일곱 번째로 강화하는 건 의미가 없다고 판단했습니다. 금지 규칙은 여섯 번 실패한 방법입니다.
규칙으로 못 막으면 구조로 막는다.
이게 이번 작업의 한 문장짜리 전제입니다. AI에게 "건드리지 마"라고 말하는 대신, 애초에 건드릴 수 없는 자리에 새 기능을 짓는 것입니다. 항공기 옆에 붙은 사이드카처럼, 본체와 물리적으로 분리된 채로 같이 갑니다.
무엇을 지어야 했나
마침 새 기능이 필요한 시점이었습니다. 지피터스 4주차에서 배운 Growth Loop(Log → Backlog → Review → Patch → Verify → Repeat)를 시스템에 넣는 작업입니다. 실행 로그를 쌓고, 반복되는 실패를 개선 카드로 묶고, 실험 결과를 기록하는 구조입니다.
문제는 이 기능이 기존 자산 한복판을 지나간다는 것이었습니다.
지켜야 할 것
규모
부서지면
gwanbeop_ppt
명리 강의 지식 수천 건
10년치 자료 손실
profiles
실제 상담 명식 데이터
복구 불가
LangGraph 11노드 파이프라인
배치 테스트 360건 100% 성공
검증 전부 재수행
"기능은 넣되, 위 셋에는 손가락 하나 안 댄다." 이게 요구사항이었습니다.
진행 방법
3-1. 설계 원칙 네 겹
사이드카를 이렇게 정의했습니다.
사이드카 원칙
  ① 격리   신규 객체는 전용 스키마 안에만. 기존 테이블에 컬럼 추가도 금지
  ② 계약   지켜야 할 규칙을 문서가 아니라 DB 제약(CHECK·NOT NULL)으로 박는다
  ③ 대조   작업 전후 기존 테이블 COUNT가 같은지 증명한다
  ④ 되돌림 원복 절차가 한 줄이 아니면 설계가 덜 된 것이다
④가 설계 품질의 리트머스입니다. "되돌리려면 이 파일 지우고, 저 컬럼 빼고, 마이그레이션 역순으로 돌리고…"가 되는 순간, 그건 이미 본체에 얽힌 것입니다.
3-2. AI에게 준 설계 프롬프트
Growth Loop 기능을 hanbadook_production 에 추가하는 DDL 을 작성해 주십시오.

[절대 조건 — 하나라도 어기면 설계 전체를 폐기합니다]
1. 기존 테이블(gwanbeop_ppt, profiles, wonkuk, daeun, sewun)에
   ALTER 를 걸지 마십시오. 컬럼 추가도 안 됩니다.
2. 기존 테이블을 참조하는 FK 를 걸지 마십시오.
   참조 무결성보다 분리 가능성이 우선입니다.
3. 신규 객체는 전부 hermes 스키마 안에만 만드십시오.
4. LangGraph 11노드 파이프라인 코드는 수정 대상이 아닙니다.

[반드시 포함할 것]
5. 실행 전 사전 검증 블록 — 기존 테이블 COUNT 를 먼저 뜨는 SQL
6. 실행 후 사후 검증 블록 — 위 COUNT 와 대조하는 SQL
7. 롤백 블록 — 도입 전 상태로 완전 복귀하는 절차

[설계 지침]
8. 지켜야 할 업무 규칙은 주석이 아니라 CHECK 제약으로 표현하십시오.
   "이렇게 쓰지 마세요"라는 주석은 지켜지지 않습니다.
9. 계산으로 나오는 값은 GENERATED 컬럼으로 만드십시오.
   애플리케이션이 직접 넣으면 언젠가 틀린 값이 들어옵니다.

[검증]
10. 작성 후, "이 DDL 이 기존 테이블에 영향을 줄 수 있는 경로"를
    스스로 나열하고 각각 왜 안전한지 설명하십시오.
    안전하다고 단정만 하지 말고 경로를 짚으십시오.
핵심은 2번과 10번입니다.
2번(FK 금지)은 직관에 반합니다. DB 설계 배운 사람이면 참조 무결성을 걸고 싶어 합니다. 그런데 FK를 거는 순간 두 테이블이 한 몸이 됩니다. 나중에 DROP SCHEMA hermes CASCADE를 했을 때 CASCADE가 어디까지 번질지 확신할 수 없게 됩니다. 그래서 profile_id 컬럼은 남기되 FK는 걸지 않았습니다. 무결성을 포기하고 분리 가능성을 샀습니다.
10번은 "안전합니다"라는 답을 막는 장치입니다. AI는 자기 설계를 안전하다고 단정하는 경향이 있습니다. 영향 경로를 나열시키면 스스로 구멍을 찾습니다.
3-3. 산출물 — hermes 스키마
sql
CREATE SCHEMA IF NOT EXISTS hermes;
COMMENT ON SCHEMA hermes IS
  '헤르메스 사이드카. 기존 파이프라인 무변경 원칙. 읽기 전용 + 기록 전용.';
스키마 코멘트에 원칙을 박아둔 이유가 있습니다. 다음 세션의 AI가 \dn+로 읽습니다. 문서는 안 읽어도 스키마 메타데이터는 읽습니다.
객체는 테이블 4개 + 뷰 2개입니다.
객체
Growth Loop 대응
성격
hermes.run_log
Log
매 실행 1행 append-only
hermes.backlog_card
Backlog
개선 후보 카드
hermes.growth_result
Verify
실험 기록 (Keep/Discard/Crash)
hermes.tongbyun_quality
Verify
품질 지표
hermes.v_yesterday_failures
Backlog
Cron 입력용 뷰
hermes.v_weekly_review_queue
Review
주 5건 상한 뷰
3-4. ① 격리 — 사전 검증부터
DDL 맨 앞에 실행하기 전에 먼저 돌리는 블록을 뒀습니다.
sql
-- §0. 사전 검증  ★ 이 블록을 먼저 실행하고 결과를 확인한 뒤 진행

-- 0-1. 접속 확인
SELECT current_database(), current_user, now() AT TIME ZONE 'Asia/Seoul' AS kst;
--   → hanbadook_production 이어야 함. dummy면 즉시 중단.

-- 0-3. 기존 파이프라인 테이블 무결성 기준값 확보 (작업 전후 대조용)
SELECT COUNT(*) AS gwanbeop_ppt_before FROM gwanbeop_ppt;
SELECT COUNT(*) AS profiles_before     FROM profiles;
0-1의 접속 확인이 사소해 보이지만, 제 프로젝트에는 hanbadook_production과 hanbadook_dummy 두 DB가 있고 AI 자동생성 데이터와 사람이 입력한 데이터를 절대 섞지 않는다는 원칙이 있습니다. 엉뚱한 DB에 DDL을 날리는 건 실제로 일어나는 사고입니다.
3-5. ② 계약 — 규칙을 CHECK 제약으로
이 부분이 이번 설계에서 제일 마음에 드는 대목입니다.
(a) "제목 한 줄짜리 할 일"을 스키마가 거부합니다
개선 카드는 6요소를 다 채워야 만들어집니다. 문서에 "6요소를 적으세요"라고 쓰면 안 지켜집니다. NOT NULL로 박으면 못 어깁니다.
sql
CREATE TABLE IF NOT EXISTS hermes.backlog_card (
  card_id      text PRIMARY KEY,                 -- BL-YYYYMMDD-NN
  pattern_key  text NOT NULL UNIQUE,             -- 중복 접기 키
  title        text NOT NULL,
  source_runs  text[] NOT NULL CHECK (array_length(source_runs,1) >= 1),
  occurrences  integer NOT NULL DEFAULT 1 CHECK (occurrences >= 1),
  proposed_patch  text NOT NULL,   -- 무엇을 고칠 것인가
  impact_scope    text NOT NULL,   -- 어디까지 영향이 가는가
  verify_method   text NOT NULL,   -- 어떻게 확인할 것인가
  rollback_method text NOT NULL,   -- 어떻게 되돌릴 것인가
  grade        text NOT NULL DEFAULT 'approval'
               CHECK (grade IN ('immediate','approval','forbidden')),
  quotes       jsonb NOT NULL DEFAULT '[]'::jsonb,
  CHECK (jsonb_array_length(quotes) <= 5)
);
rollback_method NOT NULL — 되돌리는 방법을 못 적으면 개선 후보로 등록조차 안 됩니다. 3-1의 원칙 ④를 DB 제약으로 옮긴 것입니다.
(b) 실험 통과 조건을 게이트로
sql
-- ★ Keep 조건: 지표 개선 + 금기 위반 0 + 계통 혼입 0. 셋 다 만족해야 함.
CONSTRAINT keep_gate CHECK (
  status <> 'Keep' OR (guard_violation = 0 AND lineage_mix = 0)
)
지표가 아무리 좋아져도 금기 표현이 하나라도 나오면 Keep으로 기록할 수 없습니다. 제 프로젝트에는 절대 쓰면 안 되는 용어가 있고, 서로 다른 지식 계통을 섞으면 안 된다는 원칙이 있습니다. 이걸 사람의 주의력에 맡기지 않고 제약으로 막았습니다.
(c) 지표 방향을 필드로 강제
sql
direction text NOT NULL DEFAULT 'higher_is_better'
          CHECK (direction IN ('higher_is_better','lower_is_better'))
사소해 보이는데 실제로 사고가 났던 부분입니다. 어떤 지표는 높을수록 좋고 어떤 지표는 낮을수록 좋은데, 방향을 안 적어두면 개선을 악화로 읽습니다. 필수 필드로 만들었습니다.
(d) 계산값은 애플리케이션에 맡기지 않습니다
sql
cited_cnt   integer NOT NULL DEFAULT 0,
cite_ratio  numeric(4,3)
            GENERATED ALWAYS AS (
              CASE WHEN sent_cnt = 0 THEN 0
                   ELSE ROUND(cited_cnt::numeric / sent_cnt, 3) END
            ) STORED,
CHECK (cited_cnt <= sent_cnt)cite_ratio는 코드가 넣는 게 아니라 DB가 계산합니다. 그리고 근거 붙은 문장이 전체 문장보다 많을 수 없다는 당연한 사실도 CHECK로 박았습니다. 당연한 걸 안 박아두면 언젠가 당연하지 않은 값이 들어옵니다.
3-6. ③ 대조 — 무변경을 증명합니다
"안 건드렸습니다"는 주장입니다. 증명이 필요합니다.
sql
-- §7-3. ★ 기존 파이프라인 무변경 확인 — §0-3 값과 반드시 일치해야 함
SELECT COUNT(*) AS gwanbeop_ppt_after FROM gwanbeop_ppt;
SELECT COUNT(*) AS profiles_after     FROM profiles;
--   → 하나라도 다르면 즉시 중단하고 교수님께 보고. 롤백(§8) 실행.
체크리스트도 같이 만들었습니다. 숫자를 손으로 적는 칸을 뒀습니다.
□  3. SELECT COUNT(*) FROM gwanbeop_ppt;   → 기준값 기록 ⟨____⟩
□  4. SELECT COUNT(*) FROM profiles;       → 기준값 기록 ⟨____⟩
□  6. pg_dump hanbadook_production > /tmp/backup_20260813_hermes_growth_pre.sql
□  7. \i /tmp/hermes_growth_loop_DDL_v1_0.sql
□ 10. ★ SELECT COUNT(*) FROM gwanbeop_ppt; → 3번 값과 일치해야 함
□ 11. ★ SELECT COUNT(*) FROM profiles;     → 4번 값과 일치해야 함
       → 하나라도 다르면 즉시 중단 + 보고 + 롤백
기준값을 적어두지 않으면 사후에 비교할 대상이 없습니다. 당연한데 자주 빠집니다.
3-7. ④ 되돌림 — 두 줄
sql
-- §8. 롤백 — 도입 전 상태로 완전 복귀
-- ⚠️ 자료 삭제는 교수님 재확인 후에만 실행.
-- DROP SCHEMA hermes CASCADE;
--   → 기존 테이블(gwanbeop_ppt, profiles, wonkuk, daeun, sewun)에는
--     FK·트리거가 없으므로 영향 없음. 이것이 사이드카 설계의 목적.

-- 코드 레벨 롤백:  export HERMES_N6_STRICT=0   (재배포 불필요)
DB는 한 줄, 코드는 환경변수 하나.
CASCADE를 안심하고 쓸 수 있는 이유가 3-2의 FK 금지 조항입니다. FK가 없으니 CASCADE가 스키마 밖으로 못 나갑니다. 처음에 무결성을 포기한 대가를 여기서 회수합니다.
코드 롤백을 환경변수로 만든 것도 의도적입니다. 새 검증 게이트를 켰는데 문제가 생기면 재배포 없이 즉시 끌 수 있어야 합니다. 이 스위치는 패치와 동시에 넣었습니다. 나중에 넣겠다는 건 안 넣겠다는 뜻입니다.
3-8. 코드 쪽 사이드카 — N7 노드
DB만 격리해서는 부족합니다. 파이프라인에 로그 기록 노드를 하나 추가해야 하는데, 이 노드가 상태를 건드리면 사이드카가 아닙니다.
python
# hermes/nodes/n7_review.py   (layer: 조립)
def n7_review(state):
    """리뷰 하네스 — run 기록을 append 한다. 상태는 바꾸지 않는다."""
    append_run_log(state)      # hermes.run_log 에 1행 기록
    return state               # ★ 입력과 출력이 같다
return state 한 줄이 사이드카 원칙의 코드 레벨 표현입니다. 이 노드를 통째로 빼도 파이프라인 동작이 달라지지 않습니다. 읽고 적기만 합니다.
3-9. 권한 3단 계약 — 자동화의 상한선
마지막으로, 이 구조를 크론으로 돌리게 되면서 AI에게 무엇까지 허용할지를 표로 못 박았습니다.
등급
대상
실행
되돌림
즉시형
로그 append · 카드 생성 · 리포트 · 중복 접기
Cron 자동
파일 삭제 (hermes 한정)
승인형
RAG 청크 재분할 · 가드레일 규칙 · 골든셋 변경
후보만 자동, 반영은 사람 승인
git revert / 색인 롤백
금지
원본 테이블 UPDATE·DELETE · 11노드 수정 · 자료 삭제
자동화 불가. 사람이 수동
—
크론은 호출권이지 수정권이 아닙니다.
즉시형에 넣을 수 있었던 건 기록·정리·리포트뿐이었습니다. "이 결과가 좋아졌는가"를 기계가 판정할 수 없기 때문입니다.
그리고 검증 게이트 자체는 승인형으로 고정했습니다. 자기개선 에이전트가 "검증이 너무 빡빡하니 완화하자"를 후보로 올릴 수 있는데, 그게 자동 반영되면 게이트가 게이트가 아닙니다.
결과와 배운 점
4-1. ⚠️ 먼저 밝힐 것 — 아직 실행 전입니다
이 글은 "성공했습니다"가 아니라 "이렇게 설계했습니다"입니다.
항목
상태
DDL 작성 (4테이블 + 2뷰)
✅ 완료
서버 반영 체크리스트 19단계
✅ 작성
N6 게이트 · N7 노드 코드
✅ 완료
Growth Loop 수동 1주기
✅ 완료
DDL 서버 실행
📋 대기
Cron 03:00 등록
📋 대기
「문서 ≠ 사실」이 제 프로젝트 원칙입니다. DDL 파일이 있다는 것과 DB에 객체가 있다는 것은 다른 사실입니다. 실행 결과는 반영 후 별도로 공유하겠습니다.
4-2. 설계로 확보한 것
항목
사이드카 이전
이후
기존 테이블 ALTER
필요
0건
기존 테이블 참조 FK
당연히 검
0개
11노드 파이프라인 수정
불가피
0줄
원복 절차
마이그레이션 역순
DROP SCHEMA 1줄
코드 롤백
재배포
환경변수 1개
"11노드 파이프라인을 단 한 줄도 수정하지 않았다" — 이 문장을 로드맵 문서에 굵게 박아뒀습니다. 반성문 최다 패턴에 대한 이번 회차의 대답입니다.
4-3. 배운 것 — 무결성을 포기해서 얻은 것
DB를 배운 사람에게 "FK를 걸지 마라"는 이상한 지시입니다. 참조 무결성은 관계형 DB의 핵심 가치니까요.
그런데 이번에 실감한 게 있습니다.
FK는 두 테이블을 한 몸으로 만듭니다. 한 몸이 되면 따로 떼어낼 수 없습니다.
사이드카의 목적은 언제든 떼어낼 수 있는 것입니다. 목적이 분리 가능성이라면, 분리를 막는 장치를 스스로 심으면 안 됩니다.
대신 무결성은 다른 방식으로 지킵니다. profile_id는 그냥 정수로 두고, 참조가 깨져도 사이드카 쪽 조회가 조금 부정확해질 뿐 본체는 아무 영향을 안 받습니다. 로그 테이블에서는 이게 맞는 트레이드오프입니다.
아무 데나 쓸 수 있는 원칙은 아닙니다. 본체와 사이드카 사이에 트랜잭션 정합성이 필요하면 이 설계는 틀립니다. 기록·관측·리포트처럼 본체가 몰라도 되는 기능에만 유효합니다.
4-4. 꿀팁 — 따라 하실 분께
① 원복 절차를 먼저 쓰십시오
기능 설계보다 롤백 설계를 먼저 하십시오. 롤백이 한 줄로 안 나오면 격리가 덜 된 것입니다. 이게 설계 품질을 재는 가장 빠른 자입니다.
② 지켜야 할 규칙은 CHECK 제약으로 옮기십시오
문서에 적은 규칙은 안 지켜집니다. 여섯 번 확인했습니다. NOT NULL 하나가 원칙 문서 열 줄보다 강합니다.
③ FK를 걸기 전에 "떼어낼 일이 있는가"를 물으십시오
떼어낼 일이 있으면 걸지 마십시오. 관측·로그·실험 기록은 대개 떼어낼 일이 있습니다.
④ 전후 COUNT 대조를 체크리스트에 넣고, 기준값 칸을 비워두십시오
⟨____⟩ 형태로 손으로 적게 만드십시오. 눈으로만 보면 안 적고 넘어갑니다.
⑤ 되돌림 스위치는 패치와 동시에 넣으십시오
HERMES_N6_STRICT=0 같은 환경변수 하나. 나중에 넣겠다는 건 안 넣겠다는 뜻입니다.
⑥ AI에게 "영향 경로를 나열하라"고 시키십시오
"안전합니까?"라고 물으면 "안전합니다"가 옵니다. "영향이 갈 수 있는 경로를 전부 나열하고 각각 왜 안전한지 설명하라" 고 하면 구멍을 스스로 찾습니다.
⑦ 스키마 코멘트에 원칙을 박아두십시오
COMMENT ON SCHEMA는 다음 세션의 AI가 읽습니다. 프로젝트 문서는 안 읽어도 DB 메타데이터는 읽습니다.
4-5. 시행착오
① 첫 설계에는 FK가 들어 있었습니다
당연하다는 듯이 REFERENCES profiles(id)가 붙어 있었습니다. 3-2의 2번 조항을 프롬프트에 넣기 전 이야기입니다. "기본값"이 곧 위험이라는 걸 이때 알았습니다.
다만 사이드카 내부 FK는 남겼습니다. growth_result.card_id → backlog_card.card_id는 어차피 같이 죽어도 되는 관계라 무결성을 지키는 게 낫습니다. 경계는 바깥에만 긋습니다.
② ALTER TABLE IF EXISTS를 뒤늦게 발견했습니다
tongbyun_quality에 컬럼을 추가하는데, 테이블이 있을 수도 없을 수도 있었습니다. 처음엔 조건 분기 스크립트를 짰다가 ALTER TABLE IF EXISTS ... ADD COLUMN IF NOT EXISTS로 정리했습니다. DDL을 여러 번 돌려도 안전한 형태(멱등)로 만드는 게 중요합니다.
③ 스키마 이름과 프로젝트 용어가 충돌했습니다
스키마 이름을 hermes로 지었는데, 강의 자료에 동명의 외부 에이전트 런타임이 등장했습니다. 문서에서 "Hermes"가 둘을 가리키게 됐습니다. 표기 규칙을 따로 정해야 했습니다.
→ 영문 Hermes 런타임은 외부 도구, 한글 헤르메스는 자체 에이전트. 사소해 보이지만 안 정해두면 외부 독자가 "이 프로젝트가 그 런타임을 쓴다"고 오해합니다.
④ Cron 무출력 문제를 늦게 알아챘습니다
야간 배치가 아무것도 출력하지 않았을 때, "개선 후보가 없었다"와 "경로를 못 읽었다"가 구분되지 않았습니다. 둘 다 조용합니다. 메시지를 분리하도록 고쳤습니다. 조용한 실패가 가장 오래 갑니다.
4-6. 도움이 필요한 부분
① 사이드카가 비대해질 때 — 지금은 테이블 4개라 깔끔한데, 여기에 계속 기능이 붙으면 결국 두 번째 본체가 됩니다. 사이드카를 언제 본체로 승격시키거나 분할해야 하는지 기준을 어떻게 잡아야 할지 조언 구합니다.
② FK 없는 로그 테이블의 고아 레코드 정리 — profile_id가 가리키던 대상이 사라져도 로그는 남습니다. 감사 추적 관점에서는 남는 게 맞는데, 몇 년 쌓이면 쓸모없는 행이 늘어납니다. 보존과 정리의 균형점을 잡아보신 분의 경험을 듣고 싶습니다.
③ 권한 3단 계약의 경계 — 3-9의 "승인형" 항목이 늘어나면 사람이 병목이 됩니다. 지금은 주 5건 상한을 뒀는데, 어떤 종류의 판단을 즉시형으로 내려도 되는지 다른 분들의 선은 어디인지 궁금합니다.
5. 앞으로의 계획
5-1. 즉시 — 서버 반영 19단계
체크리스트는 이미 만들어뒀습니다. 순서가 곧 안전장치입니다.
=== 업로드 ===
□ 1. scp hermes_growth_loop_DDL_v1_0.sql root@서버:/tmp/

=== 접속 ===
□ 2. sudo -u postgres psql -d hanbadook_production
      ★ current_database() 확인. dummy면 즉시 중단

=== 사전 검증 ===
□ 3. gwanbeop_ppt COUNT  → 기준값 ⟨____⟩
□ 4. profiles COUNT      → 기준값 ⟨____⟩
□ 5. hermes 스키마 기존 객체 확인
□ 6. pg_dump 백업

=== 실행 ===
□ 7. \i /tmp/hermes_growth_loop_DDL_v1_0.sql

=== 사후 검증 ===
□ 8~9.  테이블 4개 · 뷰 2개 생성 확인
□ 10~11. ★ COUNT 대조 — 3·4번과 일치해야 함

=== 코드 배포 ===
□ 14~16. N6 게이트 교체 · N7 노드 배치 · 골든셋 회귀

=== Cron ===
□ 17~18. 03:00 KST 등록 · 수동 1회 실행
         → "후보 없음" vs "못 읽음" 메시지 분기 확인

=== 백업 ===
□ 19. 사후 pg_dump
5-2. 실행 후 — 실제 결과 공유
지금 이 글은 설계 기록입니다. 반영 후에는 실측치를 공유하겠습니다.
사전/사후 COUNT 실제 숫자와 일치 여부
run_log첫 100건의cite_ratio분포첫 주
backlog_card생성 건수와 중복 접기율실패 사례 — 설계대로 안 된 부분이 반드시 나올 것입니다
5-3. 검증할 가설
이번 설계가 진짜 유효한지는 다음 질문으로 판정됩니다.
다음번 기능 추가 때도 기존 테이블 ALTER 0건을 유지할 수 있는가?
한 번 지키는 건 어렵지 않습니다. 여섯 번 부순 패턴을 막았다고 말하려면 최소 여섯 번의 기능 추가를 통과해야 합니다. 다음 대상은 Rails SSE 스트리밍 파이프라인입니다. 그때 또 ALTER TABLE이 필요해지면, 이 원칙은 재설계가 필요합니다.
5-4. 확장 — 반성문의 기계화
앞선 사례글에서 손으로 쓰던 반성문 34건이 있습니다. backlog_card의 6요소 NOT NULL이 사실 그 반성문 서식을 DB 제약으로 옮긴 것입니다.
run_log가 돌기 시작하면 매 실행마다 한 줄씩 자동으로 쌓입니다. 사람이 실수를 알아채고 반성문을 쓰는 게 아니라, 시스템이 먼저 알아채는 구조로 넘어갑니다.
도움 받은 글 (옵션)
지피터스 23기 에이전트 하네스 4주차 — Growth Loop — Log→Backlog→Review→Patch→Verify→Repeat 6칸 구조와 "검증 영수증" 개념. 이 DDL의 테이블 4개가 그 6칸에 하나씩 대응합니다. 특히 "카드에 되돌림 방법을 반드시 적는다"는 지적이
rollback_method NOT NULL이 된 직접적 계기입니다.Autoresearch 실험 기록 방식(results.tsv) —
growth_result테이블의 원형. 나빠진 실험도 지우지 않는다, 한 번에 한 가지만 바꾼다, 지표 방향을 명시한다 세 가지를 그대로 가져왔습니다.Sidecar 패턴 (Kubernetes) — 본체 컨테이너 옆에 관측·로깅 컨테이너를 붙이되 본체 코드는 건드리지 않는 구조. 이름과 발상을 여기서 빌렸습니다.
PostgreSQL 공식 문서 —
GENERATED ALWAYS AS ... STORED, 부분 인덱스(WHERE절 포함),ALTER TABLE IF EXISTS.앞선 사례글 「AI 협업 반성문 34건」 — 이 글의 출발점입니다. 그 집계에서 패턴 4가 6회로 1위였다는 사실이 없었다면, 사이드카까지 갈 이유가 없었습니다.
