


소개
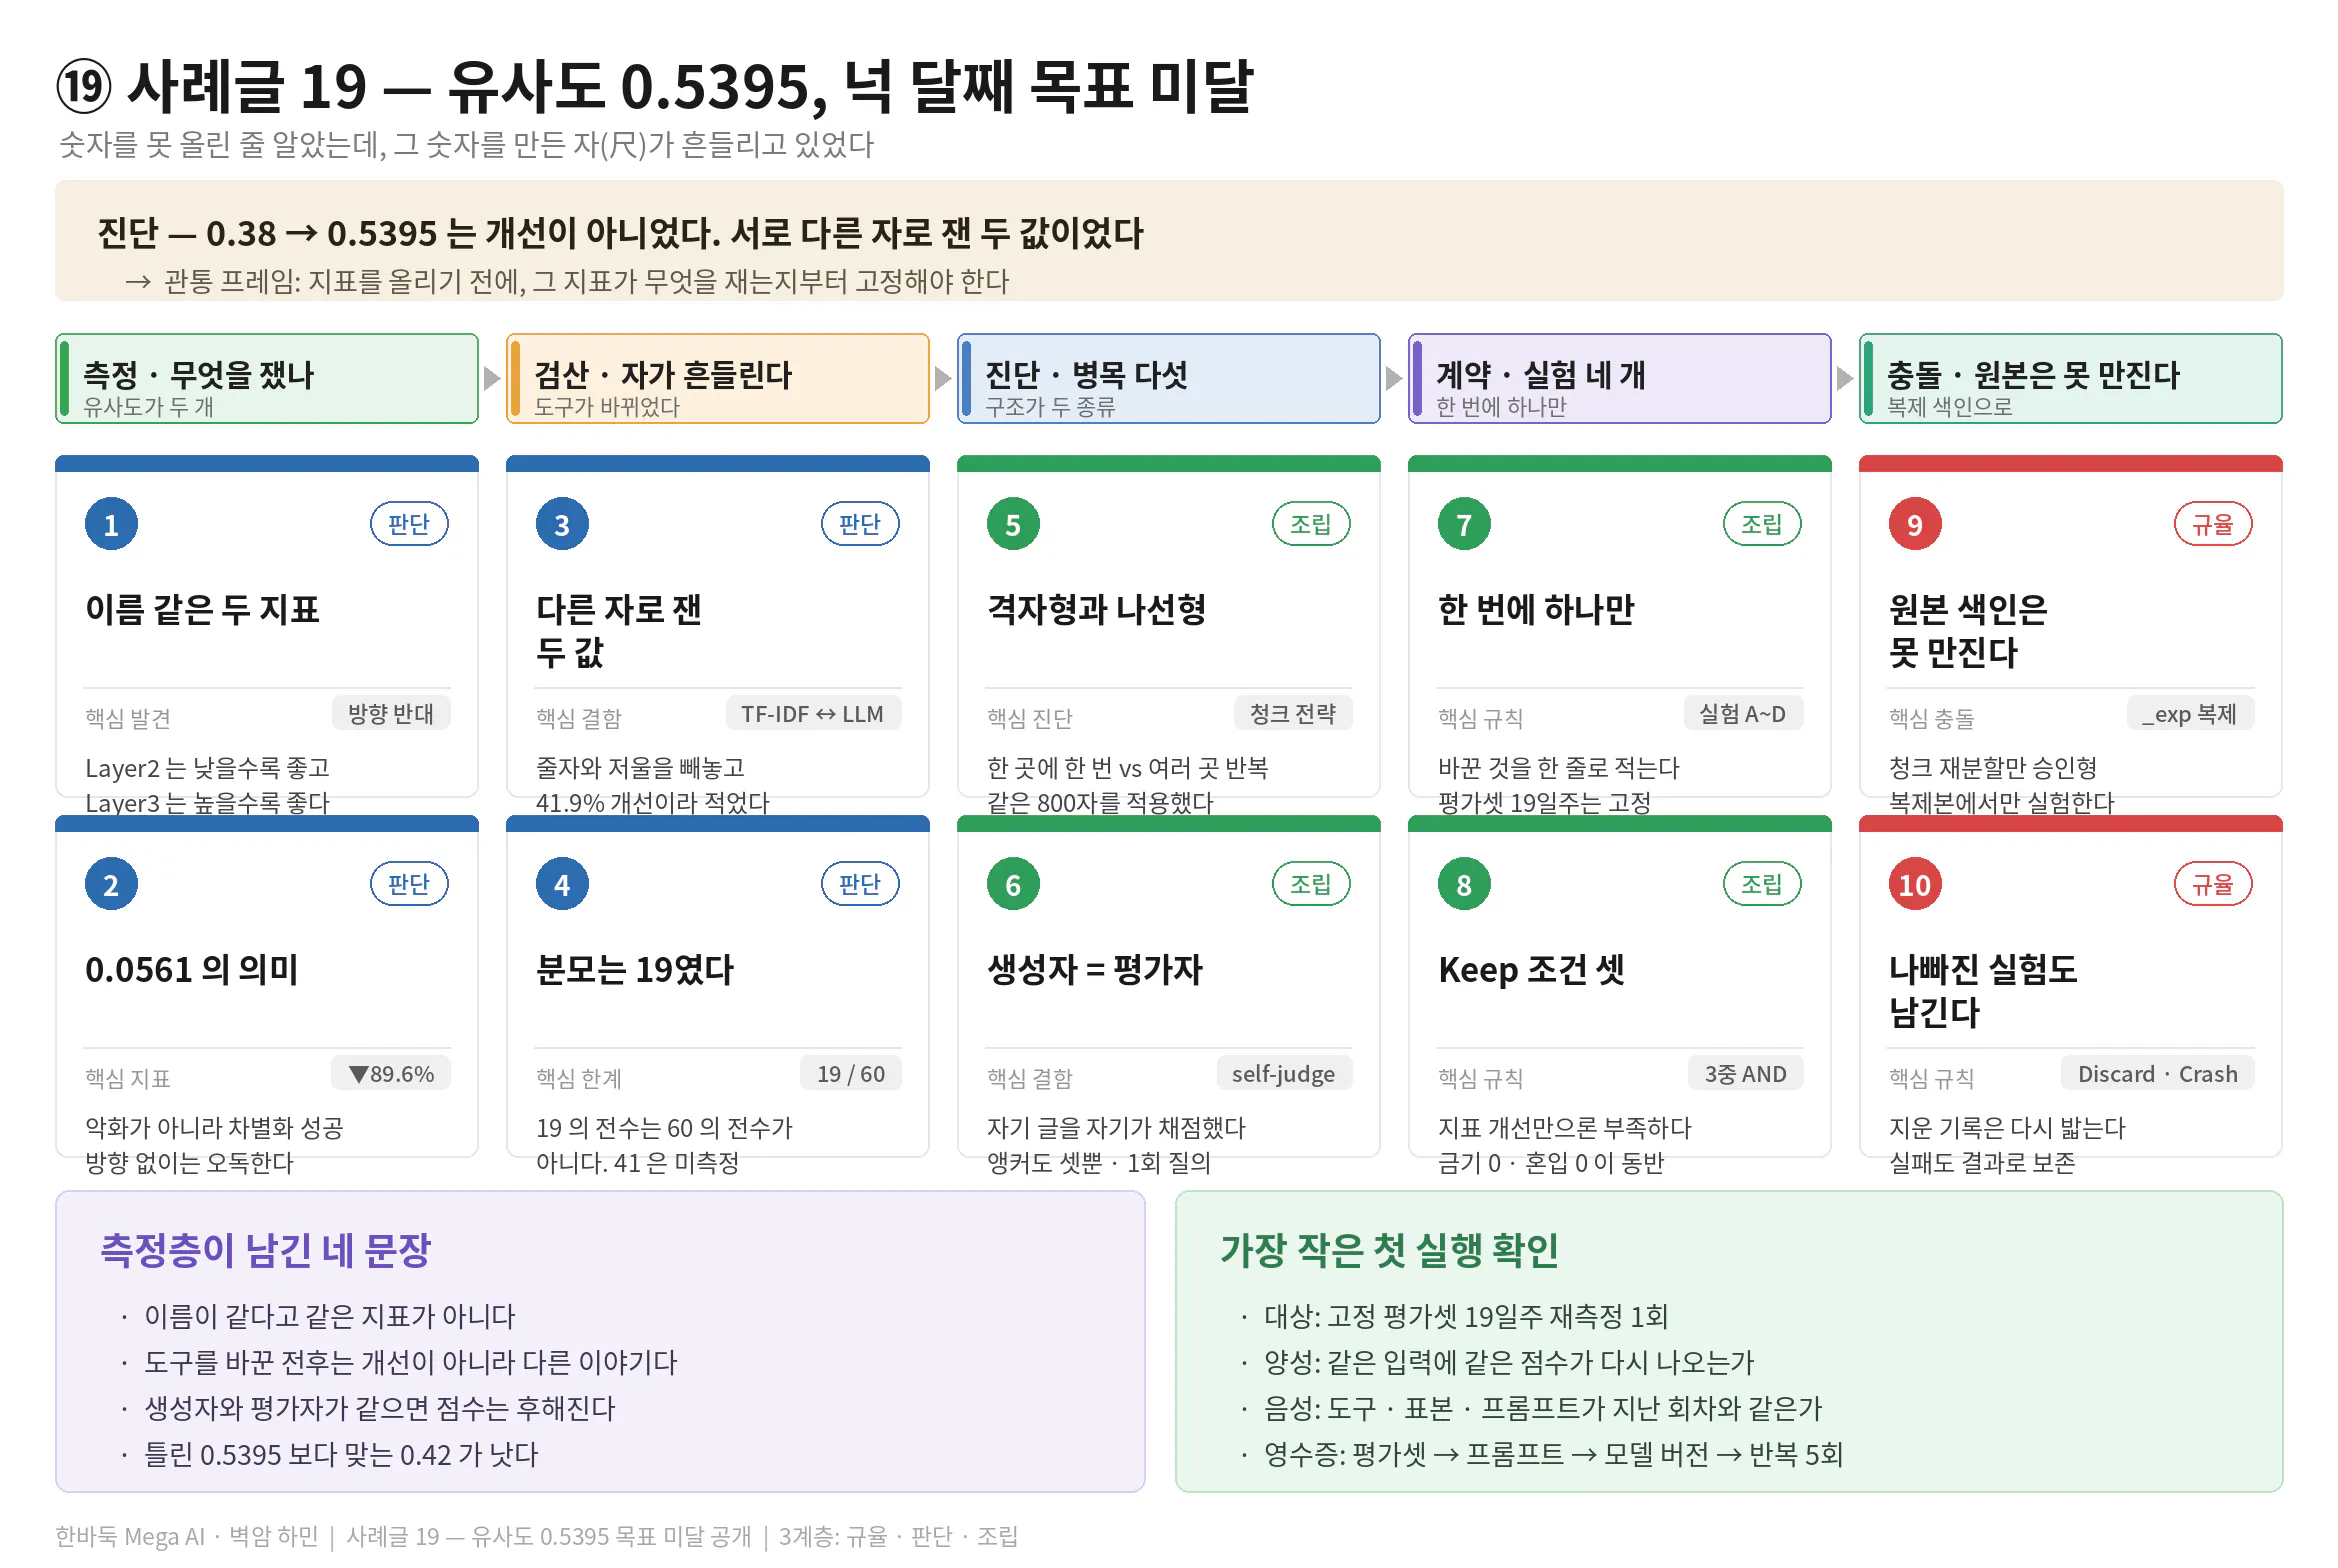
0.80이라는 숫자를 목표로 걸었습니다
제가 만드는 명리학 AI는 RAG로 강의 자료를 검색해 답변합니다. 검색이 제대로 되는지를 재는 지표로 의미 유사도를 쓰고 있고, 목표를 0.80으로 잡았습니다.
2026년 4월에 0.5395를 찍었습니다. 그리고 지금 8월입니다. 넉 달째 같은 자리입니다.
왜 이 숫자에 매달리나
단순한 검색 정확도 문제가 아니어서입니다.
제 시스템이 다루는 강의는 수년에 걸쳐 나선형으로 반복 심화됩니다. 같은 "충형파해"라는 개념이 冬편에서는 부동산 맥락으로, 夏편에서는 직업 전환 맥락으로, 秋편에서는 대운 이동 맥락으로 각각 다르게 적용됩니다.
인간 학습자는 148강을 다 들어도 이 세 맥락을 동시에 떠올리지 못합니다. 새 정보가 들어오면 낡은 정보를 밀어내는 게 인간 인지의 한계입니다.
AI는 잊지 않습니다. 그게 이 작업의 목적입니다.
그래서 유사도 0.80은 기술 목표가 아니라, "강사가 수년간 흩뿌린 맥락을 사용자의 한 줄 질문에서 정확히 찾아내 재현할 수 있는가" 의 정량 표현입니다.
그런데 이 글을 쓰다가 더 곤란한 걸 발견했습니다
"넉 달째 못 올렸다"는 이야기를 쓰려고 원자료를 다시 검산했습니다. 그러다 알았습니다.
0.38에서 0.5395로 올랐다는 그 개선치가, 서로 다른 자로 잰 값이었습니다.
0.38은 TF-IDF로, 0.5395는 LLM에게 물어서 얻은 값입니다. 도구가 다릅니다. 줄자로 잰 값과 저울로 잰 값을 비교해놓고 "41.9% 개선"이라고 적어둔 셈입니다.
그래서 이 글은 원래 "목표 미달 공개"로 기획했다가, 쓰는 도중에 "지표 자체를 신뢰할 수 없다는 공개" 로 바뀌었습니다. 더 부끄럽지만 더 쓸모 있는 이야기라고 생각합니다.
진행 방법
3-1. 측정 구조 — 유사도가 두 개입니다
먼저 이걸 정리해야 뒤 이야기가 통합니다. 제 시스템에는 "유사도"라는 이름의 지표가 둘 있고, 좋은 방향이 서로 반대입니다.
Layer 2
Layer 3
무엇을 재나
생성된 통변 60종이 서로 얼마나 다른가
검색 결과가 기준 통변과 얼마나 맞는가
대상
dummy DB 내부 60×60 교차
dummy ↔ production 교차
좋은 방향
낮을수록 좋음 ↓
높을수록 좋음 ↑
목표 0.80
해당 없음
이쪽
Layer 2가 높다는 건 60갑자 통변이 서로 구별이 안 된다는 뜻이니 나쁩니다. Layer 3가 높다는 건 검색이 정확하다는 뜻이니 좋습니다.
이름이 같고 방향이 반대인 지표를 두 개 쓰고 있었습니다.
3-2. Layer 2 — 천간이 통째로 빠져 있었습니다
첫 측정에서 이상한 게 나왔습니다.
그룹
지지
명리 명칭
일주 수
고유 텍스트
A
子·午·卯·酉
사정지(四正地)
20개
1종
B
辰·戌·丑·未
사고지(四庫地)
20개
1종
C
寅·申·巳·亥
사생지(四生地)
20개
1종
60갑자인데 통변이 3종뿐이었습니다.
데이터를 만든 AI가 지지(地支)만 보고 천간(天干)을 무시한 겁니다. 갑자(甲子)와 경오(庚午)의 통변이 글자 하나 안 틀리고 같았습니다. 같은 그룹 내 유사도가 1.0000이었습니다.
명리에서 천간을 빼면 절반이 사라집니다. 갑목(甲木)과 경금(庚金)은 성질이 정반대인데 같은 설명이 붙어 있었습니다.
60갑자를 개별 재생성했습니다.
python
# gen_60gabjja_tongbyun.py
# 모델: claude-opus-4-5-20251101, temperature=0
# 전략: 천간 특성 사전(10개) + 지지 특성 사전(12개) 결합
# 금기어 검증: 격국·용신·기신·희신 자동 차단
# 결과: 60종 성공 / 0종 실패
결과입니다.
항목
이전(3그룹)
이후(60갑자)
변화
고유 텍스트
3종
60종
+57종
전체 평균 유사도
0.5418
0.0561
▼89.6%
가장 유사한 쌍
갑자↔경오 1.0000
경진↔임진 0.2199
대폭 차별화
0.5418 → 0.0561은 89.6% 하락이지만 성공입니다. Layer 2는 낮을수록 좋으니까요.
이 표를 지표 방향을 모르는 사람이 보면 "성능이 90% 망가졌다"로 읽습니다. 실제로 작업 도중에 제가 한 번 그렇게 읽었습니다.
3-3. Layer 3 — 측정 도구를 바꿔야 했습니다
여기서 문제가 생겼습니다.
3그룹 시절에는 TF-IDF로 쟀고 0.38이 나왔습니다. 그런데 60갑자로 재생성한 뒤 같은 TF-IDF로 재니 0.0075가 나왔습니다. 사실상 0입니다.
원인은 명확합니다. dummy 통변은 문학적 문체("한겨울 깊은 밤, 얼어붙은 대지 아래…")고, production 통변은 실무 문체입니다. 단어가 안 겹치니 TF-IDF가 0으로 수렴합니다. 의미는 같은데 어휘가 달라서 측정 자체가 불가능해졌습니다.
그래서 LLM에게 직접 물어보는 방식으로 바꿨습니다.
python
prompt = f"""다음 두 명리학 통변이 같은 일주({ilju})를 설명하는지
의미적 유사도를 0.0~1.0 숫자 하나만 출력하세요.
(1.0=완전동일, 0.5=같은개념다른표현, 0.0=전혀무관)
"""
결과입니다.
항목
이전(3그룹, TF-IDF)
이후(60갑자, LLM)
기록된 변화
평균 유사도
0.38
0.5395
+41.9% ↑
≥0.5 달성률
1.1%
68.4% (13/19)
+67.3%p ↑
≥0.3 달성률
—
100.0% (19/19)
전수 달성
이 표가 문제의 표입니다. 4-2에서 다루겠습니다.
3-4. 병목 진단 다섯 가지
0.5395에서 왜 안 올라가는지를 진단했습니다.
병목
원인
영향
나선형 반복의 키워드 중복
같은 주제가 여러 source에 분산
검색 결과 분산, 최적 섹션 미선별
강의 시점 정보 부재
시기 필드가 없음
같은 주제의 신·구 버전 구분 불가
맥락 분기 태그 부재
"충형파해"의 부동산/직업/대운 맥락 미구분
사용자 의도와 섹션 맥락 불일치
청크 크기 일률 적용
전 자료에 800자/150자 overlap 고정
구조가 다른 자료에 같은 전략
교차 참조 정보 없음
시리즈 간 연결 고리 미기록
"관련 섹션" 재현 불가
세 번째와 네 번째가 핵심인데, 여기에 이번 작업 최대의 인사이트가 걸려 있습니다.
3-5. 자료 구조가 두 가지였습니다 — 격자형과 나선형
강의 자료를 처리하다 보니 성격이 완전히 다른 두 종류가 있었습니다.
격자형 — 하나의 축을 끝까지 팝니다. 갑일간 × 12지지 = 36조합, 정·무·기·경·신 5일간 × 12지지 = 60조합을 하나도 빠짐없이 순회합니다. "병일간이 자수를 만났을 때"는 전 시리즈에서 딱 한 곳에만 있습니다. 검색이 명확합니다.
나선형 — 모든 방향으로 뻗어나갑니다. 141강 인덕 주기론 → 142강 조상 제사론 → 143강 주거 개운법 → 145강 신살 방향론… 8강에 주제가 7~8개입니다. 같은 개념이 여러 강에 다른 맥락으로 반복 등장합니다.
강의로서는 나선형이 탁월한 교수법입니다. 반복 학습 효과가 누적되니까요. 그런데 RAG에서는 그 반복이 점수를 분산시킵니다.
"충형파해 → 부동산"이 冬편에도 있고 夏편에도 비슷한 게 있고 운의해석에도 있으면, 검색 엔진이 어느 게 최적인지 판별하지 못합니다.
여기에 800자 고정 청크를 똑같이 적용하고 있었습니다.
구조 유형
적합한 청크 전략
해당 자료
격자형
현행 유지 (800자 / 150자 overlap)
제트엔진, 정진반
나선형
주제 전환점 기반 + 맥락태그
옴니버스, 춘하추동, 운의해석
요약형
전체 섹션 + 키워드 밀집
청화비전
3-6. 실험 계약 — 한 번에 하나만 바꿉니다
개선안 넷을 실험으로 묶되, 규칙을 먼저 고정했습니다.
실험
바꾸는 것 한 가지
사이드카 충돌
권한 등급
A
청크 800자 → 500 / 1,200자
있음 — 원본 재분할
승인형
B
나선형 문서에 맥락태그 부여
없음 — 별도 테이블
즉시형
C
쿼리 템플릿 3종 비교
없음
즉시형
D
강의 시점 우선순위 랭킹
없음 — 메타 테이블
즉시형
고정(변경 금지)
평가셋: 19일주 골든 쿼리 + 주제별 20쿼리
재색인 1회, 실험당 시간 상한
지표: 평균 코사인 유사도 —
direction = higher_is_better
Keep 조건 — 셋 다 만족해야 합니다
sql
CONSTRAINT keep_gate CHECK (
  status <> 'Keep' OR (guard_violation = 0 AND lineage_mix = 0)
)
지표가 올라가도 금기 표현 위반이 1건이라도 있거나 계통 혼입이 1건이라도 있으면 Keep으로 기록할 수 없습니다. 유사도만 쫓다가 답변 품질을 망가뜨리는 경로를 DB 제약으로 막았습니다.
그리고 나빠진 실험도 지우지 않습니다. Discard와 Crash까지 전부 남깁니다. 지운 기록은 반드시 다시 밟게 됩니다.
3-7. A 실험이 원칙과 충돌했습니다
실험 A(청크 재분할)에 문제가 하나 있습니다.
제 프로젝트에는 사이드카 원칙 — 기존 파이프라인을 건드리지 않는다 — 이 있습니다. 그런데 청크 재분할은 원본 색인을 다시 만드는 작업입니다. 정면 충돌입니다.
해법을 이렇게 잡았습니다.
운영 색인          무변경 유지
       │
       └──▶ 복제 색인 `_exp` 생성 → 여기서만 실험
                      │
                      └──▶ 지표 개선 확인 → 교수님 승인 → 승격
운영 색인은 손대지 않고 복제본에서만 실험합니다. 승인 후에만 승격합니다. 실험 A만 승인형인 이유가 이것입니다.
결과와 배운 점
4-1. 현재 위치 — 넉 달째 미달
[기준점]  천간 미반영 3그룹 :  0.38   / ≥0.5 달성률  1.1%
[현재]    천간 반영 60갑자   :  0.5395 / ≥0.5 달성률 68.4%   ← 여기서 정지
[목표]    Phase 2           :  0.80   / ≥0.5 달성률 90%↑
[최종]                       :  0.90   / ≥0.5 달성률 95%↑
측정일이 2026년 4월 13일이고 지금 8월입니다. 넉 달간 같은 숫자입니다.
진행 상태입니다.
항목
상태
병목 진단 5종
✅ 완료
실험 계약 A~D 설계
✅ 완료
growth_result 기록 테이블 DDL
✅ 작성
실험 A~D 실행
📋 대기
측정 프로토콜 재정의
📋 최우선
4-2. ⚠️ 가장 중요한 발견 — 개선치가 성립하지 않습니다
3-3의 표를 다시 보겠습니다.
항목
이전
이후
기록된 변화
평균 유사도
0.38 (TF-IDF)
0.5395 (LLM 평가)
+41.9% ↑
측정 도구가 다릅니다.
TF-IDF는 단어 겹침을 셉니다. LLM 평가는 의미를 판단합니다. 완전히 다른 것을 재는 두 자입니다. 이 둘을 빼서 "41.9% 개선"이라고 적은 건, 줄자로 잰 값과 저울로 잰 값을 뺀 것과 같습니다.
정확히 말하면 이렇습니다.
60갑자 재생성으로 통변 품질이 좋아진 것은 사실입니다(Layer 2가 증명합니다). 하지만 "0.38 → 0.5395"라는 개선 폭 자체는 성립하지 않습니다.
그리고 이 숫자를 저는 프로젝트 성과표에, 로드맵에, 여러 문서에 옮겨 적어왔습니다. 문서를 옮겨 적을수록 검산할 기회는 줄어듭니다.
실은 전략 문서 미해결 목록 6번에 이미 이렇게 적혀 있었습니다.
"유사도 0.5395 측정 프로토콜 — 재측정 후 목표 재조정"
알고는 있었는데 우선순위에서 계속 밀렸습니다. 지표를 의심하는 일보다 지표를 올리는 일이 더 재미있어서였다고 생각합니다.
4-3. 측정의 다른 결함 셋
검산하는 김에 전부 짚었습니다.
① 표본이 19일주뿐입니다
68.4% (13/19)의 분모가 19입니다. 60갑자 중 dummy와 production 양쪽에 다 있는 일주만 쟀습니다. 나머지 41개는 미측정입니다. 그런데 문서에는 "≥0.3 달성률 100.0% (19/19) — 전수 달성 ✅"이라고 적혀 있습니다.
19개의 전수는 60개의 전수가 아닙니다.
② 생성자와 평가자가 같은 모델입니다
dummy 통변을 만든 것도 Claude Opus 4.5, 유사도를 채점한 것도 Claude입니다. 자기가 쓴 글을 자기가 채점했습니다. 점수가 후하게 나올 유인이 구조적으로 있습니다.
③ 평가 프롬프트가 허술합니다
의미적 유사도를 0.0~1.0 숫자 하나만 출력하세요.
(1.0=완전동일, 0.5=같은개념다른표현, 0.0=전혀무관)
앵커가 셋뿐입니다. 0.6과 0.7의 차이를 판정할 기준이 없습니다
1회 질의입니다. 반복 편차를 안 쟀습니다
모델 버전·온도 기록이 없습니다
실제 결과 분포가 0.35 / 0.4 / 0.5 / 0.6 / 0.7로 0.05~0.1 단위에 뭉쳐 있습니다. 앵커가 없으니 모델이 익숙한 눈금에 붙인 것으로 보입니다
④ 목표 0.80에 근거가 없습니다
이게 제일 뼈아픕니다. 왜 0.80인지 설명할 수 있는 문서가 없습니다. 0.75면 실패이고 0.81이면 성공이라는 판단의 근거가 없습니다.
근거 없는 목표는 달성도 실패도 판정할 수 없습니다. 넉 달간 "못 올렸다"고 자책했는데, 애초에 무엇을 못 올린 건지가 불분명했습니다.
4-4. 배운 것 ① — 지표 방향은 필드로 만들어야 합니다
3-1의 두 유사도 문제입니다. 이름이 같고 방향이 반대인 지표를 쓰다가, 실제로 0.0561을 보고 "성능 90% 하락"으로 오독한 적이 있습니다.
그래서 실험 기록 테이블에 아예 필드를 박았습니다.
sql
direction text NOT NULL DEFAULT 'higher_is_better'
          CHECK (direction IN ('higher_is_better','lower_is_better')),
NOT NULL입니다. 방향을 안 적으면 실험 기록 자체가 안 만들어집니다.
4-5. 배운 것 ② — 자료 구조를 먼저 분류해야 합니다
800자 청크를 전 자료에 똑같이 적용한 게 병목 중 하나였습니다. 격자형에는 맞고 나선형에는 안 맞는 전략이었습니다.
RAG를 "청크 크기 튜닝 문제"로 보고 있었는데, 사실은 "자료가 몇 종류인지 모르고 있던 문제" 였습니다. 튜닝 파라미터를 만지기 전에, 넣는 자료가 몇 가지 성격인지부터 나눠야 했습니다.
4-6. 배운 것 ③ — 나선형 반복은 약점이자 목적입니다
처음엔 나선형 구조가 RAG에 불리하다고만 생각했습니다. 그런데 뒤집어 보면 그 나선형이야말로 AI가 인간 대신 기억해야 할 부분입니다.
같은 개념이 冬편에서는 부동산, 夏편에서는 직업, 秋편에서는 대운 맥락으로 갈리는데 — 인간은 이 셋을 동시에 떠올리지 못하고, AI는 할 수 있어야 합니다. 아니, AI만 할 수 있습니다.
그러니 나선형을 격자형으로 눌러 담는 게 아니라, 맥락 태그로 분기를 보존한 채 검색되게 해야 합니다. 실험 B가 그 방향입니다.
4-7. 꿀팁 — 지표를 쓰시는 분께
① 지표 이름 옆에 방향을 항상 붙이십시오
avg_similarity 대신 avg_similarity(↑). 팀에 한 명이라도 방향을 모르면 사고가 납니다.
② 도구를 바꾸면 그 전후는 비교하지 마십시오
새 도구로 과거 데이터를 다시 재서 기준선을 새로 만드십시오. 그게 안 되면 "도구 변경"이라고 표시하고 개선치는 적지 않는 게 맞습니다.
③ 분모를 항상 같이 쓰십시오
68.4%가 아니라 68.4% (13/19). 저는 다행히 분모를 적어뒀는데, 적어놓고도 19가 60이 아니라는 걸 넉 달 뒤에 알았습니다.
④ 생성자와 평가자를 분리하십시오
같은 모델이면 최소한 그 사실을 문서에 적으십시오. 가능하면 다른 모델이나 사람이 평가하는 게 맞습니다.
⑤ LLM에게 점수를 매기게 할 때는 앵커를 촘촘히 주십시오
0/0.5/1 세 개로는 부족합니다. 0.2, 0.4, 0.6, 0.8 각각에 구체적 예시 문장을 붙이십시오. 그리고 같은 쌍을 5회 반복해 편차를 보십시오.
⑥ 목표 숫자에 근거를 적어두십시오
"0.80"만 적지 말고 "0.80 = 이 정도면 사용자가 재검색 없이 답을 얻는 수준"처럼 적으십시오. 근거 없는 목표는 넉 달을 갉아먹습니다.
⑦ 실패한 실험을 지우지 마십시오
Discard와 Crash도 기록으로 남겨야 같은 길을 두 번 안 갑니다.
4-8. 시행착오
① 0.0561을 악화로 읽었습니다
Layer 2 결과를 처음 보고 "성능이 90% 떨어졌다"고 판단했습니다. 방향을 확인하고서야 성공인 걸 알았습니다. 4-4의 direction 필드가 여기서 나왔습니다.
② TF-IDF를 끝까지 붙들려 했습니다
0.0075가 나왔을 때 처음엔 전처리를 고치려 했습니다. 불용어 조정, 형태소 분석기 교체… 도구가 이 문제에 안 맞는다는 결론에 도달하는 데 시간이 걸렸습니다. 문체가 완전히 다른 두 텍스트에 어휘 기반 지표를 쓰는 건 애초에 틀린 선택이었습니다.
③ 지표를 문서에 옮겨 적으며 굳혔습니다
0.5395가 프로젝트 보고서, 로드맵, 학습 문서 여러 곳에 적혔습니다. 여러 문서에 적힌 숫자는 검증된 숫자처럼 보입니다. 실제로는 한 번 잰 값을 복사한 것뿐인데요. 제 프로젝트에 「문서 ≠ 사실」이라는 원칙이 있는데, 이 숫자에는 적용하지 않았습니다.
④ 미해결 목록에 적어두고 4개월 미뤘습니다
"측정 프로토콜 재정의"가 미해결 6번에 있었습니다. 적어두는 것과 하는 것은 다릅니다. 우선순위에서 계속 밀린 이유는, 지표를 의심하는 작업에는 성과가 안 나오기 때문입니다.
4-9. 도움이 필요한 부분
① LLM-as-a-judge 신뢰도 — 문체가 크게 다른 두 텍스트의 의미 유사도를 재는 데 LLM 평가가 적절한지 확신이 없습니다. 앵커 예시를 몇 개까지 주는 게 적정한지, 반복 몇 회면 편차가 안정되는지 경험 있으신 분의 조언을 구합니다.
② 나선형 문서의 청크 전략 — 주제 전환점 기반 분할을 검토 중인데, 전환점을 자동 탐지하는 방법이 아직 없습니다. 임베딩 유사도가 급락하는 지점을 경계로 잡는 방식을 보긴 했는데, 강의록처럼 화제가 자연스럽게 흐르는 텍스트에서도 통할지 모르겠습니다.
③ 목표치 설정 근거 — 도메인 RAG에서 "이 정도면 실용 가능"의 임계값을 어떻게 정하시는지 궁금합니다. 사용자 재검색률 같은 행동 지표로 역산하는 게 맞을까요.
5. 앞으로의 계획
5-1. 최우선 — 실험보다 측정 프로토콜 재정의
실험 A~D를 돌리기 전에 자를 먼저 고쳐야 합니다. 흔들리는 자로 잰 개선은 개선인지 알 수 없습니다.
#
작업
1
기준선 재수립 — 3그룹 시절 데이터를 LLM 평가로 다시 측정. 같은 자로 잰 값끼리 비교
2
표본 확대 — 19일주 → 가능한 최대. 불가하면 "19일주 한정" 명시
3
평가 프롬프트 재작성 — 앵커 5단계 + 각 단계 예시 문장
4
반복 측정 — 동일 쌍 5회, 표준편차 기록
5
평가자 분리 — 생성 모델과 다른 모델로 채점
6
목표 0.80 근거 문서화 — 못 쓰면 목표치 재설정
6번을 못 쓰면 0.80을 폐기하는 게 맞다고 봅니다. 근거 없는 목표는 지표가 아니라 부담입니다.
5-2. 재측정 후 — 실험 B·C·D 먼저
즉시형 셋(맥락태그·쿼리템플릿·시점랭킹)을 먼저 돌립니다. 사이드카 충돌이 없어 되돌리기 쉽습니다.
실험 A(청크 재분할)는 복제 색인 _exp에서만 하고, 승인 후 승격합니다.
5-3. 다음 글에서 공유할 것
재수립한 기준선 실측치와 기존 0.5395와의 관계
반복 측정 표준편차 — 자가 얼마나 흔들리는지
실험 B·C·D의
Keep/Discard/Crash판정실패한 실험 내역 — 이게 제일 쓸모 있을 겁니다
5-4. 각오
기준선을 다시 세우면 0.5395보다 낮은 숫자가 나올 가능성이 높다고 봅니다. 지금 값은 자기가 쓴 글을 자기가 후하게 채점한 값이니까요.
숫자가 내려가면 넉 달간의 정체가 아니라 애초에 그만큼 못 갔던 것이 됩니다. 그래도 내려간 숫자가 맞는 숫자입니다.
틀린 0.5395보다 맞는 0.42가 낫습니다.
도움 받은 글 (옵션)
지피터스 23기 에이전트 하네스 4주차 — Growth Loop / Autoresearch — 한 번에 한 가지만 바꾼다, 평가셋을 고정한다, 나빠진 실험도 지우지 않는다, 지표 방향을 명시한다 네 가지가 3-6 실험 계약의 뼈대입니다. 특히 지표 방향 필드가 없으면 개선을 악화로 오독한다는 지적이, 제가 실제로 저지른 실수(4-8 ①)와 정확히 겹쳤습니다.
TF-IDF의 어휘 의존성 — 문체가 다르면 의미가 같아도 0으로 수렴한다는 기초 사실. 알고 있었는데 제 데이터에 적용해보고서야 실감했습니다.
LLM-as-a-judge 관련 논의 — 자기 출력을 자기가 평가할 때의 편향(self-preference bias). 4-3 ②의 근거입니다.
앞선 사례글 「금지어 4개에서 문맥 판정으로」 — 그 글의 "위반 0건은 성능이 아니었다"와 이 글의 "0.5395는 비교 가능한 값이 아니었다"는 같은 종류의 실수입니다. 숫자에 이름을 붙이고 나면 그 숫자가 무엇인지 다시 묻지 않게 됩니다.
앞선 사례글 「AI 협업 반성문 34건」 — 「문서 ≠ 사실」 원칙의 출처. 정작 이 숫자에는 적용하지 않았습니다.
