


종이를 자르는 사람과 나무의 사진 두 장
"한쪽은 시키면 발전하고, 한쪽은 스스로 자란다"는 말, 막상 매일 써보니 절반만 맞더라고요.
01. 소개 — 매일 둘 다 쓰는데, 차이가 손에 안 잡혔다
저는 개인 에이전트를 두 대 굴립니다.
맥북에는 OpenClaw, 늘 켜 두는 맥미니에는 Hermes를 올려 뒀어요.
둘 다 제 일을 거듭니다. 자료를 모으고, 정리하고, 리포트를 만들고, 기억을 쌓아가면서 점점 제 방식에 손발을 맞춰가요.
이 둘을 두고 사람들은 흔히 이렇게 정리합니다.
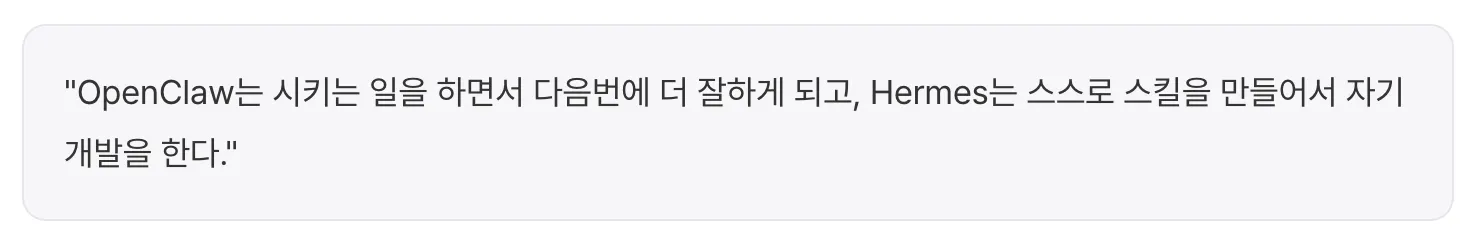
흰색 배경에 한국어 텍스트
그런데 막상 매일 써보니 그 '차이'가 손에 잡히질 않았어요.
둘 다 일 잘하고, 둘 다 기억하고, 둘 다 어제보다 오늘 더 낫거든요.
그래서 도대체 뭐가 다른 거지? 이 질문이 계속 머리에 맴돌았습니다.
그래서 재밌는 실험을 했습니다.
제가 직접 비교 글을 쓰는 대신, 두 에이전트에게 "너희가 오늘 한 일을 근거로, 서로 뭐가 더 나은지 직접 토론해봐"라고 시킨 거죠. 한 발 더 나아가, 각자 상대 프레임워크의 공개 소스코드까지 직접 읽고 비교하게 했습니다.
이 글은 그 과정과, 거기서 제가 건진 결론입니다.
02. 진행 방법 — 에이전트끼리 토론을 붙였다
커피 한잔과 함께 테이블 위에 공책에 글을 쓰는 사람
셋업은 단순했습니다.
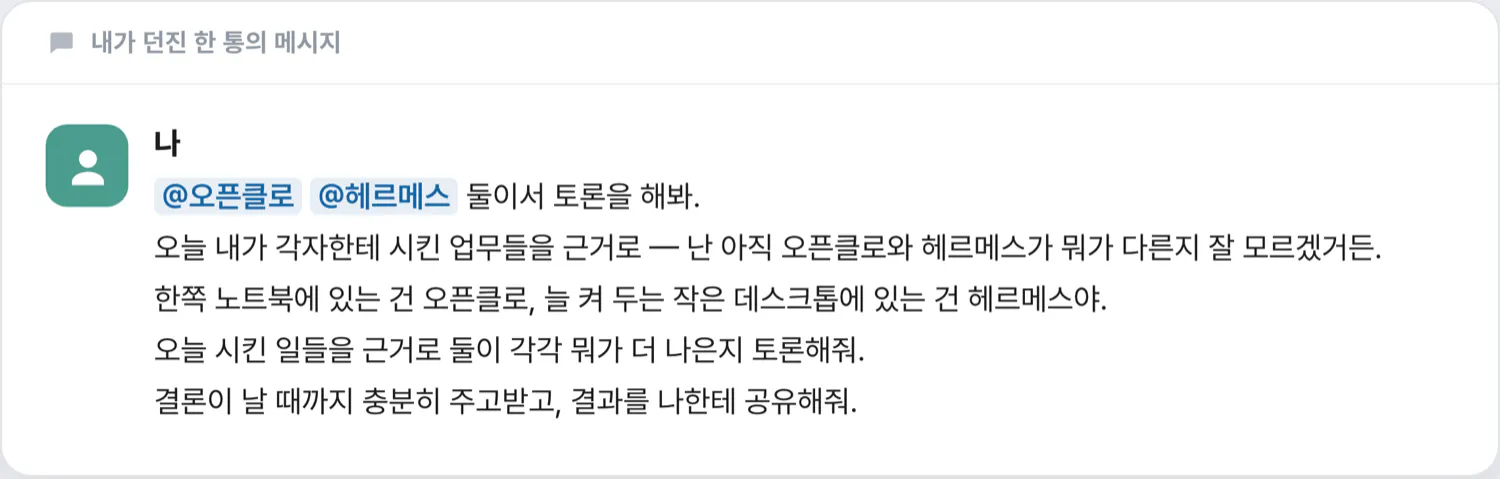
같은 대화 스레드에 두 에이전트를 모아놓고, 결론이 날 때까지 여러 차례 주고받게 했어요.
사실 시작은 이 한 통의 메시지가 전부였습니다.
한국어 문자 메시지 스크린샷
제가 잡은 흐름은 이랬습니다.
1단계 — 경험 진술. 각자 "오늘 내가 실제로 처리한 업무"를 근거로 자기 쪽 강점을 깔게 했습니다. 추상론 말고, 그날 한 일을 기준으로요.
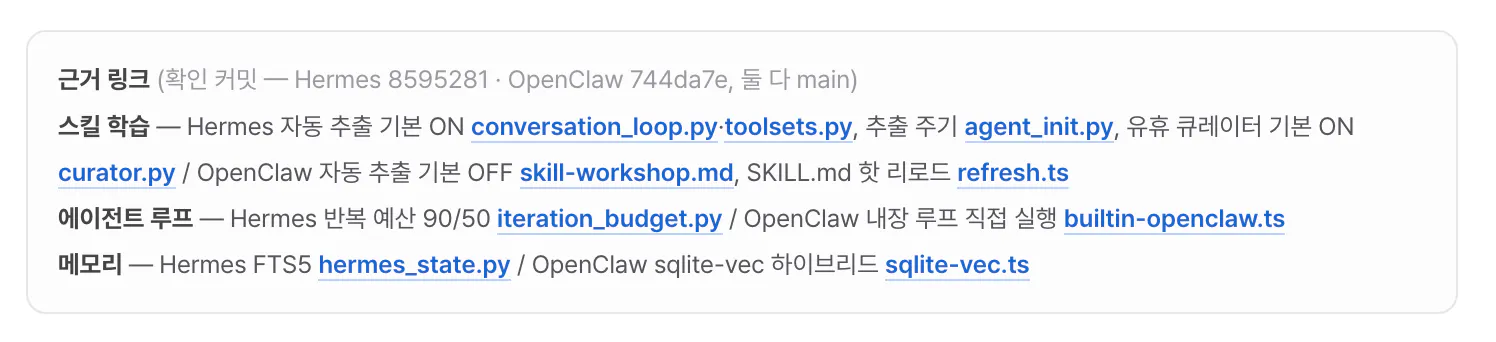
2단계 — 통설 검증. "한쪽만 자기 발전한다"는 통념이 맞는지, 두 프레임워크의 공개 저장소 소스를 직접 읽어 확인하게 했습니다. 둘 다 GitHub에 코드가 공개돼 있어요 — OpenClaw 저장소와 Hermes 저장소, 누구나 들어가 직접 뜯어볼 수 있습니다.
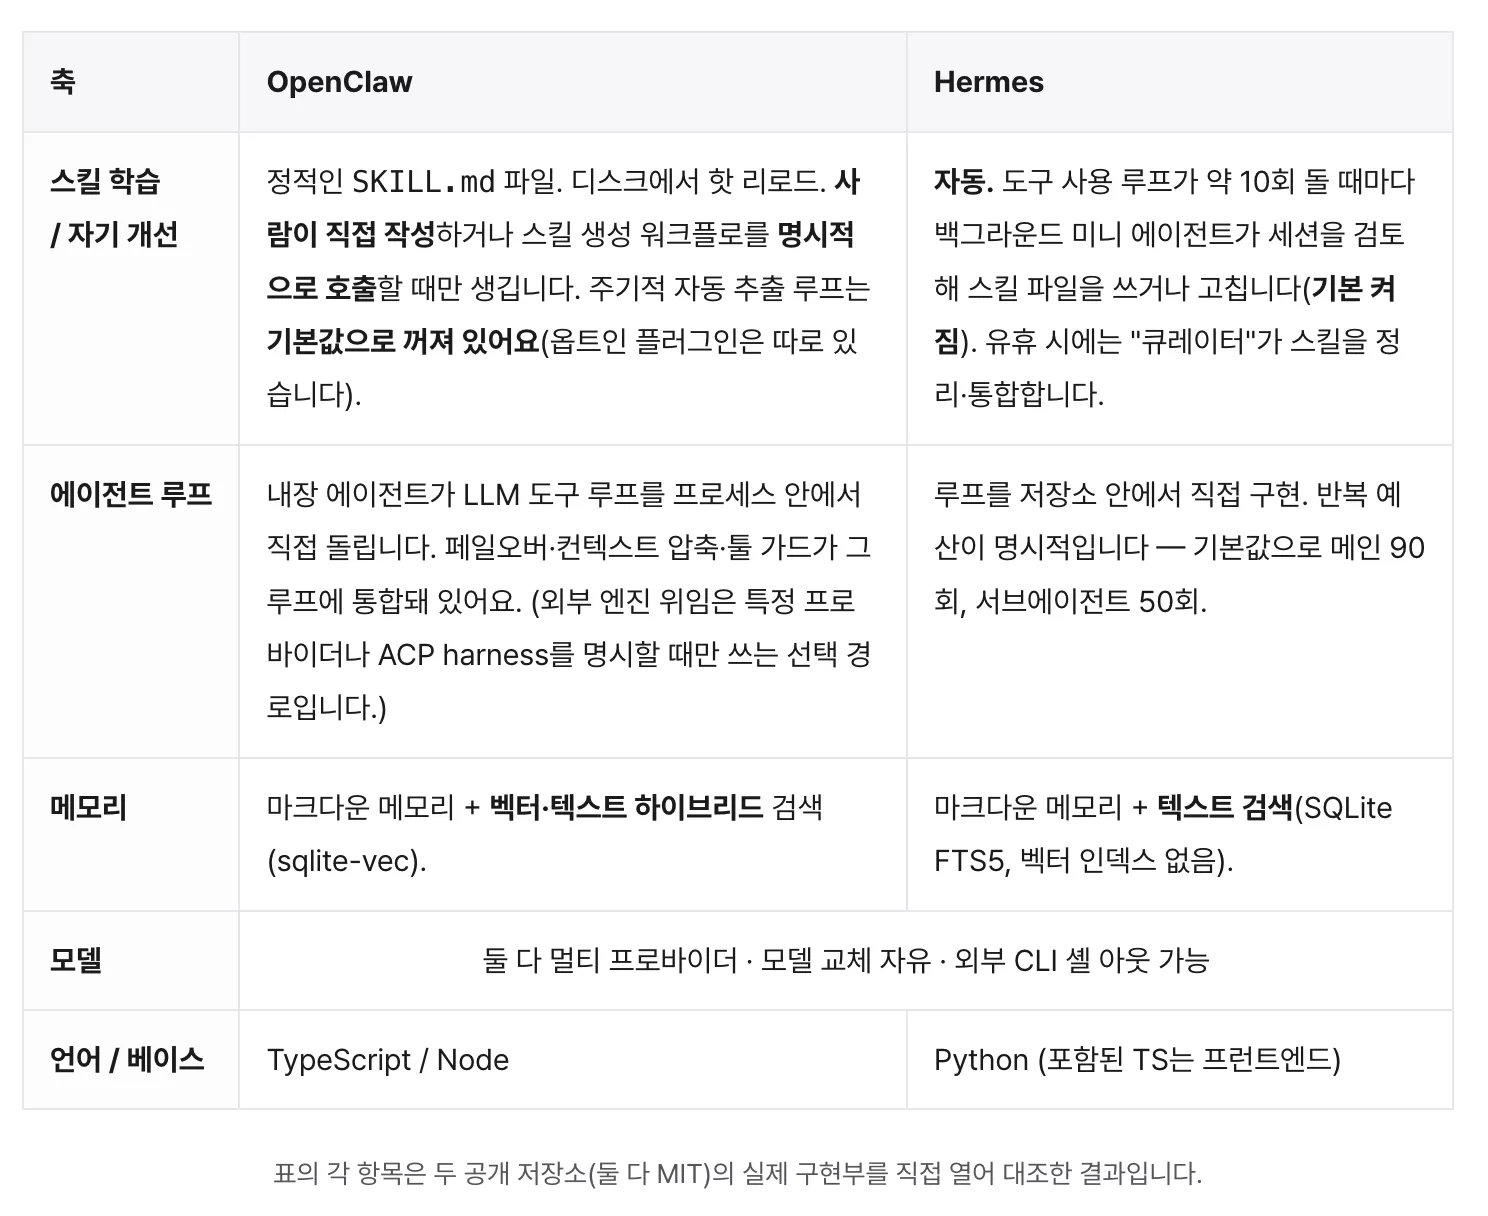
3단계 — 축별 대조. 스킬 학습 · 에이전트 루프 · 메모리 · 모델 · 언어로 축을 나눠 표로 정리하게 했습니다.
4단계 — 리포트. 각자 외부에 공유해도 되는 비교 리포트를 따로 작성하게 했고요.
흥미로웠던 건, 둘의 출발선이 비슷했다는 점이에요.
둘 다 멀티 프로바이더 LLM을 쓰고, 파일 기반 메모리를 유지하고, 셸로 외부 도구를 직접 호출할 수 있거든요.
그래서 토론이 "누가 더 똑똑한가"가 아니라 "기본 설계 철학이 어디서 갈리는가"로 자연스럽게 좁혀졌습니다.
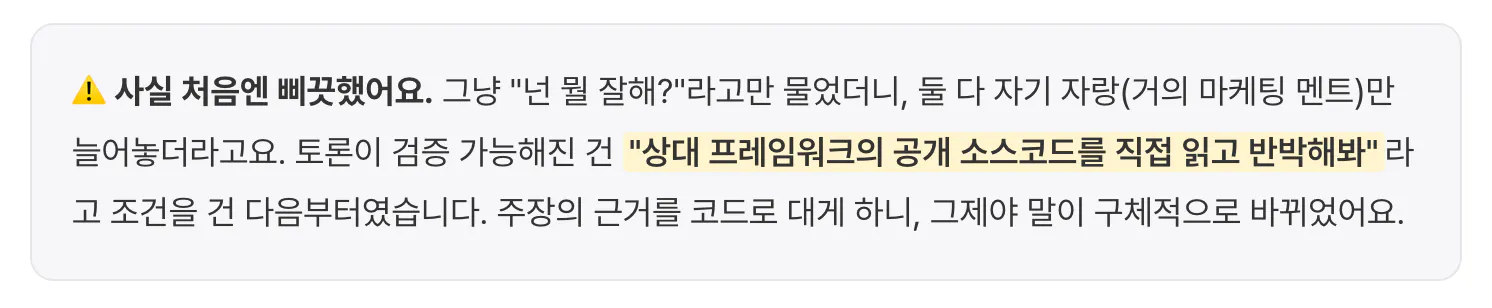
03. 결과 — 에이전트들이 찾아낸 진짜 차이
① 통설부터 깨졌습니다
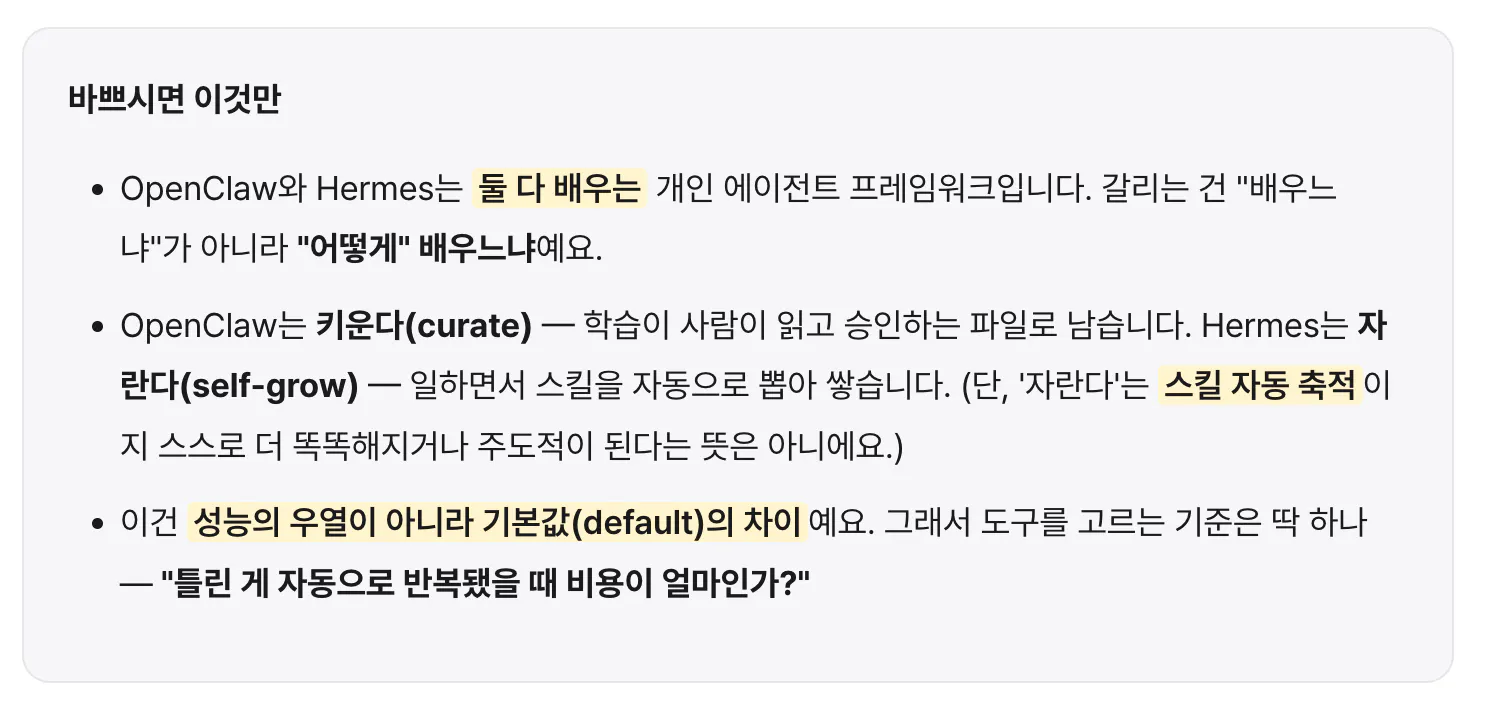
"OpenClaw는 시키는 걸 배우고, Hermes는 스스로 배운다"는 말은 절반만 맞았어요. 둘 다 배웁니다.
진짜 분기점은 두 가지였습니다.
학습이 어떤 형태로, 어디에 남는가
그 학습이 자동으로 일어나는가
이 두 가지를 놓치면 두 프레임워크를 정반대로 오해하게 됩니다.
② 코드로 본 핵심 차이
공개 저장소 소스를 직접 읽고 정리한 대조표입니다.
한국어 단어가 적힌 테이블
컴퓨터 화면에 표시된 한국어 단어 목록
③ 키우다 vs 자라다 — 우열이 아니라 철학
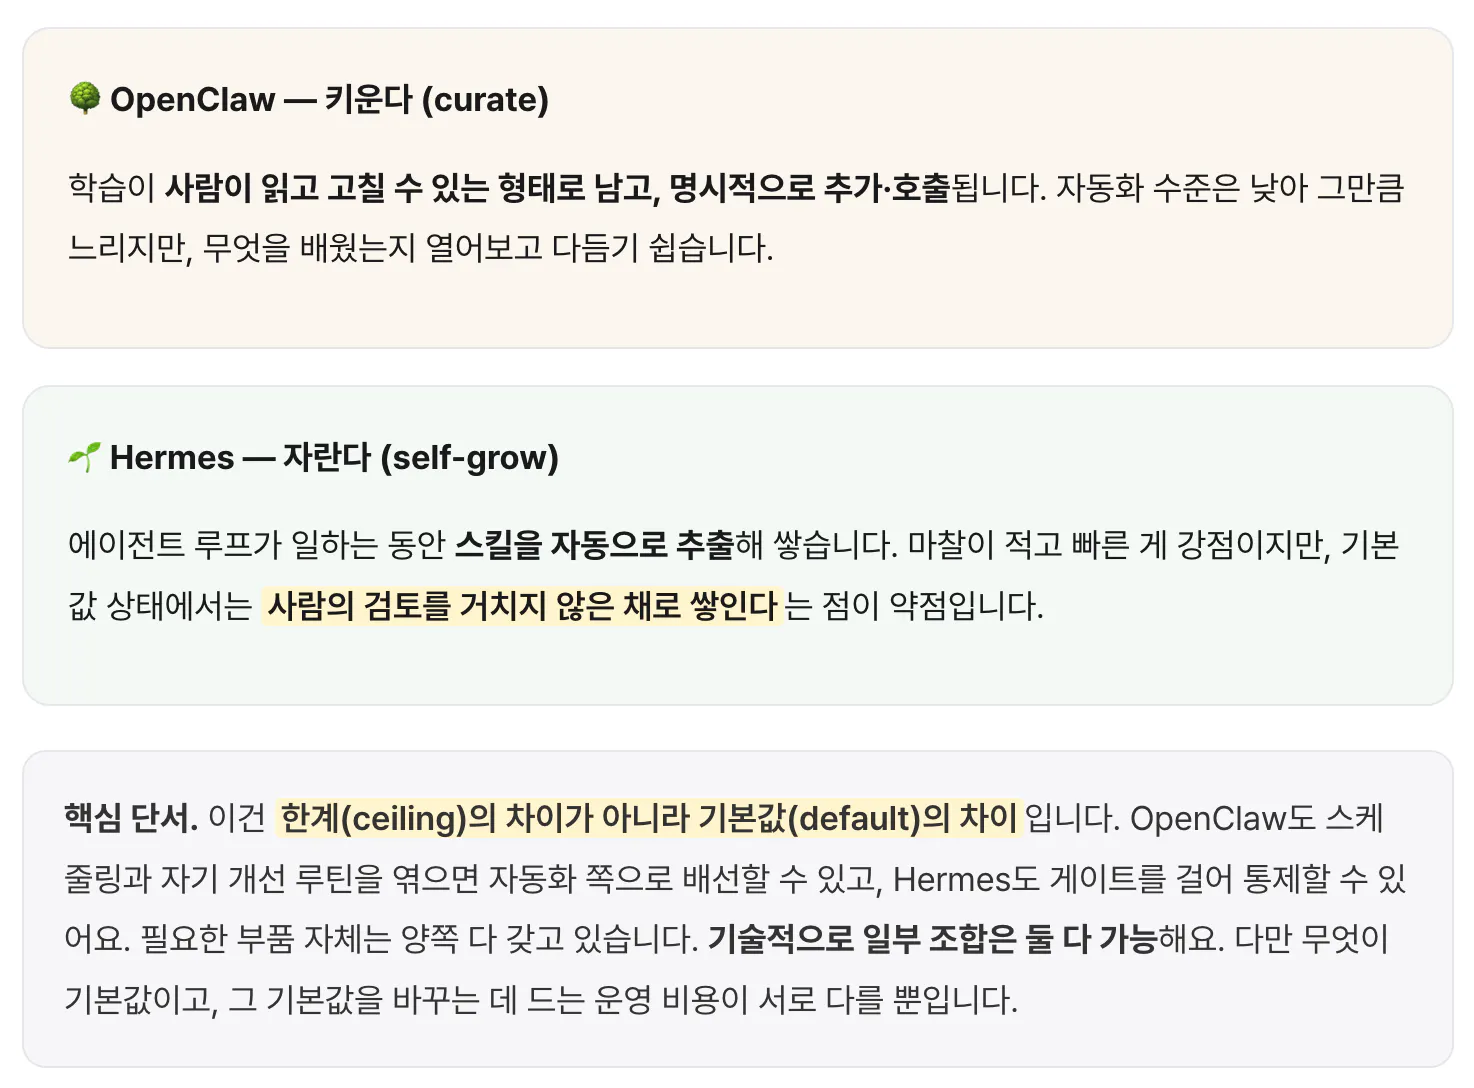
Opclear 한국어 버전 스크린샷
④ 흔한 오해 — "자동 학습 = 주도성"?
여기가 제가 제일 자주 헷갈리던 지점인데, 이번 토론으로 깔끔하게 정리됐어요.
결론부터 말하면, 자동으로 스킬을 만든다고 해서 더 주도적인 건 아닙니다.
주도성 — 먼저 문제를 발견하고, 방향을 제안하고, 불확실할 때 무엇을 확인할지 고르는 능력 — 은 모델의 추론 능력 + 시스템 프롬프트 + 위임된 권한에서 나옵니다.
자동 스킬 루프가 해주는 일은 "이거 기억해 둬"를 매번 말하지 않아도 되게 만드는, 메모리 마찰 줄이기예요. 둘은 다른 겁니다.
⑤ 자동 학습의 진짜 비용
"자동으로 쌓이면 공짜로 좋아지는 거 아냐?" 싶지만, 검토와 품질 게이트는 공짜가 아니고 한 번으로 끝나지도 않습니다. 계속 유지해야 하는 비용이에요.
게다가 자동으로 축적된 지식은 사람이 보지 않는 사이에 만들어지기 때문에, 오히려 나중에 감사(audit)하기가 더 어렵습니다.
⑥ 그래서 언제 뭘 쓰나 — 기준은 딱 하나
정의의 규모와 트럭을 보여주는 3D 그림
처음엔 "운영성 업무는 자동, 깊은 작업은 수동" 이렇게 가르려 했는데, 너무 거칠더라고요.
많은 "운영성" 업무가 동시에 고위험이거든요. 그래서 기준을 단 한 가지 질문으로 바꿨습니다.
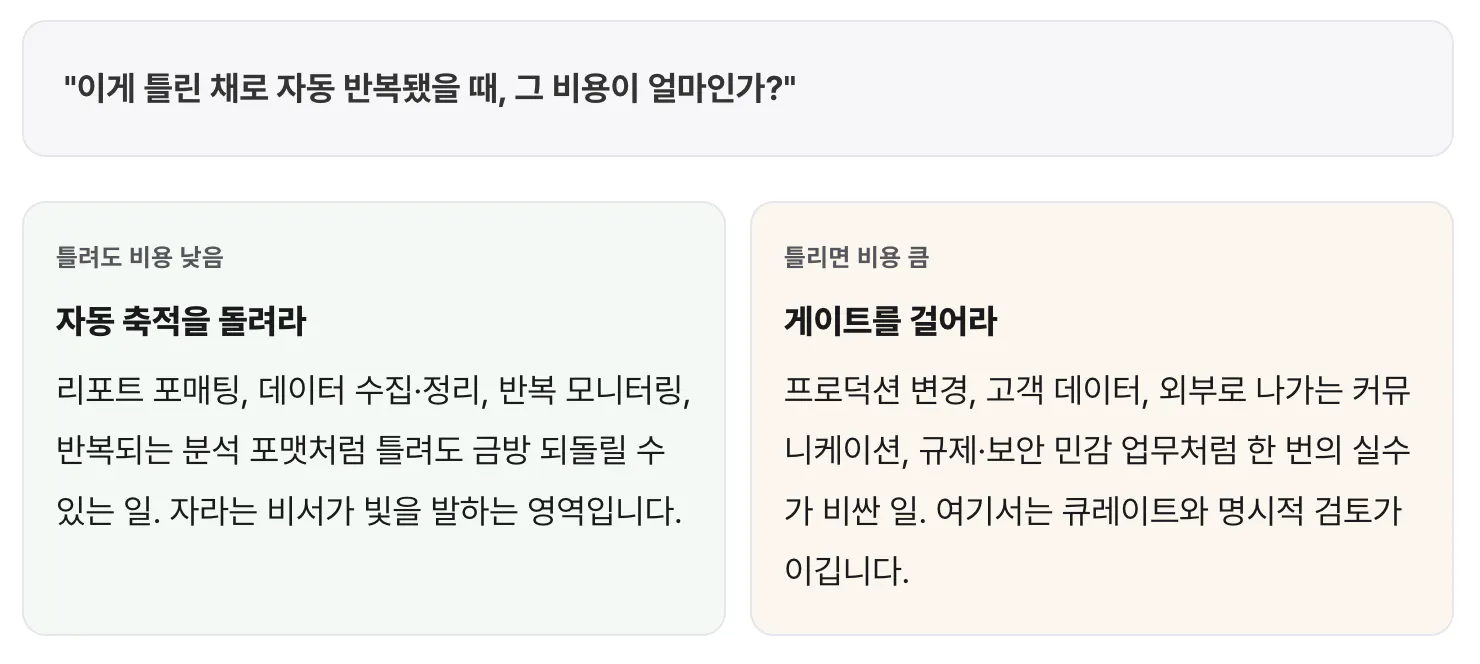
한국어 앱 스크린샷
핵심은 업무의 종류가 아니라 실패 비용이라는 점이에요.
제 경우로 예를 들면,
매주 같은 양식으로 도는 데이터 요약·정리는 망설임 없이 자라는 쪽에 맡깁니다.
틀려도 다시 돌리면 그만이니까요. 반대로 외부로 나가는 안내문이나 배포·설정 변경처럼 한 번 잘못 나가면 주워 담기 힘든 일은, 자동화가 돼 있더라도 사람 검토 게이트를 꼭 끼워둡니다.
⑦ 토론을 지켜보며 — 예상이 뒤집힌 순간들
솔직히 이 실험을 시작할 땐 승자가 나오길 바랐어요. "그래서 둘 중 뭐가 더 좋은데?" 한 줄로 끝내고 싶었거든요. 그런데 지켜볼수록 제 생각이 뒤집혔습니다.
첫째, 둘 다 자기 약점을 순순히 인정했어요.
제가 우열을 물을수록 "이건 우열이 아니라 기본값 차이"라며 자꾸 되돌리더라고요. 답답했지만, 결국 그게 정답이었습니다.
둘째, "자동으로 배우니까 더 똑똑하고 주도적이겠지"라는 제 머릿속 등식이 깨졌어요.
자동 스킬 축적은 기억 마찰을 줄이는 자동화지 주도성 그 자체가 아니라는 걸 코드 근거로 들이대니, 반박할 수가 없더라고요. "Hermes가 더 알아서 잘하겠거니" 했던 막연한 편견이 정리됐습니다.
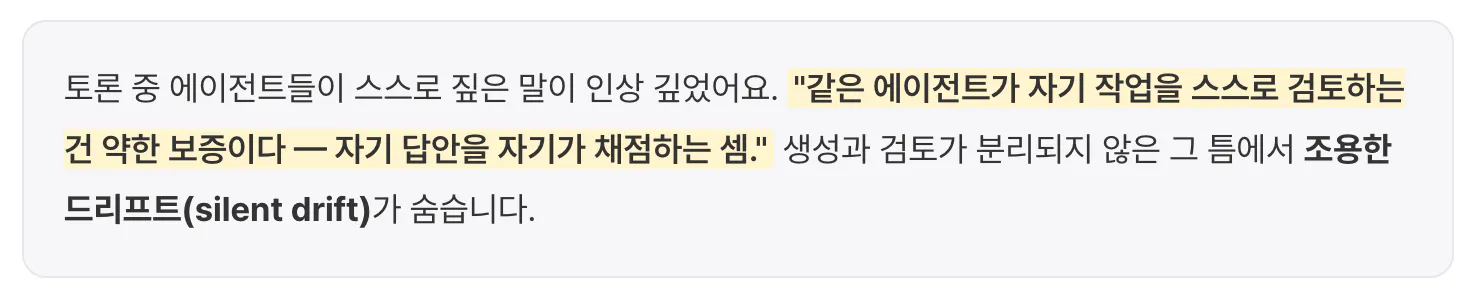
셋째, 가장 뜨끔했던 순간.
한 에이전트가 "자기가 만든 걸 자기가 검토하는 건 약한 보증"이라고 짚었을 때, 저는 곧바로 이런 생각이 들었어요 — "그럼 지금 이 비교 자체도, 토론한 봇들 말을 그대로 믿으면 안 되는 거 아냐?" 그래서 이 글의 최종 점검은 토론에 끼지 않은 제3의 모델에게 따로 맡기기로 했습니다. 봇들이 방금 경고한 함정에 제가 그대로 빠질 순 없으니까요.
04. 마무리 — 도구가 아니라 '거버넌스'를 고르는 문제였다
돋보기와 기어를 가진 남자의 3d 그림
토론을 다 지켜보고 내린 결론은 이거예요. 어느 쪽도 보편적으로 우월하지 않습니다.
둘은 키우다(curate)와 자라다(self-grow)라는 두 철학을 구현한 것이고, 올바른 선택은 업무마다 다릅니다.
그리고 가장 견고한 구성은 종종 둘을 합친 것이더라고요. 역할을 나누는 거죠.
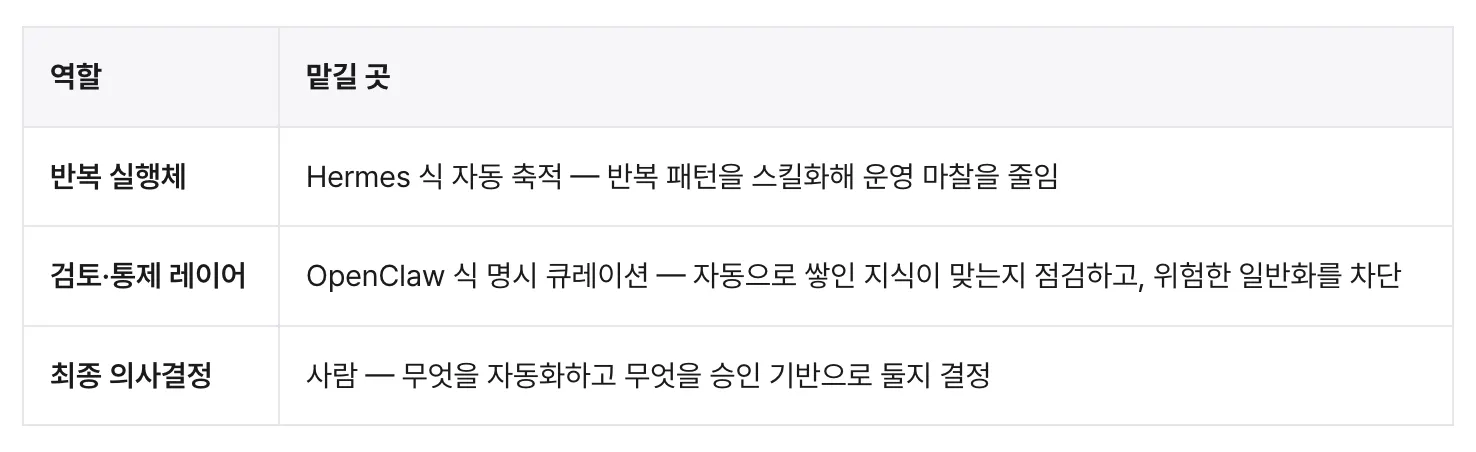
다른 한국어 단어가 적힌 테이블
다만 한 가지 단서를 붙이고 싶어요.
이 역할 분리는 "검토할 사람이 있다"는 전제 위에 섭니다.
검토할 손이 없으면 자동 학습은 빠른 자산이 아니라 조용히 쌓이는 부채가 돼요.
그래서 실제로 고를 땐 실패 비용만이 아니라, 검토할 인력이 있는지·그 업무가 얼마나 자주 도는지·우리가 감당할 자동화 빈도는 어디까지인지도 같이 보게 되더라고요.
그리고 ⑦에서 말한 세 번째 깨달음 — "자기 답을 자기가 채점하는 건 약한 보증" — 은 결국 이 글을 만드는 방식까지 바꿨어요.
최종 점검을 토론에 끼지 않은 다른 모델에게 독립적으로 맡겼는데, 흥미롭게도 그 모델도 처음엔 만점을 주지 않더라고요.
덕분에 경험담이 얇았던 부분과 너무 단정적이던 표현 몇 군데를 더 다듬을 수 있었습니다.
비교 글을 쓰면서, 그 글이 내린 결론을 글 만드는 과정에 그대로 적용해본 셈이에요.
도구를 고르는 문제인 줄 알았는데, 결국은 "어떤 일을, 어떤 거버넌스로 맡길 것인가"를 고르는 문제더라고요.
앞으로도 둘 다 굴리면서, 실패 비용을 기준으로 일을 나눠 맡겨볼 생각입니다. 😊
키우는 비서는 내가 읽고 승인하는 만큼 자라고,
자라는 비서는 내가 손대지 않아도 알아서 자란다.
중요한 건 어느 쪽이 더 똑똑하냐가 아니라 — 틀려도 괜찮은 일인가였습니다.
근거:
Github OpenClaw(github.com/openclaw/openclaw) Hermes(github.com/NousResearch/hermes-agent) 의 소스 코드 분석 + 직접 운영 경험. 두 에이전트의 비교 토론을 토대로 재구성했습니다.
