사이트맵 88개 중 64개가 메뉴판 없는 식당이었습니다: 이중언어 블로그 GEO 진단
2026.07.30
소개
바이오·제약 데이터를 분석하는 일을 하고, 작업 기록을 개인 블로그에 한국어와 영어 한 쌍으로 올립니다. Jekyll로 만들어 GitHub Pages에 배포했습니다. 여기에 AI 에이전트가 매일 만드는 경제 리포트(econ-radar)와 논문 리포트(paper-radar)를 정적 HTML로 함께 올려 두었습니다.
만들어 놓고 계속 걸리던 게 있었습니다. 검색에서 저를 찾는 사람이 있는지 한 번도 확인해 본 적이 없었습니다. 글은 쌓이는데 그게 누구에게 닿는지는 모르는 상태였습니다.
강의에서 논지가 명확했습니다.
구글 검색에 안 나오는 사이트는 AI에도 나오지 않을 가능성이 매우 높다.
그리고 검색봇의 동작을 식당 메뉴판으로 설명한 부분이 인상적이었습니다. 봇은 목록에 있는 사이트를 전부 들어가 보지 않고, 메타데이터를 보고 들어갈지 말지 판단합니다. 메뉴판과 가격이 붙어 있는 식당과 이름만 있는 식당 중에서 우리가 어디를 고르는지와 같습니다.
그래서 이번 주 과제(사이트 선정, 도메인, 서치 콘솔)를 하기 전에 내 사이트가 검색봇에게 어떤 메뉴판을 내밀고 있는지 먼저 재기로 했습니다. 스터디장도 과제 세 개를 다 쓰기보다 하나를 깊게 파는 게 더 좋은 사례글이라고 했으니, 진단 하나에 집중했습니다.
진행 방법
사용 도구: curl + Python(정규식 추출) + 강의에서 배운 점검 항목
강의에서는 메타 체커 확장 프로그램으로 한 페이지씩 확인했습니다. 저는 사이트맵 전체를 대상으로 하고 싶어서 같은 항목을 스크립트로 돌렸습니다.
Step 1. 봇이 가장 먼저 보는 두 파일
강의에서 "사람은 안 열어 보지만 검색봇은 무조건 여기를 가장 먼저 본다"고 한 파일입니다. 바이브코딩 사이트에서 자주 누락된다고 했습니다.
for u in robots.txt sitemap.xml feed.xml; do
  printf "%-14s " "$u"
  curl -s -o /dev/null -w "HTTP %{http_code}\n" "https://kakyungkim.github.io/$u"
done
robots.txt     HTTP 200
sitemap.xml    HTTP 200
feed.xml       HTTP 200
셋 다 있었습니다. Jekyll이 자동으로 만들어 준 덕입니다. 다만 robots.txt 내용은 Sitemap: 한 줄뿐이었습니다.
Step 2. 사이트맵에 무엇이 들어 있는지 셌습니다
여기서 예상과 달랐습니다.
curl -s ".../sitemap.xml" | grep -o "<loc>[^<]*" | sed 's/<loc>//' > sm.txt
echo "총 $(wc -l < sm.txt)"
echo "/en/ $(grep -c '/en/' sm.txt)  /kr/ $(grep -c '/kr/' sm.txt)"
grep -v '/en/\|/kr/' sm.txt | sed 's|/[^/]*$|/|' | sort | uniq -c | sort -rn
구성 | 개수 | 비중 |
|---|---|---|
블로그 글 (영어) | 11 | |
블로그 글 (한국어) | 11 | |
econ-radar 일별 리포트 | 56 | |
paper-radar 리포트 | 8 | |
발표 자료·PDF | 2 | |
합계 | 88 |
블로그 글은 11편이고, 자동 생성 리포트가 64개로 전체의 73%였습니다. 검색엔진에 제출하는 목록의 4분의 3이 제 글이 아니라 에이전트가 매일 찍어낸 리포트였습니다.
Step 3. 한/영 쌍이 정말 짝이 맞는지 확인
이중언어 블로그라 경로 뒷부분을 대조했습니다.
grep '/en/' sm.txt | sed 's|.*/en/||' | sort > en.txt
grep '/kr/' sm.txt | sed 's|.*/kr/||' | sort > kr.txt
comm -23 en.txt kr.txt | wc -l   # en에만 있는 것
comm -13 en.txt kr.txt | wc -l   # kr에만 있는 것
comm -12 en.txt kr.txt | wc -l   # 짝이 맞는 것
en 고유: 0건
kr 고유: 0건
쌍 일치: 11건
11쌍이 완벽하게 대응했습니다. 여기서 문제가 보였습니다.
Step 4. 메타데이터를 항목별로 뽑았습니다
강의의 메타 체커가 보는 항목을 그대로 검사했습니다. 강의에서 "메인이 아니라 검색에 뜨기를 바라는 개별 포스팅을 재라"고 했으니 개별 글로 했습니다.
항목 | 블로그 개별 글 | econ-radar 일별 리포트 |
|---|---|---|
title | ✅ | ✅ |
description | ✅ | 🚫 없음 |
og:title | ✅ | 🚫 없음 |
og:type | ✅ article | 🚫 없음 |
article:published_time | ✅ | 🚫 없음 |
canonical | ✅ | 🚫 없음 |
og:image | 🚫 없음 | 🚫 없음 |
twitter:card | 🚫 없음 | 🚫 없음 |
JSON-LD | 🚫 없음 | 🚫 없음 |
hreflang | 🚫 없음 | 해당 없음 |
HTML 크기 | 21KB | 128KB |
Step 5. 루트 페이지도 봤습니다
https://kakyungkim.github.io/ 자체는 HTML이 0KB였습니다. canonical만 /kr/을 가리키는 리다이렉트 셸이고 description과 Open Graph가 전혀 없었습니다. 언어 선택을 위한 구조라 의도된 것이지만, 도메인 루트로 접근하는 봇에게는 빈 문서를 내밀고 있습니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
robots.txt / sitemap.xml / feed.xml | 셋 다 있음 (HTTP 200) |
사이트맵 총 URL | 88 |
그중 자동 생성 리포트 | 64개 (73%) |
실제 블로그 글 | 11편 (한/영 22 URL) |
한/영 쌍 일치도 | 11/11 완벽 대응 |
그런데 hreflang | 없음 |
og:image | 전 페이지 없음 |
JSON-LD | 전 페이지 없음 |
자동 리포트의 description·canonical | 없음 |
자동 리포트 HTML 크기 | 128KB |
도메인 |
|
배운 점
사이트맵의 73%가 메뉴판 없는 식당이었습니다. 강의의 비유를 그대로 적용하면 이렇습니다. 저는 검색봇에게 64곳을 소개하면서 그중 어디에도 메뉴판을 걸어 두지 않았습니다. 자동 생성 리포트에는 title과 viewport만 있고 description, Open Graph, canonical이 전부 없습니다. 봇이 들어갈지 판단할 근거가 없습니다.
hreflang이 없다는 게 이중언어 블로그에서는 치명적입니다. 11쌍이 경로까지 완벽히 대응하는데, 서로가 같은 글의 다른 언어판이라고 선언하는 수단이 없습니다. 검색엔진 입장에서는 두 페이지가 각자 경쟁하는 별개 문서로 보일 수 있습니다. 한 쌍을 만들 때마다 제 페이지끼리 경쟁할 자리를 하나 더 만들고 있었습니다. 이건 일반 블로그에는 없고 이중언어 구조에만 생기는 문제라, 강의의 일반 점검 항목을 제 사이트에 대 보고 나서야 보였습니다.
"검색에 뜨기를 바라는 페이지를 재라"는 지침이 사이트맵 설계에도 적용됩니다. 저는 성능 측정 대상을 고르라는 말로만 들었는데, 사이트맵에 무엇을 넣을지에도 같은 질문이 필요합니다. 매일 갱신되는 일별 리포트가 검색에 떠야 하는 페이지인지 저는 답을 못 했습니다. 답을 못 하는 페이지가 73%였습니다.
자동 생성 파이프라인은 메타데이터를 만들지 않습니다. 블로그 글은 Jekyll 테마가 메타데이터를 붙여 주지만, 제가 직접 HTML로 뽑아 올린 리포트는 아무것도 붙지 않았습니다. 발행을 자동화하면서 발행물의 메타데이터도 자동화 대상이라는 걸 빼먹었습니다.
128KB HTML은 성능 관점에서 무겁습니다. 강의에서 비슷한 정보면 성능 좋은 사이트를 우선 노출한다는 구글 문서 근거를 들었습니다. 일별 리포트가 블로그 글의 여섯 배 크기입니다.
시행착오
사이트맵 URL을 처음에
grep -o "<loc>" | wc -l로 세어 87개로 봤는데, 다시 세니 88개였습니다. 구성을 분해해 11 + 11 + 56 + 8 + 2 = 88로 검산하고 나서야 확정했습니다. 합계가 부분의 합과 맞는지 확인하지 않으면 한 개씩 틀립니다."블로그 글 88편"이라고 잠깐 착각했습니다. 사이트맵 URL 수를 글 수로 읽은 것입니다. 분해해 보니 실제 글은 11편이었습니다. 총량이 아니라 분류별로 세야 한다는 걸 또 확인했습니다.
메타 체커 확장 프로그램 대신 스크립트로 돌린 건 사이트맵 전체를 보려는 의도였는데, 정규식으로 태그를 뽑다 보니 속성 순서가 다른 경우를 놓칠 수 있습니다. 주요 항목은 페이지 소스를 직접 열어 교차 확인했습니다.
앞으로의 계획
우선순위를 이렇게 잡았습니다.
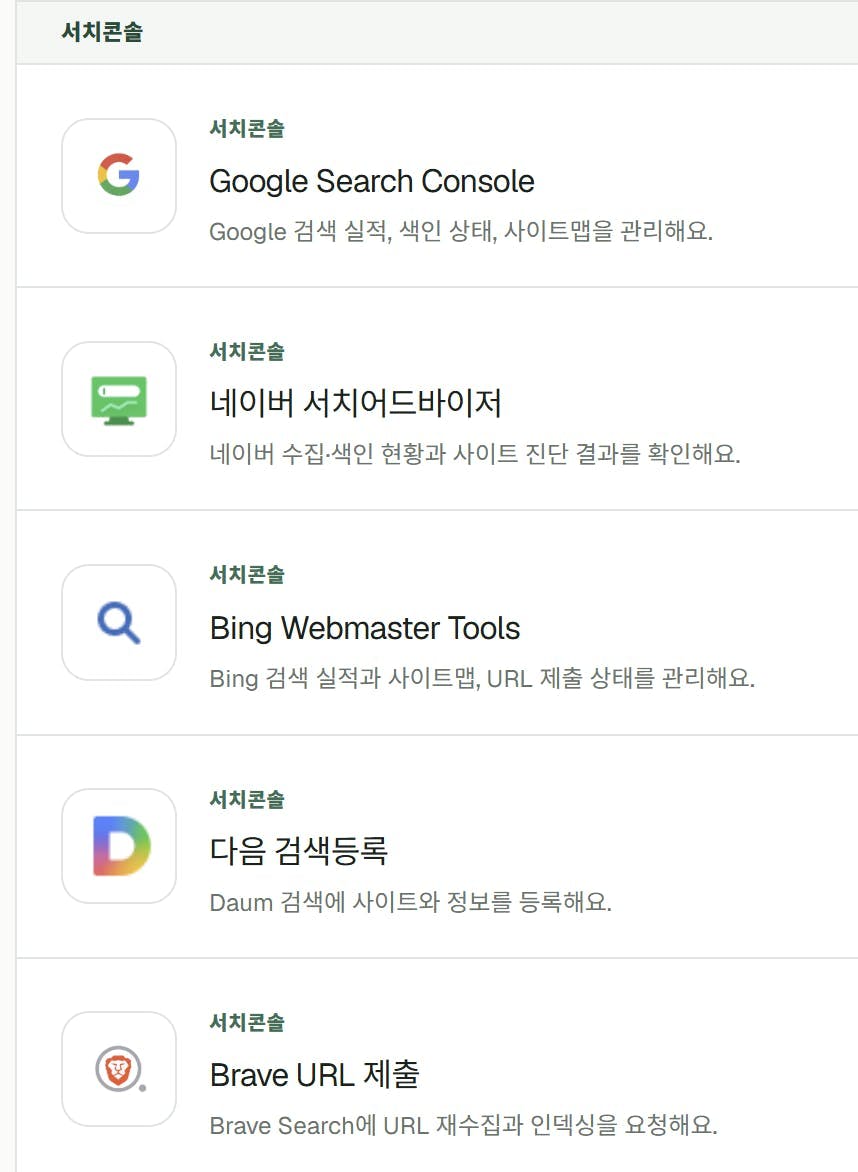
서치 콘솔 등록을 먼저 합니다. 강의에서 1주차 과제가 가장 중요하다고 한 이유가 명확합니다. 지금 붙여 두지 않으면 4주 뒤에 볼 데이터가 없습니다. 구글, 네이버, 빙에 등록하고 Brave에도 URL을 제출할 계획입니다. 클로드의 웹서치가 Brave 영향을 크게 받는다는 정보는 이 강의에서 처음 들었습니다.
hreflang을 넣습니다. 11쌍이 이미 완벽히 대응하니 Jekyll 레이아웃에서 상호 참조를 생성하면 됩니다. 효과가 가장 클 것으로 보는 항목입니다.
자동 생성 리포트에 메타데이터를 붙입니다.
econ-radar발행 스크립트에서 description과 canonical을 함께 찍도록 고칩니다. 64개를 손으로 고칠 수는 없으니 파이프라인을 고치는 쪽입니다.사이트맵에서 무엇을 뺄지 정합니다. 일별 리포트를 전부 제출하는 게 맞는지 판단한 뒤, 검색 목적이 아닌 것은 빼는 방향을 검토합니다.
og:image와 JSON-LD, 도메인 구입은 그다음입니다. 도메인은 갱신가가 같은 클라우드플레어를 보고 있습니다.
도움 받은 글 (옵션)
23기 GEO노출전략 1주차 강의 (체크): 검색에 안 나오면 AI에도 안 나온다는 논지, 검색봇을 식당 메뉴판으로 설명한 비유, 클로드 웹서치와 Brave의 관계, 성능이 노출에 영향을 준다는 구글 문서 근거, robots.txt와 sitemap.xml이 봇이 가장 먼저 보는 파일이라는 점

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
메뉴판 없는 식당이라는 비유가 재미있네요. 이미 써놓은 글이 많이 있으시니 메뉴판을 잘 달아서 사이트 유입이 증가하는 모습도 볼 수 있으면 좋겠습니다.