트렌드 좇기를 그만두고, 내 리포트에서 시작하는 콘텐츠 자동화로

2026.07.24
## 소개
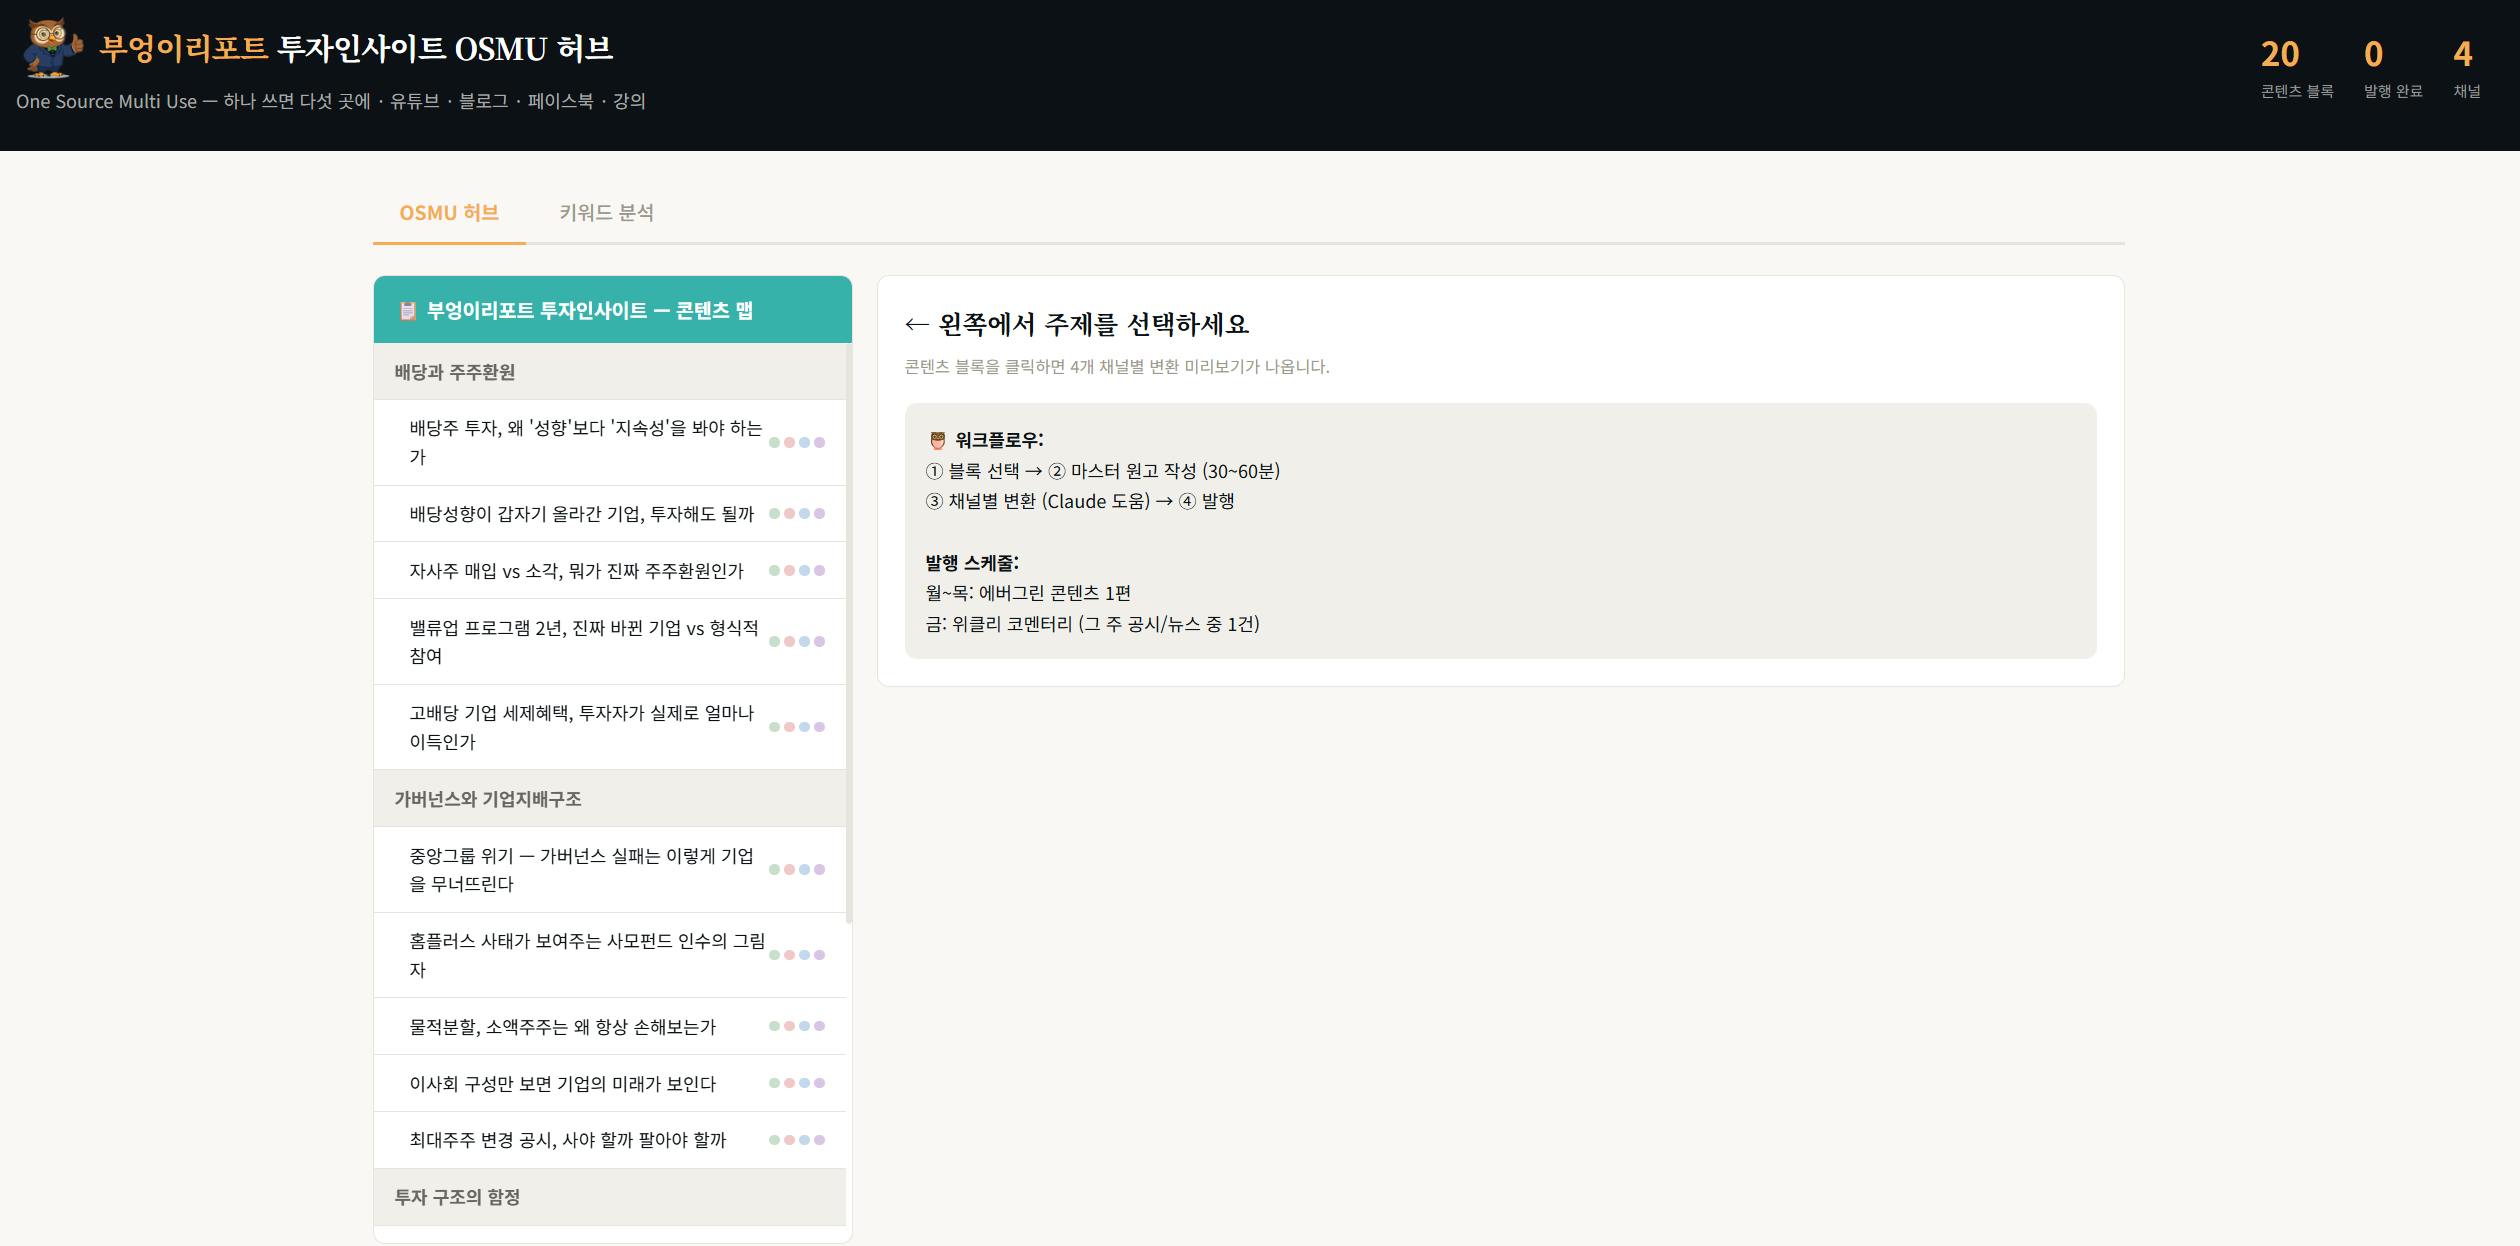
어제(7/23) Claude Cowork에서 네이버 블로그를 새로 시작해보려고 글감 분석부터 시작했어요. GPTers에서 들은 콘텐츠 자동화 강의 노션 노트도 가져와 참고하고, 블로그·유튜브·페이스북·강의로 하나의 소스를 여러 채널에 쓰는 OSMU(One Source Multi Use) 허브(`osmu_hub_v2.html`)까지 만들어봤어요. 그런데 이 허브가 "글감을 먼저 검색해서 그 순간 상위 트렌드 키워드를 잡아내고, 거기에 맞춰 글을 쓰는" 방식이었는데, 곰곰이 보니 이게 제가 원하는 방향이 아니었어요. 저는 트렌드를 좇기보다 이미 써둔 심층분석 리포트(회계·재무 데이터 기반)를 여러 채널 콘텐츠로 바꾸는 쪽이 맞다고 봤고, 이 고민에서 오늘(7/24) 작업이 시작됐습니다.
그 중에서도 늘 시간이 오래 걸리던 게 유튜브 대본 만드는 일이었어요. 리포트를 쓰고 나면 그걸 Q&A 인터뷰 대본으로 바꾸는데, 그때그때 글감을 찾고 채팅으로 발전시켜나가는 구조라 시간이 많이 걸렸어요. 특히 초안 대본을 처음 잡는 단계가 제일 오래 걸렸고, 답변이 너무 길게 나와서 나중에 분량을 반으로 줄이는 일도 반복됐어요(실제로 홈플러스 리포트 대본은 12라운드 그대로인데 답변 길이만 반으로 줄인 적이 있어요).
그래서 오늘은 트렌드 검색이 아니라 제 리포트를 원천으로 삼아 리포트 → 대본 → PPT/쇼츠 → 블로그로 이어지는 콘텐츠 제작 전체를 skill로 쪼개보기로 했습니다.
## 진행 방법
어제(Cowork): 블로그 방향 논의 → 회계를 쉽게 풀어쓰기 + 기업분석 사례 조합 추천받음 → GPTers 노션 강의노트 확인 → 홈플러스 리포트(22개 챕터)로 블로그 8편 구성안 받고 1편 초안(HTML+차트 이미지 3장) 작성 → 네이버가 AI 콘텐츠 업로드 속도를 감지한다길래 이미지 천천히 올리기, 발행 간격 두기, 본인 의견 직접 넣기 같은 대응까지 논의.
오늘(이 Claude Code 세션): 기존에 만들어둔 실제 자료(홈플러스 리포트 22개 장 분량, 실제 대본 12라운드)를 Claude에게 보여주고 패턴을 분석하게 한 다음, skill 4개를 순서대로 만들었어요.
1. dart-financial-summary — 기업명 주면 DART에서 10년치 연결재무제표 핵심 항목만 뽑아 요약표로 정리
2. owlsreport-qa-script — 확정된 리포트를 Q&A 인터뷰 대본으로 재편성
3. owlsreport-ppt-shorts — 대본을 답변용/질문용/쇼츠(9:16) PPT로 변환
4. owlsreport-naver-blog — 확정된 리포트를 네이버 블로그 글(HTML+이미지)로 재편성
실제로 쓴 프롬프트 일부를 남겨둡니다.
> 지금 자동화에서 시급한 것은 유튜브 대본을 만드는 것의 자동화입니다.
> 블로그스킬에 그림이나 표 생성, 그림이나 표는 png나 jpg로 따로 제시. 블로그 자체는 html로 완성. 블로그 포맷은 경제블로거 중 파워블로거 5인의 스타일 차용. 메인컬러는 부엉이리포트 색상 사용
DART skill은 Open DART API 키를 직접 발급받아 환경변수로 등록하고, 삼성전자로 실제 조회까지 해봤어요. 실제로 호출했던 코드는 이렇습니다.
```powershell
$url = "https://opendart.fss.or.kr/api/fnlttSinglAcntAll.json?crtfc_key=$env:API_K_DART&corp_code=00126380&bsns_year=2023&reprt_code=11011&fs_div=CFS"
$resp = Invoke-RestMethod $url
```
삼성전자 2023년 영업이익 6,566,976,000,000원이 그대로 응답에 찍혔어요. 회사마다 "매출액"이 "영업수익"으로 표기되는 등 계정명이 조금씩 다르다는 것도 이때 알게 됐습니다.
네이버 블로그 skill은 말로 설명하는 대신, 실제로 즐겨보는 파워블로거 4곳(와이민, 포카라의 실전투자, 피우스의 책도둑, 이안의 경제노트) 화면을 캡처해서 보여주고 스타일을 참고하게 했어요.
여기서 OSMU 허브와의 차이가 분명해졌어요. 허브는 미리 정해둔 주제 목록에서 채널별로 짧은 변환 문구를 뽑아주는 방식이었다면, 이번에 만든 skill들은 제 리포트 원문(수만 자 이상)을 통째로 넣으면 그걸 근거로 각 채널 산출물을 새로 써주는 방식이에요.
오후에는 어제 만든 OSMU 허브도 손봤습니다. 오늘 만든 skill과 헛갈리지 않게 역할을 정리하고("허브는 짧은 틀 채우기, skill들은 원문 통째로 변환"), 부엉이리포트 브랜드 컬러(앰버·청록·다크네이비)로 테마를 바꾸고 부엉이 마스코트를 넣었어요. 그리고 파생 콘텐츠(블로그 시리즈 등)를 낼 순서를 정할 때 참고할 트렌드 데이터도 붙여보려고 했습니다.
## 결과와 배운 점
DART skill은 실제 API 호출까지 성공했고, 블로그 skill은 홈플러스 리포트로 실제 1편을 완성했어요. 나머지 두 개(Q&A 대본, PPT+쇼츠)는 설계는 끝났지만 아직 실제로 돌려보지는 않았습니다.
실제로 나온 이미지들입니다
![타이틀카드 — 그라데이션+글로우+핵심수치 칩]
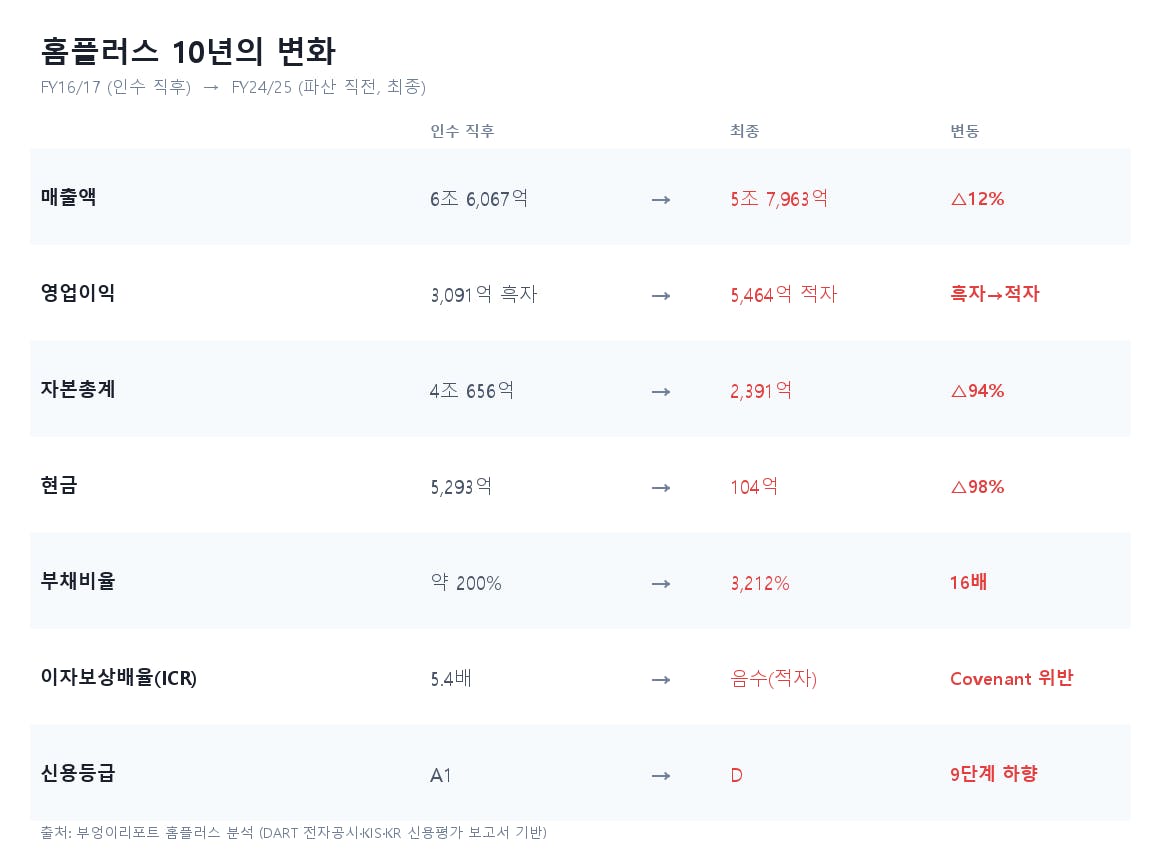
![10년 전후 비교 스코어카드 — 자본총계 94% 증발, 신용등급 9단계 하향 등]
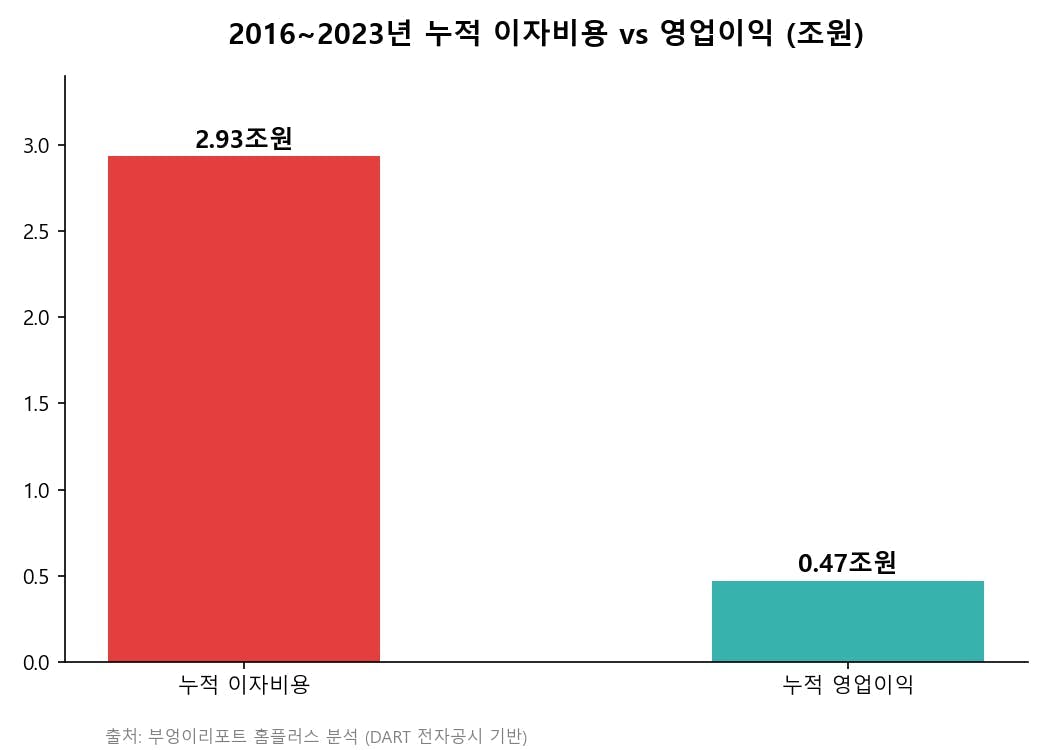
![자본구조 도넛 차트 — 7.2조원 인수 구조 분해]
시행착오가 여러 번 있었어요.
- 예전에 만든 프로젝트 지침 문서에 "DART는 open-proxy-mcp로 가져온다"고 적어놨었는데, 이건 실제로 작동하는 도구가 맞았어요. 다만 이번에 작업한 Claude Code 세션에는 그게 연결돼 있지 않아서, 대신 DART Open API를 직접 호출하는 방식으로 새로 만들었습니다.
- 이미지를 Gemini로 생성해보려 했는데, API 키는 있었지만 무료 계정이라 이미지 생성 할당량이 0이라 막혔어요. matplotlib/Pillow로 방향을 바꿨습니다.
- 블로그 초안을 처음 봤을 때 "너무 유치하다"고 느꼈어요. 파워블로거 캡처 화면을 보여주고 나서야 뭐가 부족한지(사진, 이미지 리듬)가 명확해졌어요.
- 두 번째 초안도 "내용이 부실하다"는 느낌이 들었는데, 원인을 보니 이미 절반으로 줄여놓은 Q&A 대본을 근거 자료로 썼기 때문이었어요. 원본 리포트 원문으로 다시 쓰니까 훨씬 나아졌습니다.
- OSMU 허브의 부엉이 마스코트 이미지가 파일명은 "무배경"인데 실제로 열어보니 흰 배경이 그대로 박혀 있었어요(픽셀의 52%가 순백색). 직접 배경을 제거해서 고쳤습니다.
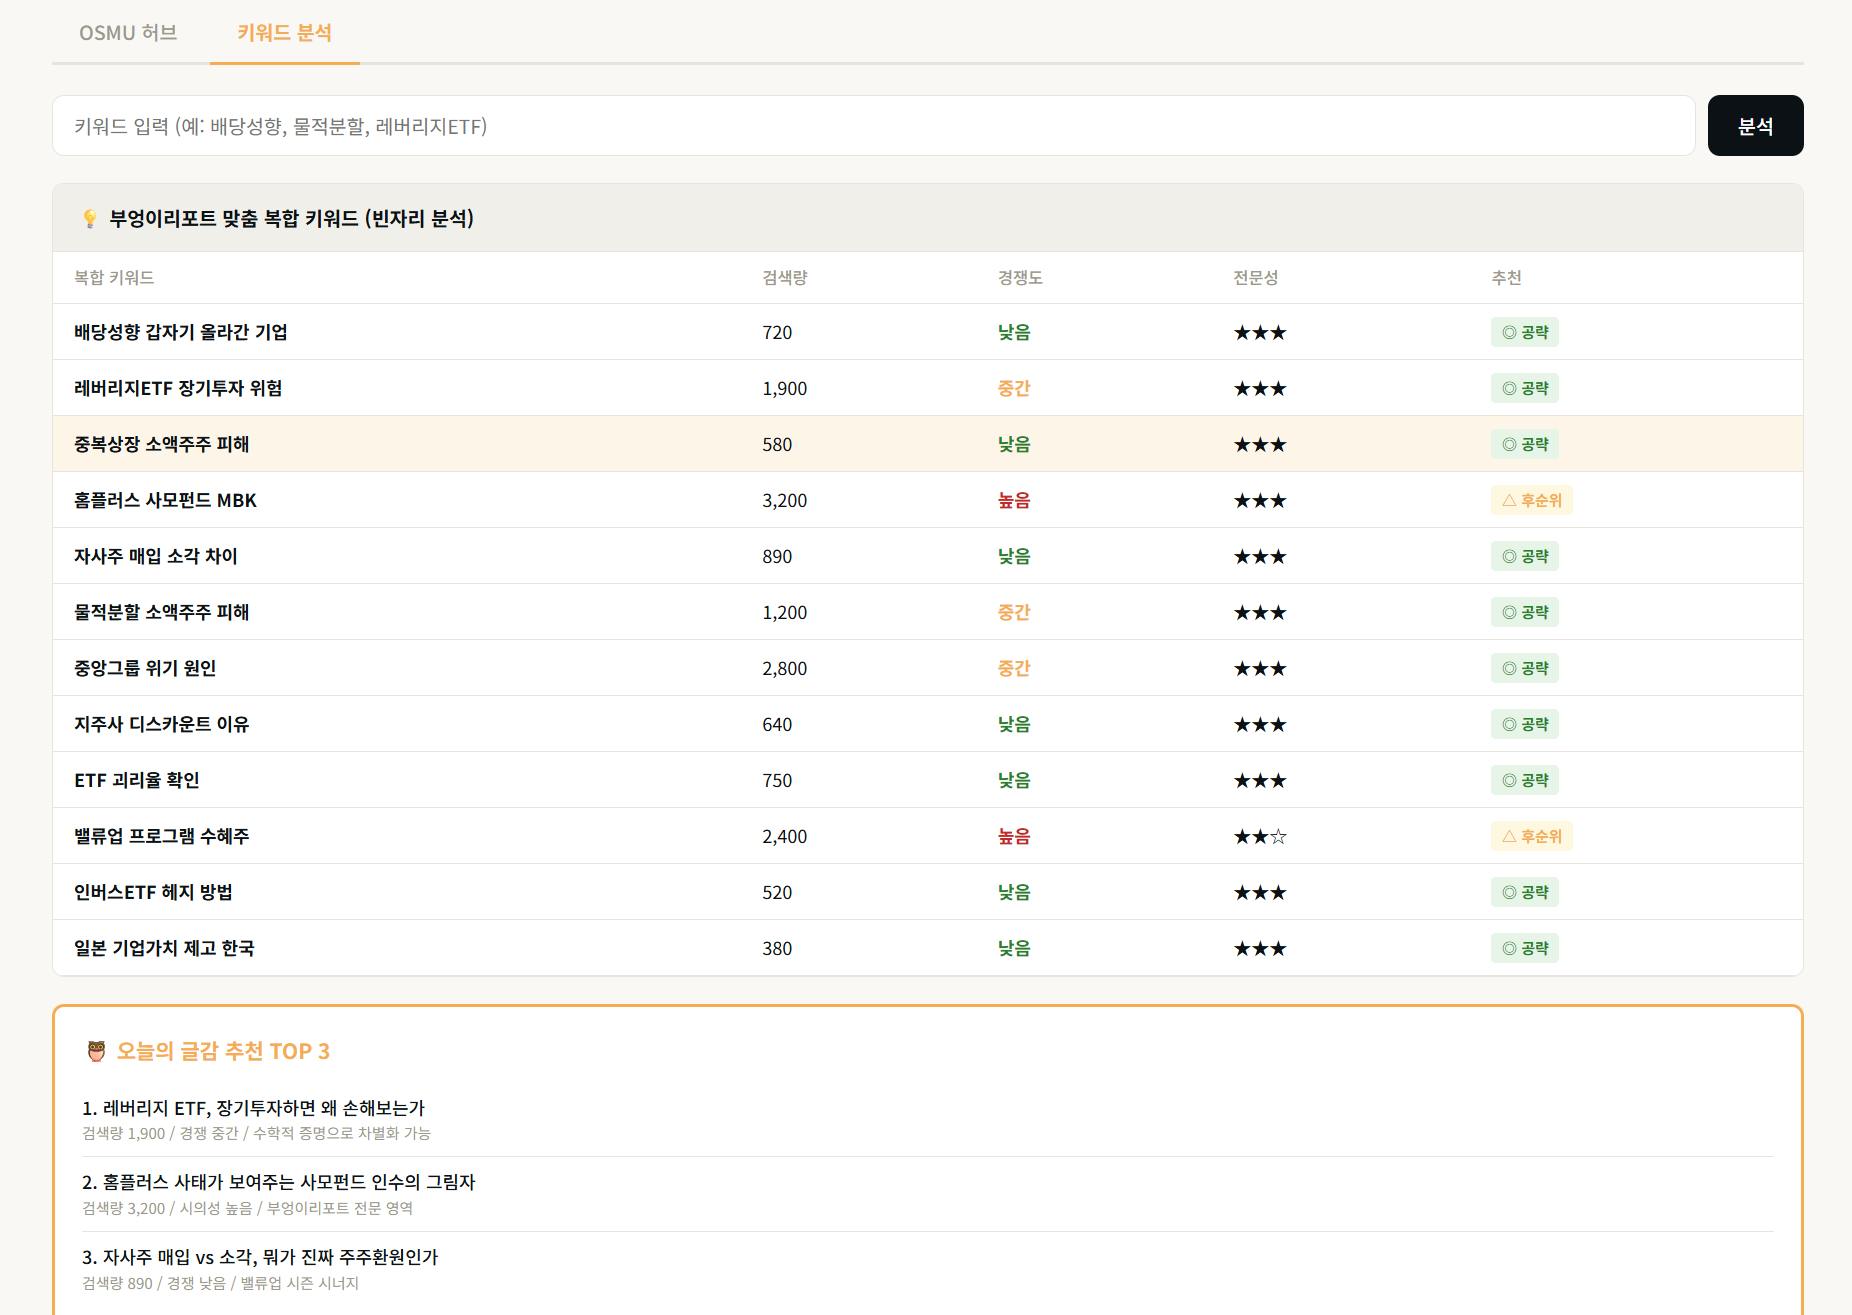
- 파생 콘텐츠 발행 시점을 정하려고 네이버 데이터랩(검색어트렌드) API를 붙이려 했는데, Client ID/Secret을 발급받아 등록까지 마쳤는데도 401 에러가 났어요. 알고 보니 이 API 서비스 자체가 하루 전인 7월 23일에 공식 종료된 상태였습니다. 대신 k-skill의 뉴스검색·블로그검색(개인 키 없이 공용으로 쓸 수 있는 도구)으로 "지금 화제인지"를 가늠하는 쪽으로 방향을 바꿨습니다.
여기서 얻은 꿀팁은 세 가지예요. 첫째, 이미 한 번 축약된 자료를 근거로 쓰면 내용이 계속 얇아진다는 것. 콘텐츠를 변환하는 skill을 만들 때는 항상 가장 원본에 가까운 자료를 입력으로 써야 합니다. 둘째, 스타일을 말로 설명하는 것보다 실제 화면 캡처를 보여주는 게 훨씬 정확하게 방향을 잡아줍니다. 셋째, 자동화용 API가 죽어도 사람이 직접 보는 웹 도구(네이버 데이터랩 웹사이트, 블랙키위 같은 곳)는 대개 따로 살아있다는 것 — 자동화가 막히면 "이것도 이제 안 되는구나"로 끝내지 말고 사람이 직접 보는 경로가 남아있는지 확인해볼 만합니다.
도움이 필요한 부분은 나머지 두 skill(Q&A 대본, PPT+쇼츠)을 실제 리포트로 돌려보는 것이에요. 아직 설계만 끝났고 실제 테스트는 안 해봤습니다.
앞으로는 남은 두 skill을 실제로 돌려보고, 파생 콘텐츠 발행 순서는 뉴스·블로그 검색 기반으로 시의성을 가늠해보고, Claude Cowork에 따로 만들어둔 리포트 작성·검증용 skill들과 이번에 만든 것들을 실제 작업에 같이 써보려고 합니다.
로그인하고 댓글을 남겨 주세요


OSMU 허브를 부엉이리포트의 앰버·청록·다크네이비 테마와 마스코트로 다시 정리해, 자동화 결과물에도 브랜드의 결을 일관되게 입히신 점이 인상적이었습니다. 특히 ‘무배경’이라는 파일명만 믿지 않고 실제 픽셀의 52%가 순백색임을 확인한 뒤 직접 배경을 제거하신 과정에서 결과물을 끝까지 검증하는 꼼꼼함이 느껴졌어요. 기능 구현뿐 아니라 보이는 완성도까지 세심하게 챙긴 기록을 나눠주셔서 감사합니다.
트렌드를 좇지 않고 이미 만든 심층분석 리포트를 블로그·쇼츠·PPT 등 여러 채널용 콘텐츠로 자동 변환하는 워크플로우를 만든 사례. "이미 한 번 축약된 자료를 근거로 쓰면 내용이 계속 얇아진다"는 부분에서 인사이트를 얻었어요.
네이버 블로그 운영자가 급등 키워드를 발견해 자신에게 맞는 제목·글감으로 바로 저장하도록 돕는 '키워드레이더' 서비스를 기획한 사례. "모든 키워드를 폭넓게 추적하려던 초심에서 벗어나, 사용자가 실제로 쓸 키워드를 고르고 저장하는 기능에 초점을 옮겼다"는 부분에서 인사이트를 얻었어요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
부엉부엉님, 트렌드를 계속 따라가는 대신 이미 쌓아둔 심층 리포트에서 콘텐츠를 꺼내겠다는 방향이 좋네요. 기업분석처럼 깊이가 중요한 주제는 새 이슈를 빨리 잡는 것보다 본인이 가진 자료를 얼마나 잘 풀어내는지가 더 큰 차이가 될 것 같아요.
블로그 초안이 얇게 나왔을 때 Q&A 대본이 아니라 원본 리포트를 다시 넣어 해결한 부분이 특히 눈에 들어왔습니다. 한 번 요약된 자료를 다시 변환하면 내용이 계속 가벼워진다는 걸 직접 확인하신 거잖아요. 화면 캡처로 원하는 스타일을 보여준 방법도 바로 써먹기 좋은 팁이네요.
DART 연결 방식, 이미지 생성 도구, 데이터랩 API까지 중간에 막힌 게 많았는데 각각 다른 경로를 찾아서 작업을 이어간 것도 좋았습니다. 도구 하나가 멈춰도 전체 작업이 멈추지 않도록 바꾼 과정이 잘 보였어요.
이제 남은 두 스킬은 새 기능을 더 넣기보다 리포트 하나를 골라 대본부터 PPT와 쇼츠까지 한 번에 끝까지 돌려보면 좋겠습니다. 단계마다 내용이 얼마나 줄어드는지, 사람이 어디를 고쳐야 했는지 함께 남겨두면 다음 리포트부터 훨씬 빨라질 것 같아요.
이미 가진 리포트가 탄탄해서 콘텐츠로 펼칠 재료는 충분해 보입니다. 실제 채널에 올라간 결과도 기대할게요 👍