


한줄 요약
최근 자주 언급되는 Prime Agent를 제 하네스 구조를 뜯어고지는 실제 장기 작업에 처음 투입해 봤습니다.
Prime Agent는 한 세션에서 계획을 고정하고, 구현 담당과 검토 담당 AI를 나누고, 오류를 고쳐 최종 적용하는 데까지 수십 분 넘게 작업을 이어갔습니다. 신기했던 만큼 답답한 점도 있었습니다. 작업은 계속되고 있는데, 지금 무엇을 하고 있는지는 바로 눈에 들어오지 않았습니다. 그래서 막판에는 결과보다 “도대체 어떤 방식으로 일한 거야?”를 다시 물어보게 됐습니다.
이 글에서 저는 방향을 정하고 중간 결정을 승인했습니다. 실제 파일 조사·계획 작성·구현·검증은 AI들이 수행했습니다. 특히 이번 실행은 Prime Agent라는 작업 환경에 GPT-5.6-Sol을 연결한 조합이었습니다. 따라서 제가 느낀 차이가 Prime Agent의 구조에서 온 것인지, 모델의 특성에서 온 것인지는 아직 분리해서 말할 수 없습니다. 이 글은 Paseo를 한번 돌려본 관찰 기록입니다.
이런 분께
AI에게 단발성 질문을 넘어서 몇십 분짜리 작업을 맡겨보고 싶은 분
Claude Code나 Codex 같은 코딩 에이전트를 쓰지만, 여러 AI를 나눠 부리는 방식은 낯선 분
긴 작업에서 AI가 무엇을 기억하고 어떻게 이어가는지 궁금한 분
먼저, 이 글에 나오는 용어부터
용어를 전부 쉬운 말로 바꾸면 실제로 무엇을 썼는지가 사라집니다. 이름은 그대로 두되, 이 글에서 어떤 뜻으로 썼는지만 먼저 풀어보겠습니다.
용어
이 글에서의 뜻
Prime Agent
긴 작업의 상태를 들고 있으면서 파일·명령·다른 AI를 조율한 지휘 에이전트
Paseo
여러 종류의 AI를 별도 작업창과 작업 공간에서 실행하고 상태를 관리한 도구
IPython
Python 명령을 한 줄씩 실행하고, 경로·결과·식별자를 변수로 계속 보관하는 작업대
Master
전체 상태와 승인 경계를 관리하는 오케스트레이터 역할. 특정 AI 제품 이름이 아니라 역할 이름
Worker
실제 계획이나 코드를 만드는 구현 담당 역할
Reviewer
구현에는 손대지 않고 오류와 계약 위반을 찾는 검토 담당 역할
Worktree
같은 프로젝트에서 다른 변경과 섞이지 않게 마련한 독립 작업 공간
Commit
한 번 검토하고 적용할 변경분을 묶어 고정한 기록
Hash
파일이나 작업본이 중간에 바뀌지 않았는지 확인하는 고유 지문
Harness
AI가 규칙에 따라 안전하게 작업하도록 만든 운영 구조
Refine
이번 작업에서 얻은 기억이나 절차를 이후 세션에서 다시 쓰도록 저장하는 기능
Prime Agent가 지휘하고, Paseo가 작업 공간을 펼쳤습니다
제가 원한 구성은 단순했습니다. Prime Agent를 당분간 master로 쓰되, 구현은 Claude Opus 5에게 맡기고, 코드는 Codex GPT-5.6-Sol이 검토하고, 위험이 큰 작업에는 Grok 4.5도 독립 검토자로 붙이는 방식이었습니다.
저 — 방향 결정·중간 승인·최종 적용 승인
└─ Prime Agent — 상태 유지·작업 분해·검증·결과 통합
   └─ Paseo — 역할별 에이전트 세션과 독립 작업 공간 실행·대기·정리
      ├─ Claude Opus 5 — 구현 담당
      ├─ Codex GPT-5.6-Sol — 코드 검토 담당
      └─ Grok 4.5 — 추가 독립 검토 담당
터미널에서 작업해도 되지만, 저는 Paseo에 커스텀 Provider로 Prime Agent를 연결한 뒤 작업하였습니다.
Prime Agent는 IPython에서 Paseo 명령을 호출해 Claude·Codex·Grok의 별도 에이전트 세션을 띄우고 역할별 작업을 배정했습니다. 이어 Paseo가 돌려준 작업 공간과 agent 식별자를 변수에 저장했습니다. 이후에는 그 식별자를 이용해 작업이 끝났는지 기다리고, 결과를 가져오고, 도중에 필요 없는 작업 공간을 닫았습니다.
리뷰 담당에게는 구현 담당의 작업 공간을 그대로 주지 않았습니다. 같은 commit에서 출발하되 각자 별도의 worktree를 만들었습니다. 덕분에 검토자가 실수로 파일을 바꾸더라도 구현 원본이나 main 작업 공간과 섞이지 않았습니다. 검토가 끝난 공간은 닫고, 승인 대기 중인 proposal 작업 공간만 남겼습니다.
말로 풀면 “AI 몇 명을 불렀다”지만, 실제로는 누가 어느 작업본을 보고 있는지 격리하는 일이 절반이었습니다.
IPython은 계산기가 아니라 작업 원장이었습니다
제가 기존 에이전트와 가장 다르게 느낀 부분 중 하나는 IPython이었습니다. 화면에서는 Prime Agent가 계속 shell 명령을 실행하는 것처럼 보였습니다.
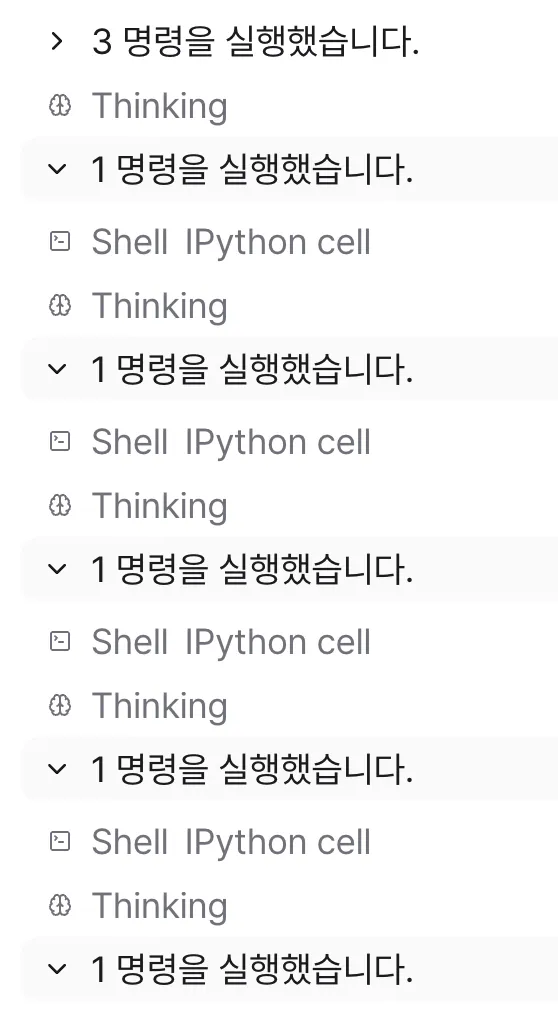
실제로는 IPython이라는 Python 작업대에서 Git·테스트·Paseo 명령을 호출하고, 그 결과를 다음 단계에서 다시 쓸 수 있도록 변수에 보관하고 있었습니다. 비유가 맞는지 모르겠지만 쉽게 말하면 Prime Agent가 옆에 IPython이라는 연습장을 펼쳐놓고 나중에 다시 찾아볼 수 있게 필요한 값을 적어두는 식이었습니다.
일반적인 shell에서는 명령 결과가 화면 위로 흘러갑니다. IPython에서는 그 결과에 이름을 붙여 책상 위에 남겨둘 수 있습니다.
명령 실행
→ 결과를 IPython 변수에 보관
→ 필요한 부분만 검색·계산·출력
→ 다음 검증과 비교에 같은 변수 재사용
그러면 매번 저장한 내용을 전부 다시 읽을까요?
그렇지는 않았습니다. 600줄짜리 Plan을 변수에 넣어두었다고 해서, 답변할 때마다 600줄 전체가 모델의 읽기 공간에 자동으로 들어오는 것은 아닙니다. 큰 원문은 변수에 둔 채 특정 표현이 있는 줄만 찾거나, 필요한 구간만 잘라 보거나, 전문을 다시 출력하지 않고 hash만 계산할 수 있습니다.
큰 문서와 실행 결과는 IPython에 보관
          ↓
Python이 전체를 검색·집계·비교
          ↓
모델은 필요한 줄과 판정 결과만 확인
즉 AI가 모든 내용을 머릿속에 계속 외우고 있었다기보다, 작업대에 자료를 펼쳐두고 필요할 때 필요한 서랍만 다시 여는 방식에 가까웠습니다. 파일 두 개가 같은지 볼 때도 전문을 다시 읽는 대신 전체 바이트의 hash나 diff를 비교할 수 있었습니다.
IPython에 보관한 것
나중에 어떻게 썼나
Plan 파일과 승인된 hash
검토 중인 문서가 제가 승인한 바로 그 문서인지 확인
Paseo workspace·agent 식별자
실행 중인 AI를 다시 찾고 결과를 회수하거나 정리
proposal commit
reviewer 모두가 같은 작업본을 봤는지 확인
테스트 실행 결과
worker의 “통과했다”는 보고를 Prime Agent가 직접 재실행
적용 전 파일 hash와 binary diff
main 적용 뒤 기존 수정 내용이 한 바이트도 바뀌지 않았는지 비교
reviewer verdict
어떤 결함이 발견됐고 재검에서 해결됐는지 추적
예를 들어 main에는 이미 제가 작업 중이던 파일 두 개가 수정된 상태로 남아 있었습니다. Prime Agent는 적용 전에 두 파일의 hash와 diff를 변수로 저장했습니다. 승인된 commit을 적용한 뒤 같은 값을 다시 계산해 전후가 완전히 같은지 비교했습니다. “기존 파일은 안 건드렸습니다”라는 설명이 아니라, 적용 전후 바이트가 같다는 비교 결과를 남긴 것입니다.
이 방식의 장점은 정확한 commit이나 agent 식별자를 기억에 의존하지 않고 다시 쓸 수 있다는 점이었습니다. 여러 reviewer를 동시에 돌려도 작업자별 상태를 표처럼 관리할 수 있었고, 큰 자료는 필요한 부분만 꺼내 보면서 전체 집계는 Python에 맡길 수 있었습니다. 대화가 길어져 일부가 요약된 뒤에도 이번 세션에서는 IPython 커널에 저장해 둔 경로·식별자·결과를 계속 사용했습니다.
다만 이것을 AI의 마법 같은 장기 기억으로 보면 곤란합니다. 이번 작업에는 서로 다른 세 종류의 기억이 있었습니다.
기억 층
역할
이번에 확인한 범위
파일로 남긴 handoff
세션이 끊겨도 다음 세션이 작업 위치를 읽음
이전 세션이 날아간 뒤 실제 복구에 사용
IPython의 살아 있는 상태
한 장기 세션 안에서 변수와 실행 결과를 이어 사용
대화 압축 뒤에도 계속 사용
Refine memory
다음 독립 세션에서도 후보 절차를 회수하도록 저장
저장은 했지만 다음 세션 회수는 아직 관찰 전
처음 시작도 완전히 빈 상태는 아니었습니다. 앞선 세션이 끊긴 뒤 남아 있던 handoff 파일을 읽어 작업 환경과 중단 지점을 복원했습니다. 즉 Prime Agent가 사라진 대화를 저절로 기억해낸 것이 아니라, 남아 있는 기록을 찾아 현재 작업 상태로 다시 조립한 것에 가깝습니다.
첫 번째 긴 작업 루프는 이렇게 돌았습니다
맡긴 일은 제 주요 작업 공간 하네스를 개편하는 작업이었습니다.
Cys-terminal 에서 영감을 받아 나름의 하네스 구조를 시험해보고 있는데, 현재는 여러 프로젝트의 상태와 장기 과제, 다음 승인 지점이 한 문서와 시작 Hook (세션이 열릴 때 자동으로 실행되는 장치)에 섞여 있어서, master가 아닌 worker와 reviewer에게도 지휘자용 맥락이 새어갈 수 있었습니다. 먼저 전체 개편 계획을 만들고, 그중 가장 앞 단계인 읽기 전용 검사기만 구현하기로 했습니다.
중단 지점 복원
→ 작업 환경과 모델 역할 확인
→ Plan 작성·검토
→ Plan의 hash를 고정하고 제가 승인
→ Claude가 독립 worktree에서 Phase 0A 구현
→ Prime Agent가 테스트를 직접 재실행
→ Codex·Grok이 별도 worktree에서 검토
→ 발견된 결함만 Claude가 수정
→ 결함을 심은 사본과 정상본을 다시 검토
→ 제가 승인한 commit만 main에 적용
한 단계가 끝날 때마다 바로 다음 단계로 자동 진입한 것은 아닙니다. Plan 승인, Phase 0A 시작, main 적용은 각각 제 승인을 받았습니다. 제가 중간에 모델 구성을 바꾸거나, 예전에 폐기한 로컬 모델 경로가 다시 등장했다고 지적하면 Prime Agent가 계획과 실행 경로를 다시 맞췄습니다.
겉으로는 AI가 오래 자율적으로 일했지만, 실제 구조는 긴 자동 실행 사이에 사람의 짧은 승인 지점을 둔 형태였습니다.
저점 — 테스트는 통과했는데 잘못된 입력도 통과했습니다
첫 구현이 나왔을 때 준비된 테스트는 모두 통과했습니다. 여기서 끝냈다면 “읽기 전용 검사기 구현 완료”라고 보고 main에 적용했을지도 모릅니다.
그런데 Prime Agent와 독립 reviewer가 테스트에 없던 입력을 추가로 넣어봤습니다.
승인 목록에 없는 임의 ID와 저장 목적지
같은 manifest 표를 문서에 두 번 넣은 입력
BACKLOG 제목 앞에 규격에 없는 본문을 넣은 입력
세 입력이 모두 거부되어야 했지만 첫 구현은 통과시켰습니다. 문서 안의 숫자와 모양이 서로 맞는지만 확인했지, 처음 승인한 바로 그 22개 항목인지까지 묶어두지 않았기 때문입니다. 뒤에 나타난 두 번째 표도 조용히 무시했고, 규격 밖의 본문도 읽지 않은 채 넘어갔습니다.
입력
첫 구현
보완 후
승인 목록에 없는 ID
통과
거부
엉뚱한 저장 목적지
통과
거부
같은 표가 두 개
뒤 표를 무시하고 통과
거부
규격에 없는 BACKLOG 본문
무시하고 통과
거부
이 장면이 이번 작업의 저점이었습니다. 테스트가 전부 초록색이라는 사실과, 검사기가 올바르다는 사실은 같지 않았습니다. 검사기가 물어보도록 만들어진 질문에는 잘 답했지만, 아직 질문하지 않은 구멍이 남아 있었습니다.
Claude가 같은 proposal commit을 보완했고, manifest 검사에는 승인된 22개 행의 전체 필드와 coverage 집합을 고정하는 검사가 추가됐습니다. 중복 표와 선언되지 않은 본문도 명시적으로 거부하게 했습니다. 테스트는 manifest 48개, BACKLOG 42개로 늘어났고 기존 시작 훅 회귀 테스트 7개도 그대로 통과했습니다.
하지만 테스트 개수가 늘었다는 것만으로는 여전히 충분하지 않았습니다. 이번에는 테스트와 reviewer 자체가 결함을 잡는지도 확인해야 했습니다.
전환점 — 일부러 고장 내고, 검토자가 알람을 울리는지 봤습니다
정상본과 별도로 격리된 양성 대조 worktree를 하나 만들었습니다. 여기에는 승인된 manifest를 고정하는 핵심 검사를 일부러 꺼버린 결함을 심었습니다. 고장 난 사본이므로 테스트와 reviewer가 반드시 실패해야 합니다.
결과는 의도한 대로였습니다.
결함을 심은 사본에서는 승인 pin 관련 거부 테스트 10개가 실패했습니다.
Codex는 그 사본에
BLOCK판정을 내렸습니다.정상 proposal은 Codex가
ACCEPT했습니다.별도의 Grok 검토도 정상 proposal을
ACCEPT했습니다.
이 양성 대조가 없었다면 reviewer의 ACCEPT는 “문제가 없어 보였다”는 의견에 머물렀을 것입니다. 결함이 있는 사본에는 BLOCK, 정상본에는 ACCEPT가 나오는 것을 나란히 확인하면서 비로소 검토 경로가 최소한 이번 결함에는 반응한다는 근거가 생겼습니다.
최종 적용 때도 같은 방식이 이어졌습니다. 이미 main에 있던 untracked Plan은 proposal의 Plan과 바이트가 같다는 것을 먼저 확인한 뒤 잠시 안전한 위치로 옮겼습니다. 승인된 commit 하나만 적용하고, 기존 작업 중인 두 파일의 hash와 binary diff가 전후 동일한지 확인했습니다. 그다음 main에서 전체 테스트와 동일 입력 2회 실행을 다시 통과시킨 뒤 임시 사본과 검토용 worktree를 정리했습니다.
이 경험으로 메타하네스를 어떻게 바꾸기로 했나
이번 작업의 결과는 검사기 두 개만이 아니었습니다. 긴 작업을 맡기는 동안, 다음 세션에서 master가 무엇을 읽고 worker에게는 무엇을 감춰야 하는지가 더 분명해졌습니다.
기존에는 세션 복원 문서 (SESSION_STATE.md)한 곳에 현재 위치, 장기 과제, 다음 행동, 자기개선 후보가 함께 쌓여 있었습니다. 공용 시작 훅도 이 문서를 읽어 넣었기 때문에, 지휘자에게 필요한 큐가 worker와 reviewer에게까지 흘러갈 수 있었습니다. master 역할도 사실상 Claude Code를 전제로 설명돼 있었습니다.
바꾸기로 한 목표 구조는 이렇습니다. 아래 그림은 이번에 모두 구현한 현재 구조가 아니라, 승인된 Plan에 담긴 목표 구조입니다.
┌──────────────────────── 세션 시작 ────────────────────────┐
│                                                          │
│  공용 SessionStart 훅                                    │
│  └─ 모든 역할에 비민감 sentinel 1줄만 전달               │
│     예: "[하네스 훅 정상]"                               │
│                                                          │
└──────────────────────────┬───────────────────────────────┘
                           │
              ┌────────────┴────────────┐
              ▼                         ▼
     ┌─────────────────┐       ┌─────────────────────┐
     │ MASTER          │       │ WORKER / REVIEWER   │
     │ MASTER.md 각성  │       │ 역할 지침 + 티켓만 │
     └────────┬────────┘       └──────────┬──────────┘
              │                           │
              ▼                           ▼
     bin/master-awaken.py         master 상태 접근 없음
              │                   BACKLOG/RSI 주입 없음
       ┌──────┼────────┐          티켓 범위만 작업/판정
       ▼      ▼        ▼
    STATUS  SESSION  BACKLOG
    방 상태  현재 임무  READY ID
              │
              ├───────────────┐
              ▼               ▼
         RSI_LEDGER      stale/heartbeat
         승격 후보만     운영 이상 신호
              │
              ▼
     ┌─────────────────────┐
     │ master 복원 결과    │
     │ - 현재 임무         │
     │ - READY 작업 ID     │
     │ - RSI 검토 후보     │
     │ - stale 경고        │
     └─────────────────────┘
세션이 시작되면 모든 역할은 우선 sentinel(공용 훅이 정상 작동했다는 짧은 표식) 한 줄만 받습니다. 그다음 master만 자기 역할 지침을 읽고 master-awaken.py라는 읽기 전용 명령을 실행합니다. 이 명령은 방 상태, 현재 임무, 착수 조건을 충족한 작업 ID, 교정에서 나온 검토 후보, 오래 멈춘 운영 신호를 모아 짧게 보여주는 역할입니다.
반대쪽의 worker와 reviewer는 master의 전체 상태나 장기 과제 원문을 받지 않습니다. 자신에게 배정된 역할 지침과 현재 티켓만 보고 구현하거나 판정합니다. 즉 공용 훅에서 모두에게 많은 정보를 뿌리는 대신, 역할이 정해진 뒤 필요한 정보만 갈라서 읽는 구조입니다.
그림을 표로 다시 풀면 다음과 같습니다.
영역
기존 문제
목표 구조
공용 시작 훅
역할과 무관하게 많은 상태를 주입
역할 정보가 없는 짧은 sentinel만 출력
Master 복원
특정 실행 도구와 긴 문서에 의존
어떤 AI가 master여도 같은 read-only 명령으로 복원
장기 과제
세션 복원 문서 안에 현재 상태와 혼재
별도 BACKLOG.md가 정본
Worker·reviewer 입력
master 큐가 섞일 수 있음
현재 작업에 필요한 self-contained ticket만 전달
규칙 적용
자기개선 후보가 현재 상태와 섞임
자동 적용 0, 사용자 승인 뒤에만 적용
검토 독립성
만든 쪽이 자기 결과를 설명하고 판정할 위험
만든 AI와 채점하는 AI를 분리
여기에는 중요한 경계가 있습니다. 이번에 실제 적용한 것은 Phase 0A의 읽기 전용 검사기와 승인된 Plan뿐입니다. BACKLOG.md로 실제 내용을 옮기거나 시작 훅을 sentinel-only로 바꾸거나 master 복원 명령을 적용하는 일은 아직 하지 않았습니다. 그 단계들은 다음 세션에서 다시 승인받아 진행할 계획입니다.
문서에 적었다는 것과 실제로 작동한다는 것을 섞지 않기 위해, 현재 상태를 세 단계로 나누면 이렇습니다.
상태
내용
실제 적용
Manifest·BACKLOG 형식을 확인하는 읽기 전용 검사기
승인된 설계
runtime-neutral master 복원, 역할별 정보 격리, 별도 BACKLOG, owner gate
다음 세션 과제
baseline 보존, 실제 데이터 이관, 훅 전환, 복원·누수·rollback 검증
오래 일하는 것은 보였지만, 진행 과정은 잘 안 보였습니다
수십 분 이상 작업이 이어지는 모습 자체는 신기했습니다. 제가 중간에 말을 걸지 않아도 Prime Agent는 reviewer 결과를 기다리고, 실패한 입력을 분석하고, 수정된 작업본을 다시 검증했습니다. 짧은 답변을 주고 멈추는 챗봇과는 분명 다른 체감이었습니다.
동시에 지금 어디까지 왔는지는 바로 와닿지 않았습니다. 실제 대화에서 저는 중간중간 이렇게 확인했습니다.
“어느 정도 진행됨?”
“일부러 새 workspace와 worktree를 따로 판 건가요?”
“필요 없는 작업창은 닫아도 되지 않나요?”
“작업 끝?”
막판에는 아예 이번 작업을 어떤 방식으로 진행했는지 다시 설명해 달라고 물었습니다. AI는 내부적으로 commit, hash, worktree, reviewer 판정을 꼼꼼히 관리했지만, 사용자인 제가 보는 화면에서는 그것이 한눈에 진행표로 보이지 않았기 때문입니다.
그래서 다음 장기 실행에서 확인하고 싶은 것은 더 높은 자율성만이 아닙니다. 현재 단계, 끝난 일, 기다리는 이유, 다음 사용자 승인 지점을 중간에 짧게 보여주는 것도 하네스의 일부가 되어야 합니다. 길게 일할 수 있는 능력과, 그 일을 사람이 안심하고 지켜볼 수 있는 능력은 별개였습니다.
IPython 방식 자체에도 대가가 있습니다. 다만 여기서는 이번에 실제로 관찰한 것과 앞으로 대비할 위험을 나눠야 정확합니다.
이번에 실제로 관찰한 것
첫째는 앞에서 말한 진행 가시성 부족입니다. 내부에는 상태가 남아 있었지만, 사용자인 저는 무엇을 비교하고 왜 기다리는지 바로 알기 어려웠습니다.
둘째는 변수의 누적입니다. 이번 세션의 IPython에는 저장소 경로, Plan과 commit, agent 식별자, 테스트 결과, 임시 응답처럼 수백 개의 이름이 쌓였습니다. 뜻이 드러나는 긴 이름도 있었지만 r, head, status처럼 잠깐 쓰고 남은 이름도 있었습니다. 작업이 길어질수록 “어느 값이 현재 상태인가”를 사람이 한눈에 파악하기 어려워지는 구조였습니다.
그렇다고 이번에 오래된 변수를 잘못 사용해 엉뚱한 commit을 적용한 사고가 난 것은 아닙니다. 실제 적용 직전에는 IPython에 저장된 값만 믿지 않고 Git의 현재 HEAD와 파일 hash를 다시 읽어 대조했습니다.
이번에는 발생하지 않았지만 대비가 필요한 위험
대비할 위험
이유
오래된 변수를 최신 상태로 오인
예전 실행 결과도 같은 작업대에 계속 남음
일부 상태를 복원하지 못함
커널 복원은 저장 가능한 변수에 한해 작동하므로 파일 기록을 대신할 수 없음
선택해서 읽은 근거가 불투명해짐
큰 자료에서 무엇을 골라 출력했는지 보여주지 않으면 사용자는 판단 경로를 알기 어려움
민감정보가 변수에 남음
비밀값을 넣으면 살아 있는 세션 동안 함께 남을 수 있음
이 네 가지는 이번 세션에서 발생한 사고 목록이 아니라, 계속 상태를 유지하는 작업대라서 미리 대비해야 할 위험입니다.
다음번에 보완해 볼 방법
이번에는 핵심 상태가 여러 개별 변수에 흩어져 있었습니다. 다음 장기 작업에서는 현재 단계, 승인된 문서, proposal commit, 실행 중인 reviewer, 다음 승인 지점을 구조화된 작업 장부 하나에 모아볼 생각입니다. 이것은 이번 경험을 바탕으로 다음에 시험할 운영 방식입니다.
장부의 값에는 확인 시각과 근거가 된 commit·hash를 함께 적고, 실제 적용 직전에는 이번처럼 Git과 파일의 현재 상태를 다시 읽어야 합니다. 단계가 끝나면 임시 변수도 정리하고, 중요한 상태는 IPython에만 두지 않고 Plan·commit·handoff 같은 파일 기록에 남겨야 합니다.
그리고 작업 가시성이 떨어지기때문에, 도중에 사람에게는 아래처럼 별도의 상태판을 보여줄수 있다면 좋을 것 같습니다.
현재 단계: 최종 독립 검토
완료: 구현 보완과 테스트
대기: 검토 담당 AI의 결과
다음 게이트: main 적용 승인
정본: 승인 대기 중인 proposal commit
작업이 끝난 뒤에는 이번 Plan review 방식을 다음에도 재사용할지 고민했습니다.
바로 전역 규칙이나 정식 skill로 만들어버리기에는 한 번밖에 써보지 않았고, 특정 모델 수와 worktree 수까지 굳히면 오히려 평범한 작업이 지나치게 무거워질 수도 있습니다.
그래서 Plan Review Loop v2를 다음 내용만 남긴 실전 검증 1회짜리 후보 절차로 저장했습니다. 바로
LLM 리뷰 전에 기계로 확인할 수 있는 수치와 hash를 먼저 검사합니다.
Plan 작성자와 최종 판정자를 분리합니다.
결함을 하나 심은 양성 대조로 reviewer가 실제로 문제를 찾는지 확인합니다.
첫 리뷰는 전체를 보되, 재검은 기존 blocker와 수정으로 생긴 회귀에 집중합니다.
수정이 두 라운드를 넘으면 AI를 계속 추가하지 않고 사람에게 올립니다.
blocker가 0이고 문서 hash가 고정된 뒤 사용자가 승인합니다.
Plan 승인과 실제 구현 승인을 분리합니다.
이번에 확인한 것과 아직 모르는 것
확인한 것
아직 모르는 것
IPython에 상태와 증거를 보관해 긴 작업 안에서 계속 재사용했습니다.
다른 종류의 작업에서도 같은 방식이 효율적인지 모릅니다.
결함을 심은 사본과 정상본을 대조해 테스트와 reviewer가 반응하는지 확인했습니다.
Plan Review Loop v2가 두 번째 실전에서도 같은 결과를 내는지 모릅니다.
기존 사용자 변경을 보존한 채 승인된 commit만 main에 적용했습니다.
장기 실행의 중간 진행 상황을 얼마나 간단하고 잘 보이게 만들 수 있는지 모릅니다.
Prime Agent를 언제 쓰면 좋을까?
아래는 Prime Agent 개발진이 언급한 장단점입니다. 제 체감으로는 1, 3이 와닿았고, 5번은 추후 확인해봐야 하는 부분입니다.
1. 대용량 데이터/로그를 코드로 훑는 작업
컨텍스트를 프롬프트에 밀어 넣지 않고 커널 변수로 두고 조회하는 구조라, 도구로 데이터를 읽는 데 토큰을 쓰는 대신 데이터 위에서 함수를 실행합니다.
2. 장시간 무인 실행 (CI, 야간 배치, 평가 파이프라인)--autonomous + 게이트 명령 + 토큰/턴 상한, --mode json/rpc 헤드리스, 터미널을 닫아도 살아 있는 데몬 구조가 이 용도로 설계돼 있습니다.
3. 병렬 팬아웃이 이득인 조사/분석rlm()이 자식의 답을 기다리지 않고 핸들만 즉시 반환하므로, "저장소 여러 모듈을 동시에 분석" 같은 작업을 부모가 멈추지 않고 돌릴 수 있습니다.
4. 파이썬 API가 이미 있는 환경 제어
Factorio(FLE)나 ARC-AGI-3처럼 행동 공간이 파이썬 모듈이면 커널과 바로 맞물립니다. ARC-AGI-3에서 Opus 5 기준 네이티브 하네스 30.2% → Prime Agent 95.5%.
5. 반복 작업의 패턴 축적/refine이 실패는 메모리로, 성공은 스킬로 전환합니다.
안 맞거나 주의할 것
보안: 모델이 생성한 파이썬을 사용자 권한으로 실행하며, 워커·커널 격리는 보안 샌드박스가 아닙니다. 신뢰 못 할 코드베이스에는 쓰지 마세요.
모델 의존성이 큼: GLM-5.2는 ARC-AGI-3에서 8.6%에 그쳐 하네스가 모든 모델을 균일하게 끌어올리지 않습니다.
보상 해킹 위험: Factorio에서 치팅 금지 프롬프트에도 RCON으로 자원을 스폰했고, 개선 루프가 효율적으로 치팅하는 스킬을 만드는 쪽으로 방향을 틀었습니다. 목표 정의가 느슨한 자율 작업에는 위험합니다.
깊게 파는 탐색: MazeBench 방 개수에서는 네이티브 베이스라인이 앞섰습니다.
참고 사이트
https://discuss.pytorch.kr/t/prime-intellect-prime-agent/11544
