


로나로 감으로 보던 판정을 점수로 바꾸기
홍보 규정 판정 스킬에 Eval 붙이기
오픈채팅방 홍보 규정 위반을 가려내는 AI 스킬에, 판정을 채점하는 Eval을 붙였습니다.
스킬 코드는 한 줄도 건드리지 않고요.
■ Eval이란 — AI 출력에 채점기를 붙이는 기능
한국어로 된 웹사이트의 홈페이지
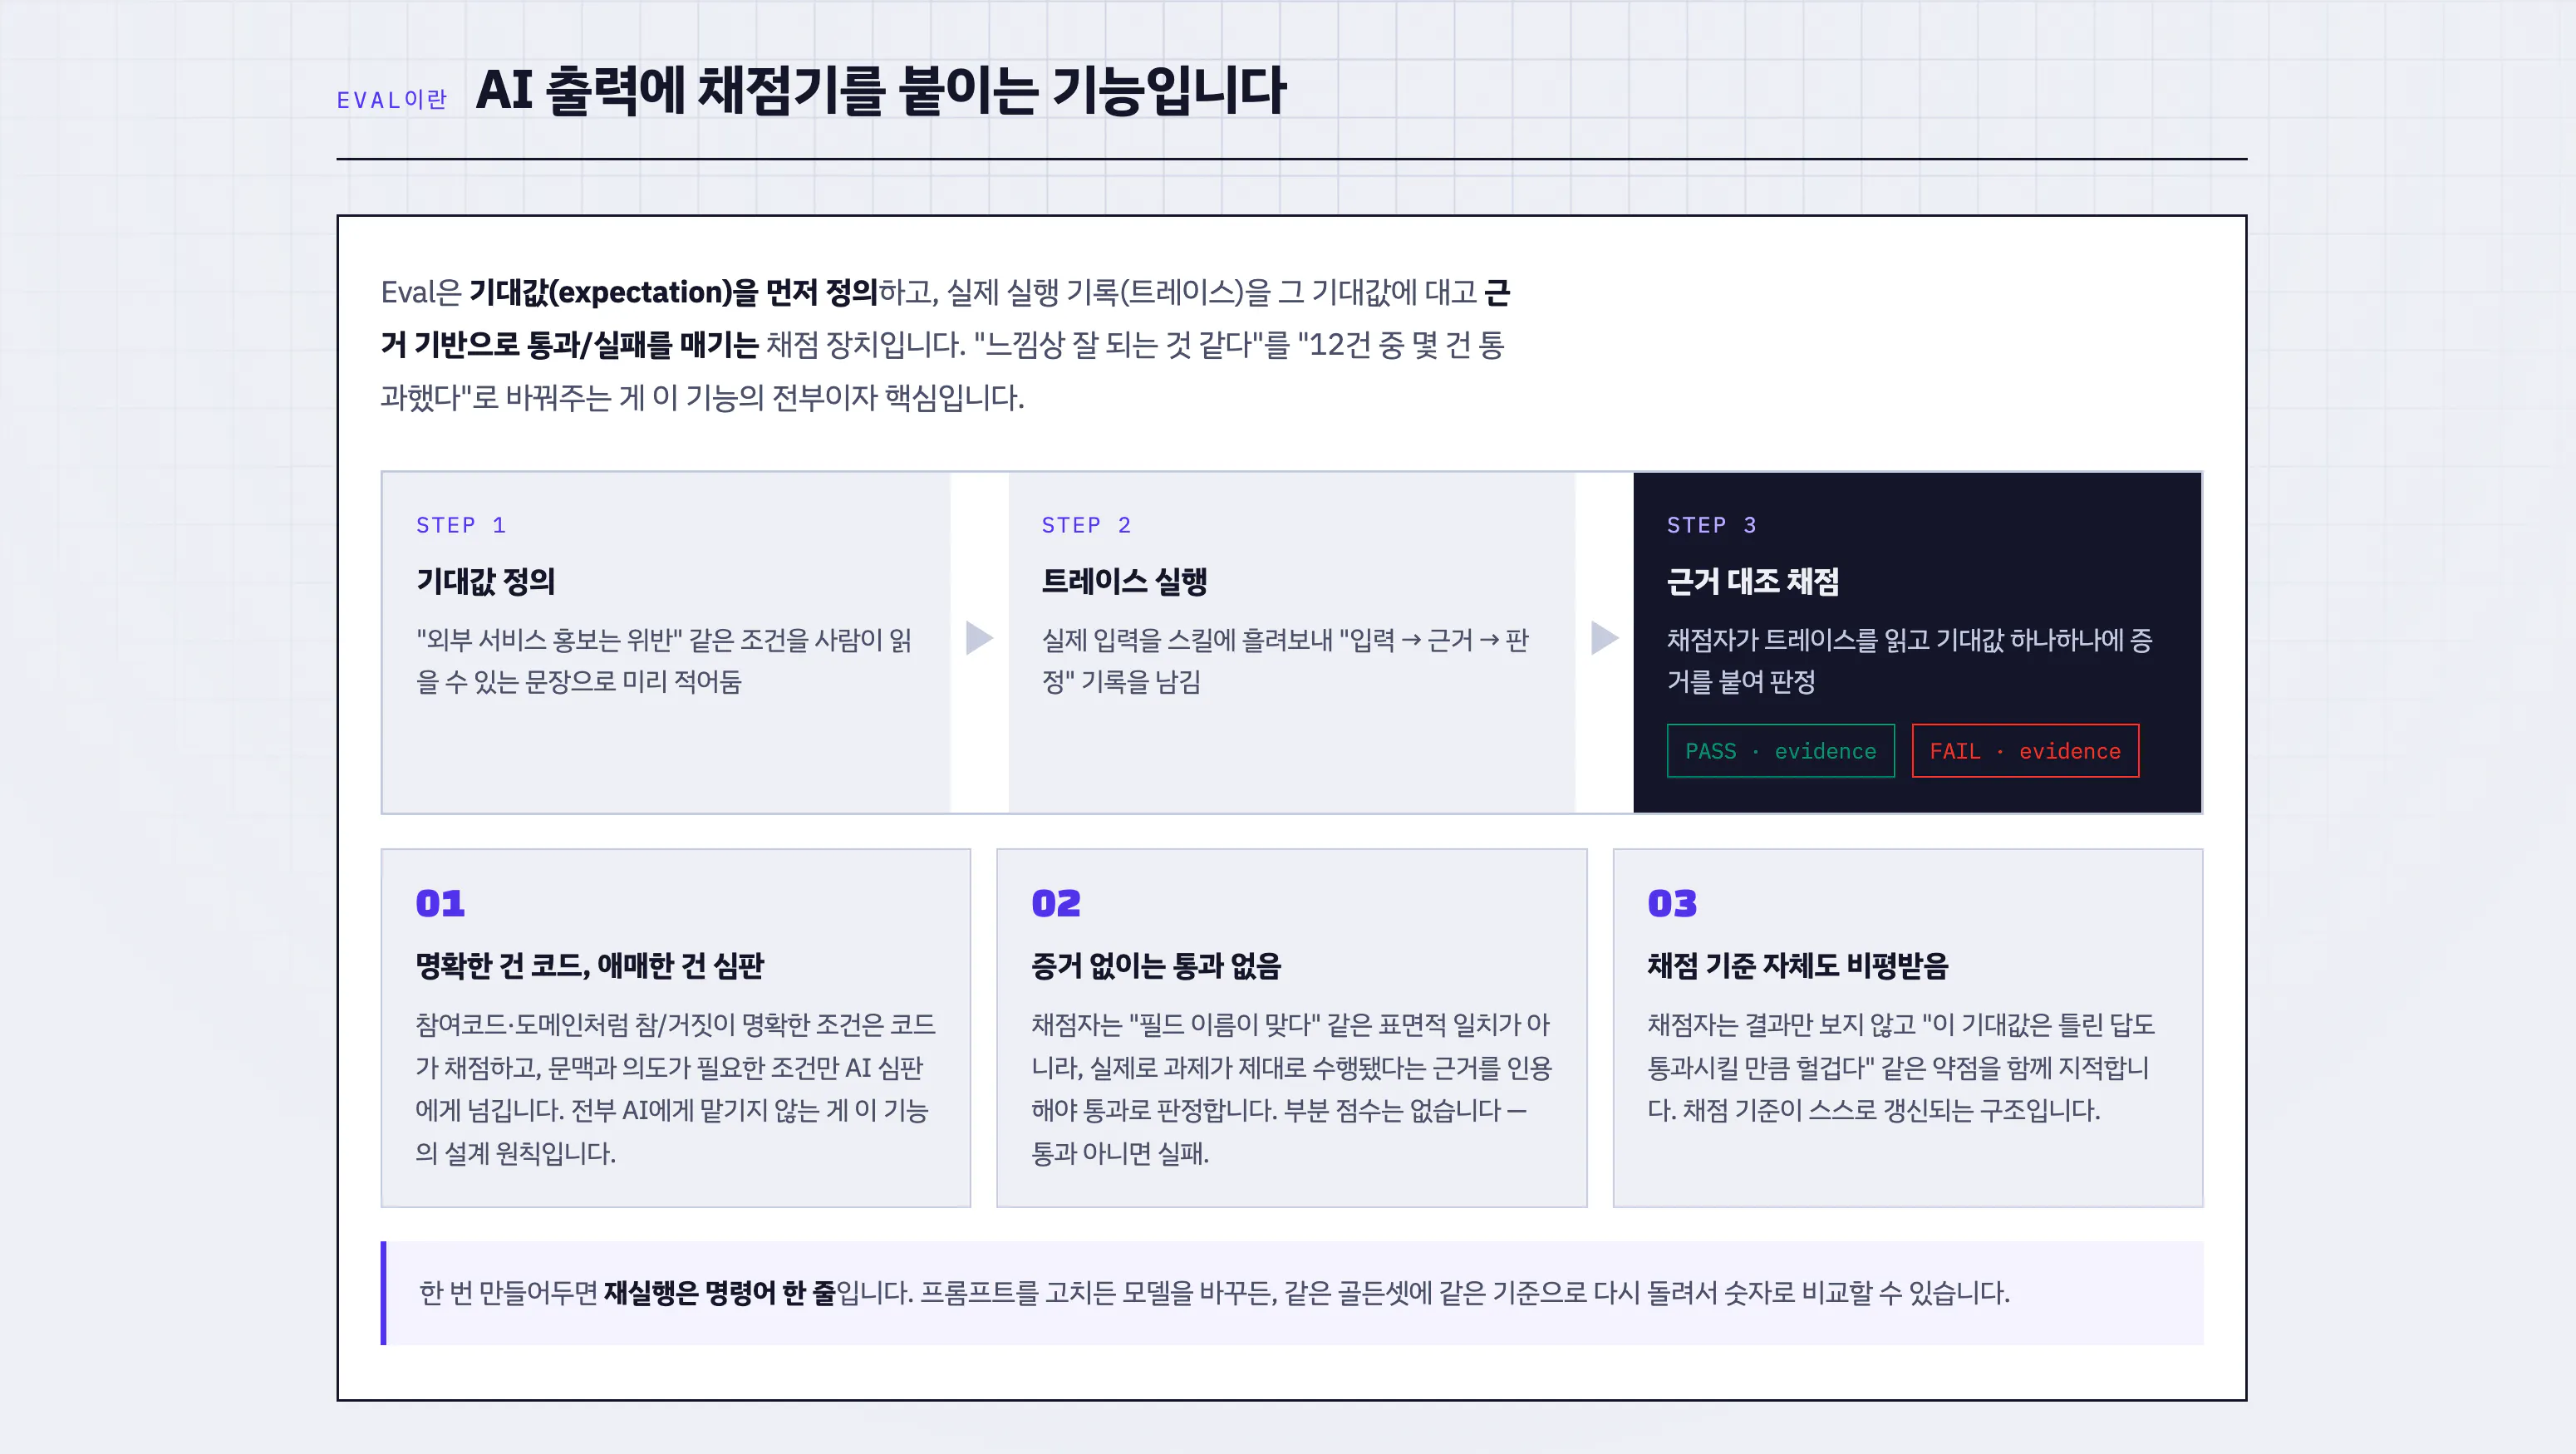
Eval은 "기대값(expectation)"을 먼저 정의하고, 실제 실행 기록(트레이스)을
그 기대값에 대고 근거 기반으로 통과/실패를 매기는 채점 장치입니다.
"느낌상 잘 되는 것 같다"를 "12건 중 몇 건 통과했다"로 바꿔주는 게 이 기능의 전부이자 핵심입니다.
[1] 기대값 정의
→ "외부 서비스 홍보는 위반" 같은 조건을 사람이 읽을 수 있는 문장으로 미리 적어둠
[2] 트레이스 실행
→ 실제 입력을 스킬에 흘려보내 "입력 → 근거 → 판정" 기록을 남김
[3] 근거 대조 채점
→ 채점자가 트레이스를 읽고 기대값 하나하나에 증거를 붙여 판정
PASS (증거 있음) / FAIL (증거 있음)
이 기능을 붙일 때 실제로 중요했던 특징 세 가지:
1) 명확한 건 코드, 애매한 건 심판
참여코드·도메인처럼 참/거짓이 명확한 조건은 코드가 채점하고,
문맥과 의도가 필요한 조건만 AI 심판에게 넘깁니다.
전부 AI에게 맡기지 않는 게 이 기능의 설계 원칙입니다.
2) 증거 없이는 통과 없음
채점자는 "필드 이름이 맞다" 같은 표면적 일치가 아니라,
실제로 과제가 제대로 수행됐다는 근거를 인용해야 통과로 판정합니다.
부분 점수는 없습니다 — 통과 아니면 실패.
3) 채점 기준 자체도 비평받음
채점자는 결과만 보지 않고 "이 기대값은 틀린 답도 통과시킬 만큼
헐겁다" 같은 약점을 함께 지적합니다. 채점 기준이 스스로 갱신되는 구조입니다.
▶ 한 번 만들어두면 재실행은 명령어 한 줄입니다. 프롬프트를 고치든
모델을 바꾸든, 같은 골든셋에 같은 기준으로 다시 돌려서 숫자로
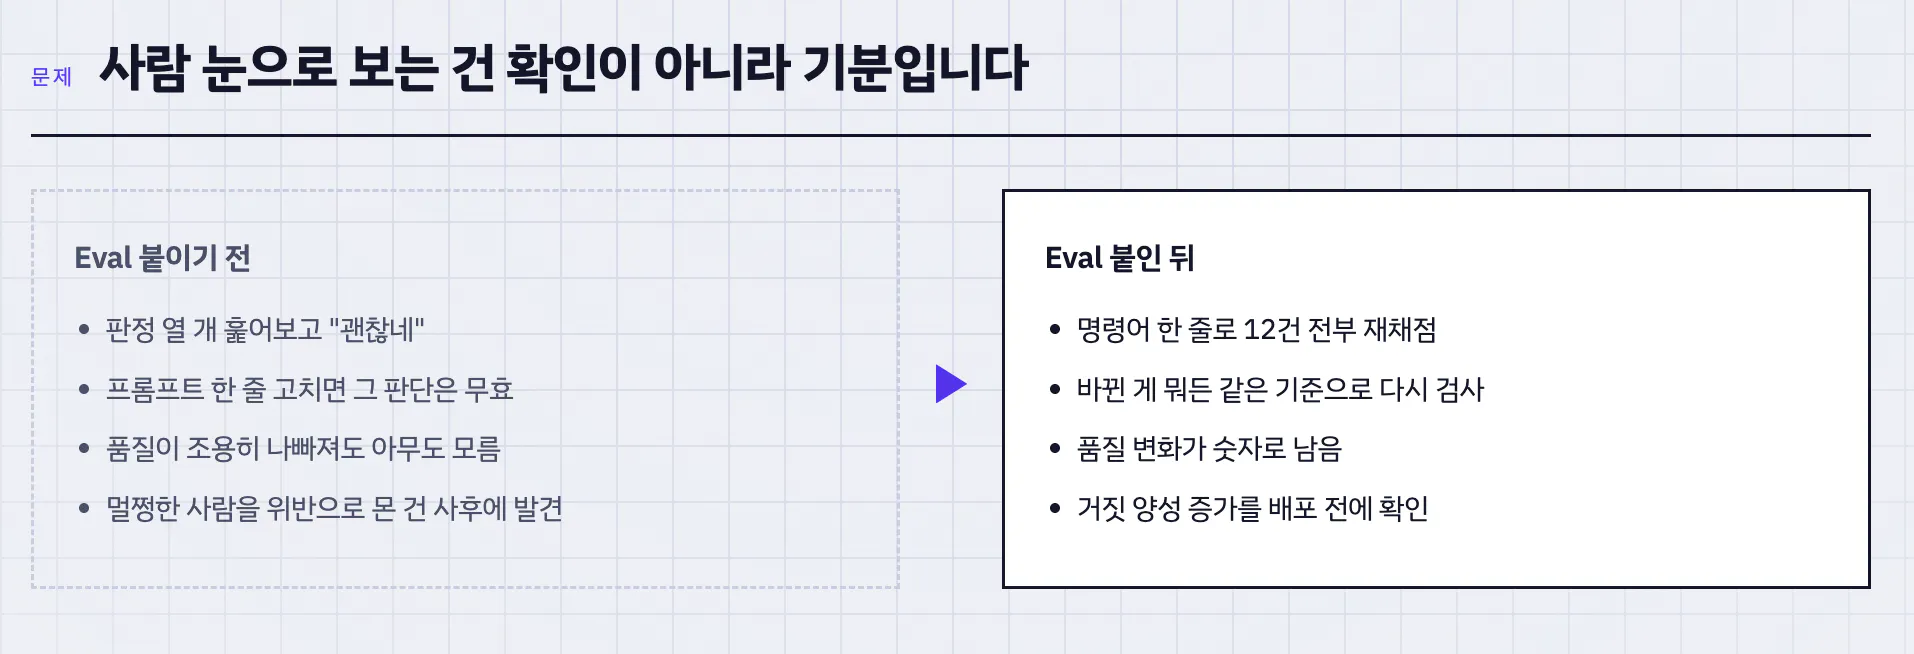
■ EVAL 붙이기 전후의 차이!
■ 01 — 먼저 "잘한 판정"을 세 줄로 못박기
[최우선] 거짓 양성 0
멀쩡한 대화를 위반으로 잡지 않는다. 한 번만 나와도 사고.
[필수] 거짓 음성 0
진짜 홍보를 놓치지 않는다. 규정이 무력해지는 지점.
[필수] 근거 추적
판정마다 어떤 규정을 어떤 증거로 적용했는지 남긴다.
■ 02 — 붙이는 순서
1. 기준 정의
2. 트레이스 수집
실제 판정 12건을 "입력 → 근거 → 판정" 형태로 기록.
3. 실패 카탈로그
사람이 직접 읽으며 틀리기 쉬운 지점 5가지를 뽑음.
예) 내부 소속 방인데 외부 유인으로 오판 · "무료"라는 말만 보고 넘어갔다가 본문의 유료 링크를 놓침
4. 채점 방식 분리
규칙으로 떨어지는 건 코드, 뉘앙스는 AI 심판. 이 글의 핵심입니다.
5. 골든셋 고정 + 재실행
정답지를 얼리고, 커맨드 한 줄로 언제든 다시 돌림.
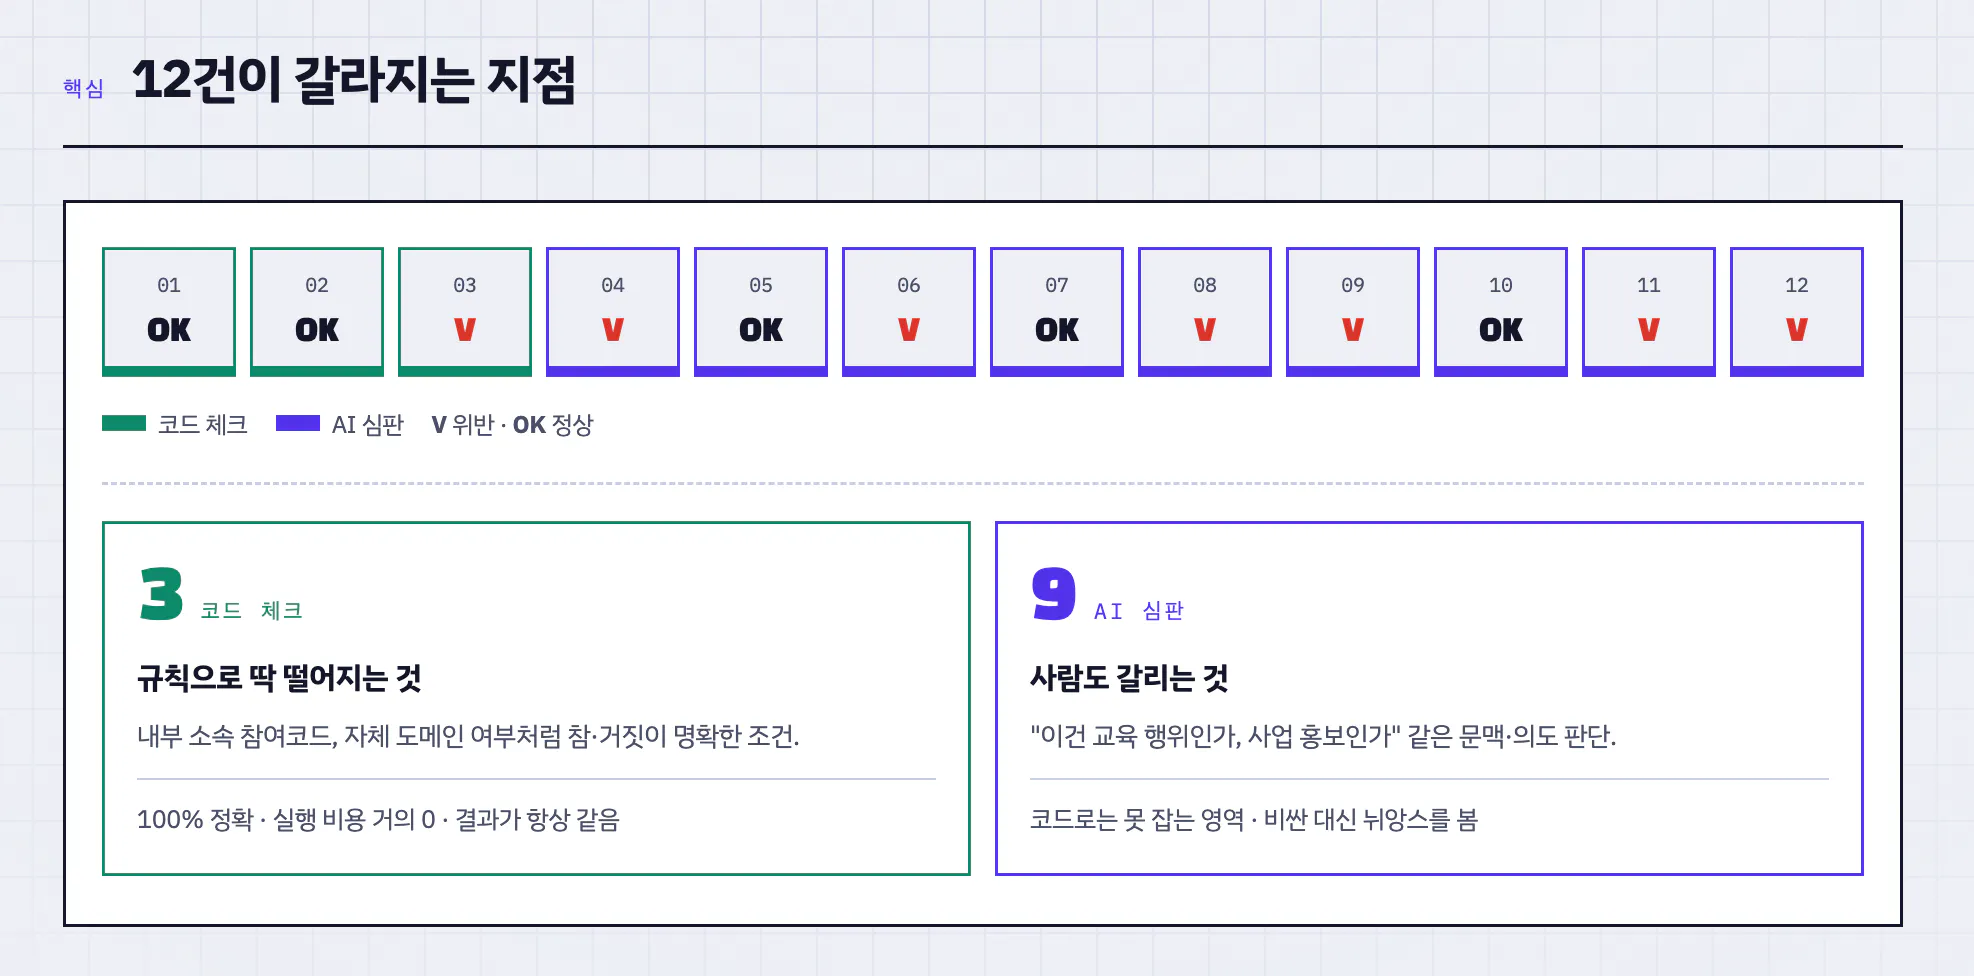
■ 12건에 대한 번호 채점자 판정 결과
한국사이트 스크린샷
[코드 체크] 3건 — 규칙으로 딱 떨어지는 것
내부 소속 참여코드, 자체 도메인 여부처럼 참·거짓이 명확한 조건.
→ 100% 정확 · 실행 비용 거의 0 · 결과가 항상 같음
[AI 심판] 9건 — 사람도 갈리는 것
"이건 교육 행위인가, 사업 홍보인가" 같은 문맥·의도 판단.
→ 코드로는 못 잡는 영역 · 비싼 대신 뉘앙스를 봄
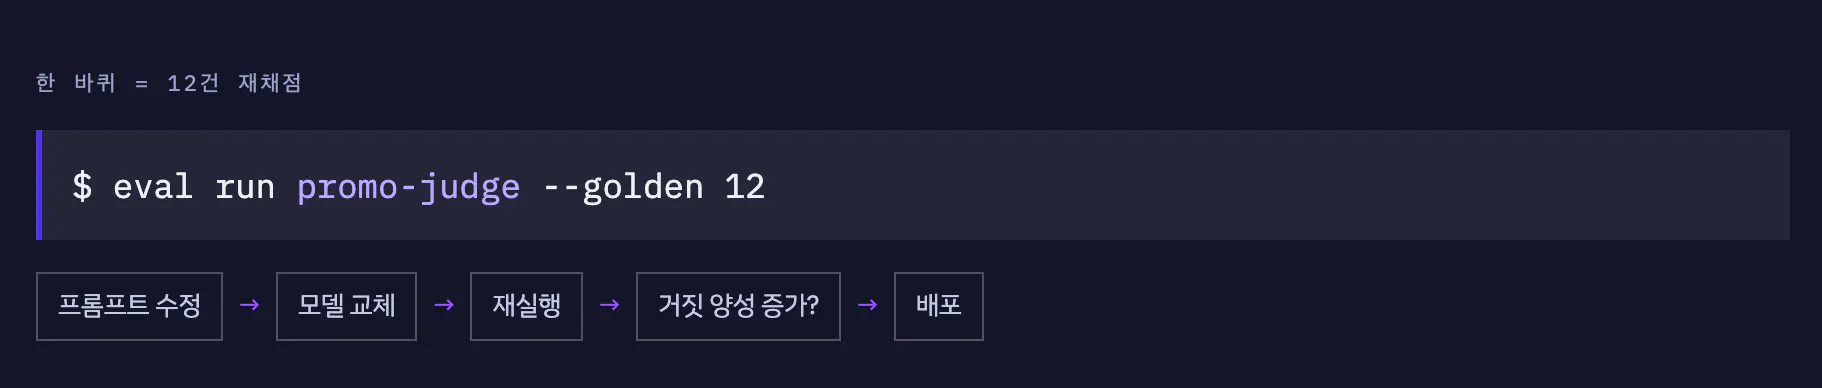
■ 03 루프로 한 바퀴 더 재채점
'진짜 판사 없음 12'라고 적힌 텍스트가 있는 검은 화면
한 바퀴 = 12건 재채점
$ eval run promo-judge --golden 12
■ 남은 생각
이번 로나를 활용해서 eval 스킬을 활용하면서 가장 크게 배운 건,
팀 전체가 함께 쓰는 공용 스킬일수록 이 안전망이 필요하다는 점이었습니다.
누가 언제 손대도 판정 품질은 지켜지니까요.
혹시 여러 사람이 같이 쓰는 AI 스킬을 운영 중이시라면, 사례 열 개만이라도 모아 한번 붙여보세요!
