비개발자 투자자가 자기 글의 7가지 실수를 잡는 AI 검수 skill을 설계한 1주일

2026.10.04
소개
유튜브 채널과 블로그를 운영하면서 책 집필, 재무제표 강의, 웹진 기고, 페이스북 칼럼까지 월 50편 넘는 글을 쓰고 있습니다. 글을 써주는 Claude는 점점 똑똑해졌지만, 발행 직전 검수는 늘 손으로 했습니다.
문제는 2026년 8월에 터졌습니다.
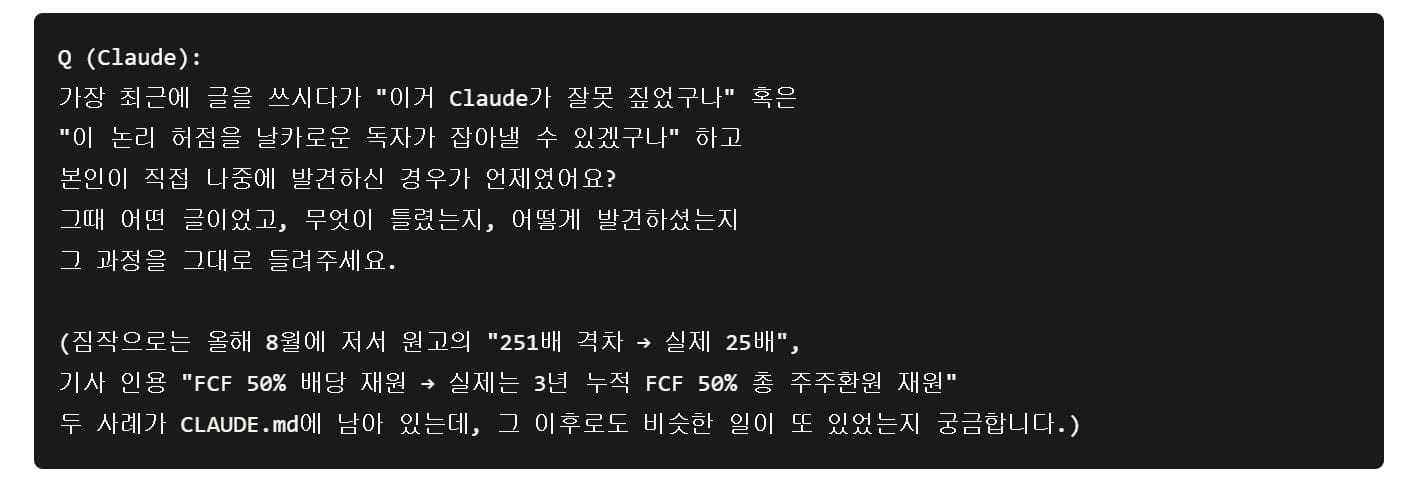
저서 원고에서 "A기업과 B기업의 격차 251배"라고 썼는데, 실제로 다시 나눠보니 25배였습니다. Claude가 계산 실수를 했고 저는 그걸 그대로 옮겨 썼습니다.
웹진 기고문에서 "FCF 50%를 배당 재원으로 쓴다"고 인용했는데, 회사 공식 정책은 "3년 누적 FCF 50%를 배당, 자사주 매입, 소각 포함 총 주주환원 재원으로 쓴다"였습니다. 인용 원문의 맥락이 완전히 달랐습니다.
강의자료를 만들 때 스캔 PDF의 OCR 깨진 부분을 Claude가 "말이 되는 문장"으로 매끄럽게 지어서 메꿔버렸습니다. 강의 중에 책이랑 비교하다가 뒤늦게 발견했습니다.
"Claude가 다 해주겠지"로 넘기면 안 되는 결들이 있고, 그걸 발행 전에 한 번에 걸러낼 전역 검수 창구가 필요하다는 결론에 이르렀습니다. 지피터스 24기 미션01 1주차 과제가 마침 "코드보다 인터뷰가 먼저 — 설계문서 1장"이어서, 이걸 그대로 제 검수 서비스 설계에 쏟아 넣어보기로 했습니다.
진행 방법
사용 도구: Claude Code 데스크톱 앱 + gatekit skill (지피터스 24기 수업에서 소개된 설계 파이프라인)
gatekit은 "뭘 만들지 발굴 → 인터뷰로 PRD 짜기 → 작업 분해 → 검수 기준 정하기 → 빌드 → 검증"의 7단계 skill 세트입니다. 1주차는 그중 앞 두 단계(/gatekit-discover + /gatekit-interview)를 돌리는 것이 과제입니다.
1단계 — 환경 준비 (/gatekit-setup)
Claude Code 세션을 열자마자 환경 점검을 돌렸습니다. PowerShell 7과 Python 가상환경이 없다는 결과가 나왔고, 채팅창에서 하나씩 허락을 받아 설치했습니다. 중요했던 점: "권한 창은 실행 허락이지, 설치 허락은 채팅에서 따로 묻는다" 는 원칙이 명확했습니다. 비개발자에게 특히 안심되는 설계였습니다.
2단계 — 발굴 (/gatekit-discover)
고정된 질문지가 아니라 자유 대화로 진행되었습니다. 저는 "내가 쓴 글들을 검수하는 서비스를 만들어보고 싶어요"로 시작했고, Claude는 "가장 최근에 직접 발견하신 Claude 실수가 뭐였어요?"로 되물었습니다.
대화를 따라가다 보니 처음 머릿속에 없었던 결들이 하나씩 튀어나왔습니다:
/gatekit-discover 내가 쓴 글들을 검수하는 서비스를 만들어보고 싶어요.
내 글은 주로 기업, 회계, 거버넌스 중심이에요.
해외 사례도 있지만 보통 전자공시 데이터를 많이 가져와요.
클로드가 실수하는 것들을 방지하고 논리적으로 허점이 있는 것인지,
날카로운 비판자의 입장에서도 지적할 게 크게 없는 글을 쓰고 싶습니다.
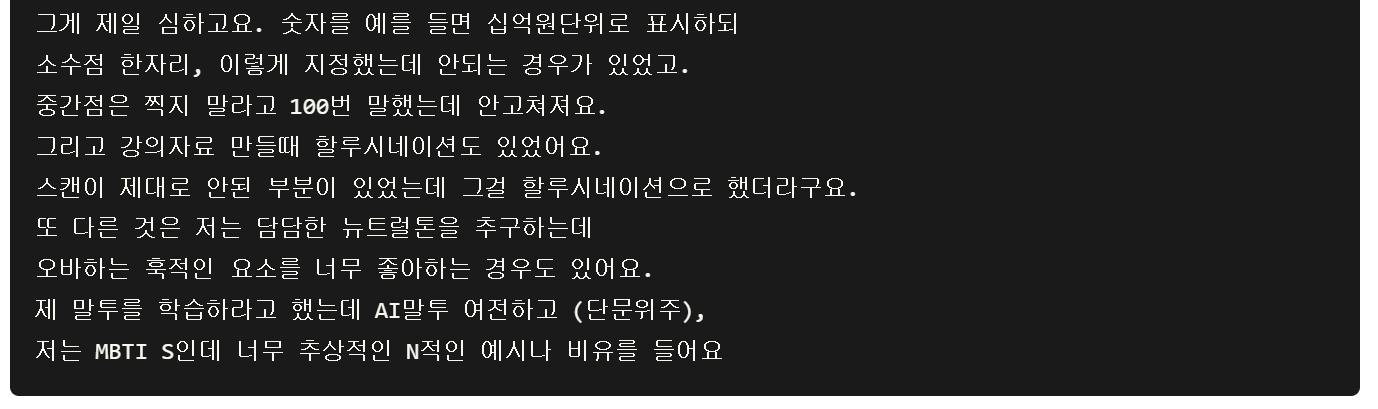
숫자 포맷("십억원 소수점 한자리") 지시 미준수
중간점(·) 금지 지시가 100번 말해도 안 지켜지는 것
OCR 깨진 부분을 Claude가 매끄럽게 지어 메꾸는 것
뉴트럴 톤 지시했는데 훅/오버 섞이는 것
단문과 복문 리듬이 사라지고 AI 단조로움만 남는 것
S 성향인데 추상적인 N적 비유가 들어오는 것
숫자 재검증 실패 2건
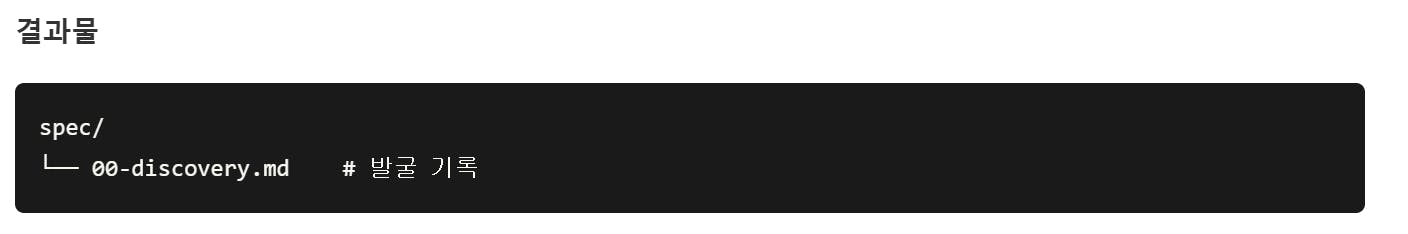
총 7결. Claude가 체크포인트에서 "이걸로 정리해도 될까요?"를 물었고, 저는 블로그, 강의, 버핏, 페북 각 채널의 월 발행 편수와 1편당 검수 시간까지 답한 뒤 종료했습니다. 결과는 spec/00-discovery.md로 저장되었고, 판단은 build(새로 만들기), 기한은 4주로 확정되었습니다.
3단계 — 인터뷰 (/gatekit-interview)
여기부터가 "역질문에 끝까지 답하기" 과제의 핵심이었습니다.
Claude의 역질문이 저도 생각 못 했던 결을 끌어냈습니다:
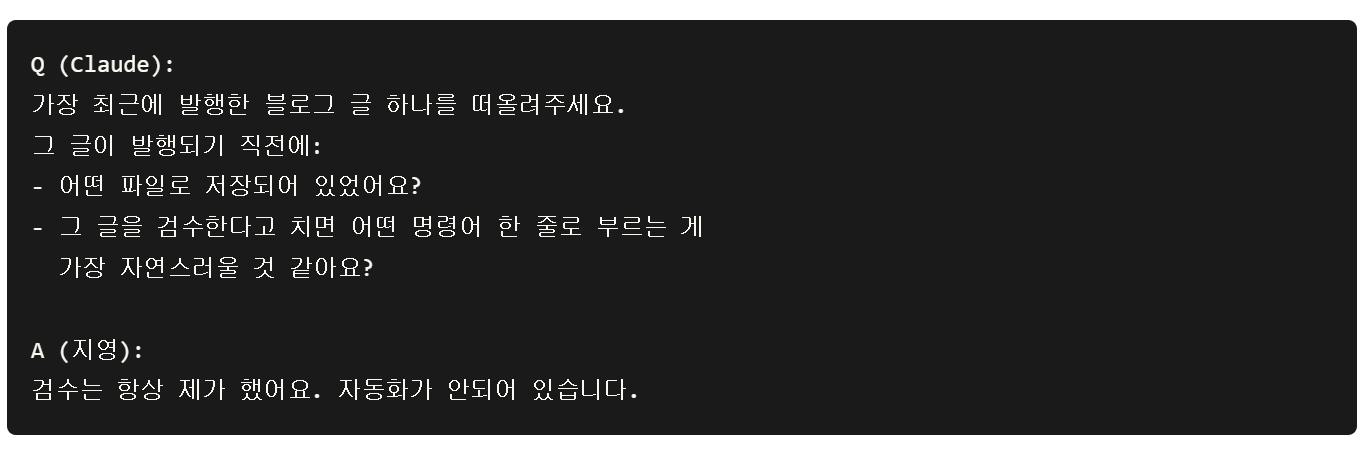
"지난번 editorial-stress-test 돌리실 때 글을 어떻게 넘기셨어요?" → "검수는 항상 제가 손으로 했어요. 자동화가 안 되어 있습니다" 를 깨닫게 됨
"책 원고는 어디에 있어요?" → claude.ai 웹 프로젝트와 Claude Code 사이의 경계 명확화
"숫자 재검증이 두 결로 보이는데..." → 내부 재계산(가)과 외부 원문 대조(나)의 구분
블로그 얘기 중에 "영문을 국문으로 번역하다 보니 한국에서 안 쓰는 용어들이 들어온다" 는 결이 추가로 떠올랐고, 이게 ⑩번 결이 됨
"논리의 비약 체크와 비판자의 시각으로 비판" 을 직접 추가 요청
마지막으로 Claude가 도메인 리서치(비슷한 AI 글 교정 도구들이 공통으로 다루는 결)를 돌려서 네 가지를 더 제안했고, 저는 전부 채택했습니다:
- A. 인용과 참조 검증 확장 (DART뿐 아니라 모든 인용으로)
- B. 창의적 표현과 의도된 선택 보호 (자동 치환 전 확인 — Grammarly의 "저자 voice 침해" 문제 예방)
- C. 가독성과 복잡도 정량 지표
- D. 한국어 맞춤법 체크
최종 10개 기능(F1~F10), 14결의 사고 패턴을 커버하는 PRD와 아키텍처 문서가 완성되었습니다. 결과는 spec/01-prd.md와 spec/03-architecture.md.
결정한 핵심 설계
호출 방식:
/final-review [파일경로]또는 그냥/final-review(되묻기)입력 포맷: .md, .html (1차) / .docx, .pptx (2차)
치명도 순 리포트: ⑦숫자 재검증 → ①숫자 포맷 → ③OCR 미독해 → ②중간점 → ⑩번역체 → ⑫맞춤법 → ⑧논리 비약 → ⑨비판자 시각 → ④뉴트럴 톤 → ⑤리듬 → ⑥추상도
AI 말투는 "특징 짚고 멈춤" — Claude가 "이 글의 AI 말투 특징은 ①②③…"을 먼저 짚고, 제가 "①③만 고쳐줘"로 선택
OCR 미독해는 플래그만 — 매끄럽게 메꾸지 말고 "여기 못 읽음" 플래그만, 수정은 수동
블로그는 범위 밖 — 전문가 파이널 터치가 필요한 영역이라 자동 검수 대상 제외
책 원고: claude.ai 웹 → 챕터 .md 다운로드 → 로컬 폴더 →
/final-review돌림DART MCP(k-dart)와 editorial-stress-test skill 재사용
결과와 배운 점
나온 결과물
spec/00-discovery.md— 발굴 기록, pain 3개(1개 선택)spec/01-prd.md— 10개 기능(F1~F10), 수용 기준, 가정 원장 7개 (블로킹 2개는 환경 확인으로 Confirmed)spec/03-architecture.md— Python 3.14 + Claude Code 전역 skill + k-dart MCP + editorial-stress-test 재사용spec validate통과 (아직 안 쓴 05-gate.md만 missing warn)
배운 점 1 — 자유 대화가 체크리스트보다 결을 더 잘 끌어낸다
처음에는 "검수 서비스" 한 줄로 시작했는데, 자유 대화로 가다 보니 번역체(⑩), 창의적 표현 보호(B), 논리 비약(⑧)과 비판자 시각(⑨) 추가 요청까지 자연스럽게 튀어나왔습니다. 고정 질문지였다면 "숫자, 톤, 논리" 3분법으로 끝났을 겁니다.
배운 점 2 — CLAUDE.md에 쌓인 과거 사고 기록이 인터뷰의 날을 세운다
제 CLAUDE.md에는 2026-08 사고 2건(저서 251/25배, FCF 50% 오역)이 "숫자 재검증" 섹션에 명시되어 있었습니다. Claude Code가 첫 질문부터 그걸 가져다 쓰면서 "이게 가장 심한 사고 맞죠?"로 바로 진입했습니다. 과거 사고를 memory에 기록해두면 다음 인터뷰가 저절로 깊어진다 는 걸 체감했습니다.
배운 점 3 — 역질문에 답할 때 "모른다"고 솔직히 답하면 설계가 정직해진다
Claude가 "블로그는 수동 검수가 맞다 하셨는데 세 가지 해석 중 어느 쪽이에요?"처럼 선택지를 주면 저는 "a, b, c 중 뭐가 맞는지 모르겠다"가 종종 솔직한 답이었습니다. 그걸 "가정 원장"에 올려두니(Blocking: n, Confirmed: n) 설계가 "지금 확정할 수 없는 것은 확정하지 않은 채로" 진행되었습니다. 이게 "가정 원장(확인 안 된 항목 목록)"의 진짜 쓸모였습니다.
배운 점 4 — 도메인 리서치가 "내가 놓친 기본기"를 짚어준다
"창의적 표현 보호(B)"는 제가 전혀 생각 못 한 결이었는데, Grammarly와 ProWritingAid 사용자 불만을 2건 이상 교차확인한 리서치가 "저자 voice 침해 문제"를 제안했습니다. 저도 "말투 학습해라"가 100번 안 통하는 걸 겪어왔던 터라 바로 받아들였고, 이게 F8로 들어가면서 "① 자동 치환"과 "② 저자 의도"가 충돌할 때의 확인 단계가 명확해졌습니다.
시행착오
처음에 "⑤ 단문 말투 학습 실패"라고 요약했는데 틀렸습니다. 저는 단문과 복문 섞인 리듬 있는 글체를 쓰는데, Claude가 단조롭게 단문만 쏟아내는 게 문제였습니다. "AI 말투 특징을 먼저 짚고 그걸 피하는 식으로 다시 쓰기"라는 흐름으로 수정 요청했고, 그게 F7의 핵심 설계가 되었습니다.
블로그 처리 방식도 세 번 바뀌었습니다. "축소 모드로 돌릴까요?"로 제안받았는데, 다시 생각해보니 블로그는 전문가 파이널 터치가 필요한 영역이라 아예 범위 밖으로 뺐습니다. 대신 블로그에서 발견한 번역체 결(⑩)은 다른 글에도 적용되게 살렸습니다.
도움이 필요한 부분
PPT와 DOCX 바이너리 파서: 1차에서는 .md/.html만 지원하기로 가정했지만, 책 챕터와 강의자료 커버에는 결국 필요합니다. 2주차 build에서 python-docx와 python-pptx 라이브러리 호환성이 어떻게 될지 궁금합니다.
DART MCP의 "회사명 → 공시 조회" 자동화 범위: ⑦-나 외부 대조가 상장사 글에만 자동이 되는데, 비상장, 사모펀드, 해외사 인용은 어떻게 커버할지는 더 고민이 필요합니다.
앞으로의 계획
2주차:
/gatekit-tasks로 10개 기능을 작업 단위로 쪼개고,/gatekit-build로 first cut 돌리기. F3(결정론적 치환)부터 시작해서 F2(숫자 재검증)로 넘어갈 예정.3주차:
/gatekit-gate로 검수 기준 명문화 +/gatekit-verify로 실제 글 2-3편에 돌려보기. 사고 재현 테스트 — "251배 → 25배"가 실제로 잡히는지, OCR 할루시 패턴을 플래그하는지.4주차: 실사용자 1명(저 자신)에게 전달 완료. 책 챕터 하나를 실제로 돌려서 사고 재현 통과하면 성공.
책 마감(10월 말)과 겹치는 구간이라, F3(표기 규칙)과 F4(OCR 플래그)만이라도 2주차 안에 돌아가면 책 교정에 바로 투입할 수 있습니다.
도움 받은 글 (옵션)
지피터스 24기 1주차 수업자료 "코드보다 인터뷰가 먼저다"
gatekit skill 세트 (
/gatekit-discover,/gatekit-interview,/gatekit-setup)CLAUDE.md의 "숫자 재검증" 섹션 (2026-08 사고 기록이 인터뷰어의 진입점이 됨)
도메인 리서치 출처: Grammarly, ProWritingAid, Originality.AI, Hallucitechecker 등 AI 글 교정과 fact-checking 도구 비교 글

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
부엉부엉 님 사례글 요약 정리가 잘되어 있네요 👍
과거 사고를 md에 기록해두면 좋을것 같네요 😀 꿀팁까지 전수해주셔서 감사합니다.👍