로컬 LLM, 어디까지 쓸 수 있을까? — 개인 비서를 만들려다 결국 클라우드로 간 이야기 (텔레그램 봇 '하루' 구축기)
2026.06.01
📝하려던 것
AI 에이전트를 공부하면서, 클라우드 API 비용·프라이버시 부담 없이 내 맥(M5 Max)에서 로컬 LLM으로 개인 비서를 직접 돌려보고자 함
텔레그램으로 말 걸면 구글 캘린더에 일정까지 잡아주는 '내 전용 비서'를 만들고자 함
로컬 LLM이 실무(도구 호출)에 쓸 만한지 직접 검증하고자 함
바쁘시면 이것만
맥에 개인 AI 비서('하루')를 텔레그램 봇으로 만들었음. 로컬 LLM으로 돌리려다 속도·신뢰성 벽에 부딪혀 결국 클라우드(Claude) 두뇌로 안착했고, 로컬은 이미지 생성(ComfyUI)처럼 잘하는 일에 재배치함.
핵심 교훈: 느리면 모델 크기보다 '생각 모드'부터 의심할 것.
⚒️활용한 툴
Hermes: 내 맥에서 도는 개인 AI 에이전트 프레임워크 (텔레그램 봇 '하루'의 본체)
Telegram Bot: 비서에게 말 거는 메신저 인터페이스
LM Studio / Ollama: 내 맥에서 로컬 LLM을 돌리는 실행기 (Qwen3.6 · Gemma4 · gpt-oss 등)
ComfyUI + Flux: 로컬에서 무료로 이미지를 생성하는 스킬
Claude Code: 위 모든 걸 설치·연결·디버깅한 AI 코딩 도구 (이 작업의 페어 파트너)
🔍진행 세부 내용
Hermes 설치 + 텔레그램 봇 '하루' 연결
맥에 Hermes를 설치하고 정상 동작을 확인함
BotFather로 봇 토큰을 만들고, 게이트웨이에 봇 토큰·사용자 ID를 넣어 텔레그램 봇 '하루'를 연결함
구글 캘린더 연동 — 말로 일정 잡기
구글 OAuth 인증으로 캘린더·Gmail·Drive 권한을 봇에 연결함
이제 텔레그램에 말을 걸면 캘린더에 일정을 기록·수정할 수 있게 됨
로컬 LLM이 너무 느림 — 알고 보니 하드웨어가 아니라 '생각 모드'
Qwen3.6-35B로 돌리니 응답이 너무 느려서, 처음엔 내 맥 성능을 의심함
점검 결과 M5 Max/64GB는 전혀 병목이 아니었고, 느린 진짜 원인은 모델이 답하기 전에 길게 추론하는 '생각(thinking) 모드'였음
받아둔 모델도 한계가 있었음: 작은 모델은 도구 조작을 못 하고, 코더 모델은 컨텍스트가 64K 미달이라 거부됨
Ollama vs LM Studio 벤치마크 — Ollama는 생각을 끌 수 있다
LM Studio에선 생각 모드를 끄는 옵션이 안 먹혔지만, Ollama는
--think=false로 생각을 끌 수 있었음생각을 끄자 같은 모델이 눈에 띄게 빨라짐 (아래는 동일 조건 측정):
모델 | 속도(생각 OFF) | 비고 |
|---|---|---|
gemma4:e4b | 105 tok/s | 매우 빠름, 단 소형(도구엔 약함) |
qwen3.6:35b-a3b | 61 tok/s | LM Studio(~49)보다 빠름, 균형 최적 |
gemma4:31b | 21~25 tok/s | 밀집형이라 느림 |
ComfyUI + Flux 이미지 생성 붙이기
M5 Max/64GB면 이미지 생성은 로컬이 명확히 유리(무료·무제한·데이터 외부유출 없음)라 판단함
ComfyUI 본체와 Flux 모델을 설치해 서버를 띄우고, 봇으로 실제 이미지를 생성함 (밑에 "하루" 그림)
초보자용 'Comfy + Flux 그림 그리기' 매뉴얼을 웹페이지로 정리함
음성 명령 · k-skill로 기능 확장
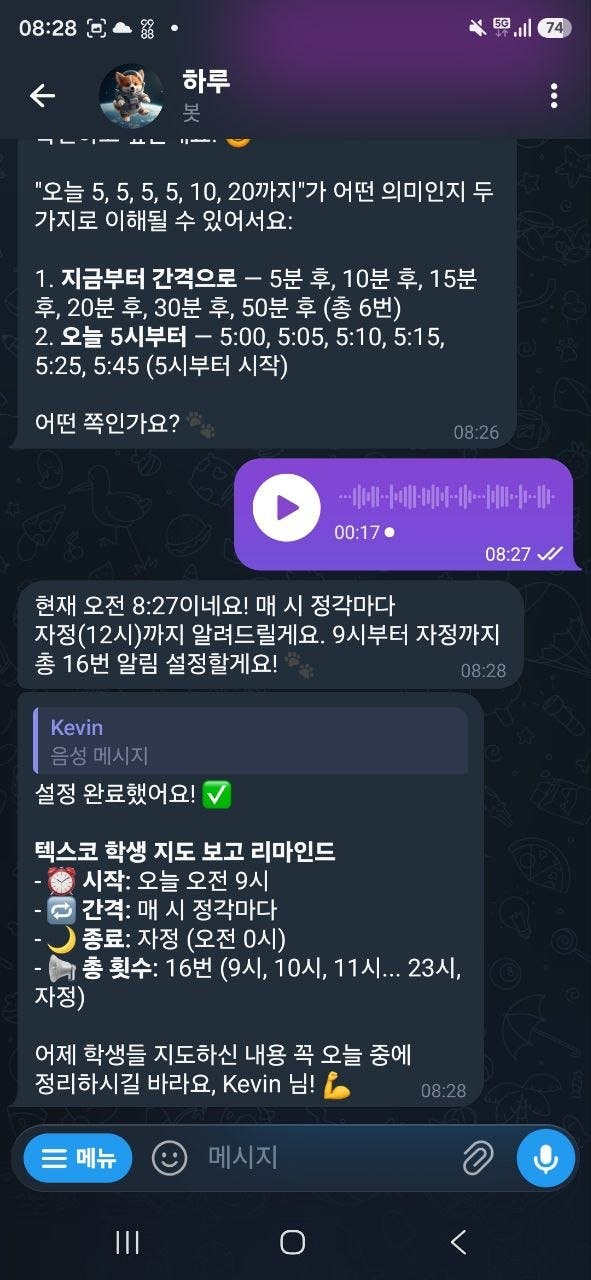
faster-whisper를 붙여 봇에게 말로 명령할 수 있게 함
오픈소스 한국형 스킬 모음(k-skill)을 설치하고, 작동하지 않는 서비스는 제외함
두뇌 안정화 — 결국 클라우드(Claude)로 안착
봇이 "나는 아직 Qwen을 쓴다"고 우기며 자꾸 느리고 실패함. 추적해보니 진행 중이던 대화 세션이 옛 모델 설정에 고정(pin)돼, 한도가 소진된 Gemini 폴백을 물고 재시도하느라 느렸던 것이었음
꼬인 세션을 지우고 폴백을 정리하자 정상화됨
로컬 Qwen은 봇 워크로드에서 8~20분·빈 응답·없는 도구 환각까지 나와, 두뇌는 클라우드 Claude로 확정함. 로컬은 이미지 생성 등 잘하는 일에 남김
⚠️시행착오
'생각 모드'의 함정: 느린 게 하드웨어 탓인 줄 알고 한참 헤맸지만, 진짜 범인은 모델의 생각 모드였음. LM Studio는 이걸 못 끄고 Ollama는
--think=false로 끌 수 있다는 차이를 몰라 시간을 많이 씀.컨텍스트·도구 능력 미달: 손에 있던 로컬 모델들이 막상 에이전트엔 안 맞았음(64K 컨텍스트 미달로 거부되거나, 너무 작아 도구 호출을 못 함). "받아둔 걸로 어떻게든 되겠지"가 안 통함.
봇이 자기 상태를 틀리게 말함: 봇이 "Qwen 쓴다"고 우긴 건 거짓 진술이었고, 실제론 세션이 옛 모델에 고정돼 있었음. 컴퓨터 재시작이 아니라 설정·로그를 직접 추적해야 풀렸음.
📚 배운 점
느리면 모델 크기보다 '생각 모드'부터 의심하라: 같은 모델도 생각을 끄면 확 빨라짐. 로컬에선 LM Studio보다 Ollama(
--think=false)가 이 점에서 유리함.로컬 LLM은 '항상 켜진 도구 호출 비서'엔 아직 무리: 속도·신뢰성이 따라오지 못함. 대신 이미지 생성·요약처럼 로컬이 잘하는 일에 역할을 배치하는 게 현실적임. 로컬을 버리는 게 아니라 '맞는 일'을 주는 것.
비싼 큰 모델이 답은 아니다: 에이전트용 모델은 크기보다 컨텍스트(64K+) · 도구 호출 능력 · 생각모드 유무로 골라야 함.
🧭 향후 계획
RAG 붙이기 — 로컬 LLM에게 "외운 걸 꺼내라" 대신 "이 자료 보고 답하라"로, 검색 스킬을 연결해 정확도를 보완할 계획임
작은 로컬 모델 재투입 — 요약·분류처럼 작은 모델이 잘하는 작업에 로컬을 다시 활용할 계획임
일상 자동화 확장 — 음성 명령·k-skill을 더 다듬어 비서가 처리하는 일상 업무를 늘릴 계획임
🤝 도움이 필요한 점
1️⃣ 로컬 LLM + RAG 결합 시 최적화 방안
현재 상황
로컬 LLM의 부정확성을 RAG(자료 직접 제공)나 검색 스킬로 보완하려 하지만, 구체적 구현·최적화 전략 지식이 부족함
시도한 방법
봇에 검색 스킬은 붙였으나, "수치 같은 건 검색해서 답해줘" 수준의 RAG 파이프라인은 아직 설계만 한 상태
필요한 도움
작은 로컬 모델에서도 잘 도는 RAG 구성(추천 임베딩·벡터DB·라이브러리)과, 검색 스킬 연결 시 정확도를 높이는 실전 가이드
2️⃣ 맥이 꺼지면 멈추는 봇 — 24시간 운영 방법
현재 상황
게이트웨이가 노트북에서 돌아, 맥이 꺼지거나 잠자기면 봇이 응답하지 못함
시도한 방법
클라우드 배포(Hetzner·Fly.io 등) 비용·보안만 검토한 상태
필요한 도움
구글 권한을 든 봇을 안전하게 24시간 클라우드로 올리는 권장 구성과 보안 체크포인트
로그인하고 댓글을 남겨 주세요
말로 명령하는 faster whisper 궁금한데요?!
구체적인 데이터로 접근하시는게 너무 좋습니다
감으로 하는...저에게 반성의 포인트가 되었습니다..!
저의 텔레그램 봇을 만들어 문자로 명령하다가 보니 외국인들은 말로 메시지 보내던것을 생각하고는 나도 말로 해보자고 시도해 본 내용입니다. 결국은 faster whisper를 Claude가 설치해 줬고 그걸 바탕으로 잘 작동하고 있습니다. ^^ Gemma4로 바꿨더니 음성인식이 좀 떨어지는 것 같습니다..

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
24/7 클라우드 운용 기대하겠습니다. 저도 참 고민인 주제라서
일단 한 일주일 맥에서 봇을 돌리고는 있는데 저는 딱히 Use Case를 찾지 못해서 어제부터는 새벽2시에 잠자고 아침 7시에 일어나게 하는 루틴으로 가져가려고 합니다. 맥도 쉬어야 하느까요. ㅎㅎ 대신 Wake-up 했을때 텔레그램 봇, Hermes, 그리고 로컬 llm이 다시 동시에 깨어 날수 있도록 Claude하고 작업했습니다.