


소개
한국어 한국어 한국어 한국어 한국어 한국어 한국어 한국어
무엇을, 왜 시도했나
명리 상담을 AI로 옮길 때 사람들은 보통 "얼마나 잘 맞히느냐"를 봅니다. 그런데 제가 실제로 붙잡은 문제는 정확도가 아니라 재현성이었습니다.
강의를 아무리 많이 들은 상담자도 상담 자리에서는 기억나는 것만 씁니다. 같은 명식을 두 번 봐도 매번 다른 말이 나오고, "왜 그렇게 말했는지"가 남지 않습니다. 목표는 더 똑똑한 통변이 아니라 잊힌 맥락을 되살리고, 근거를 남기는 통변입니다.
그래서 세운 원칙이 세 가지입니다.
없는 것을 없다고 기록한다 — "관성이 통째로 없다"는 침묵할 정보가 아니라 근거로 확정할 판정 결과다.
못 찾은 것을 못 찾았다고 남긴다 — 억지로 채우면 그게 환각이다. 보류를 정상 결과로 취급한다.
스스로 근거(slide 번호)를 대지 못하면 답하지 않는다 — fail-closed.
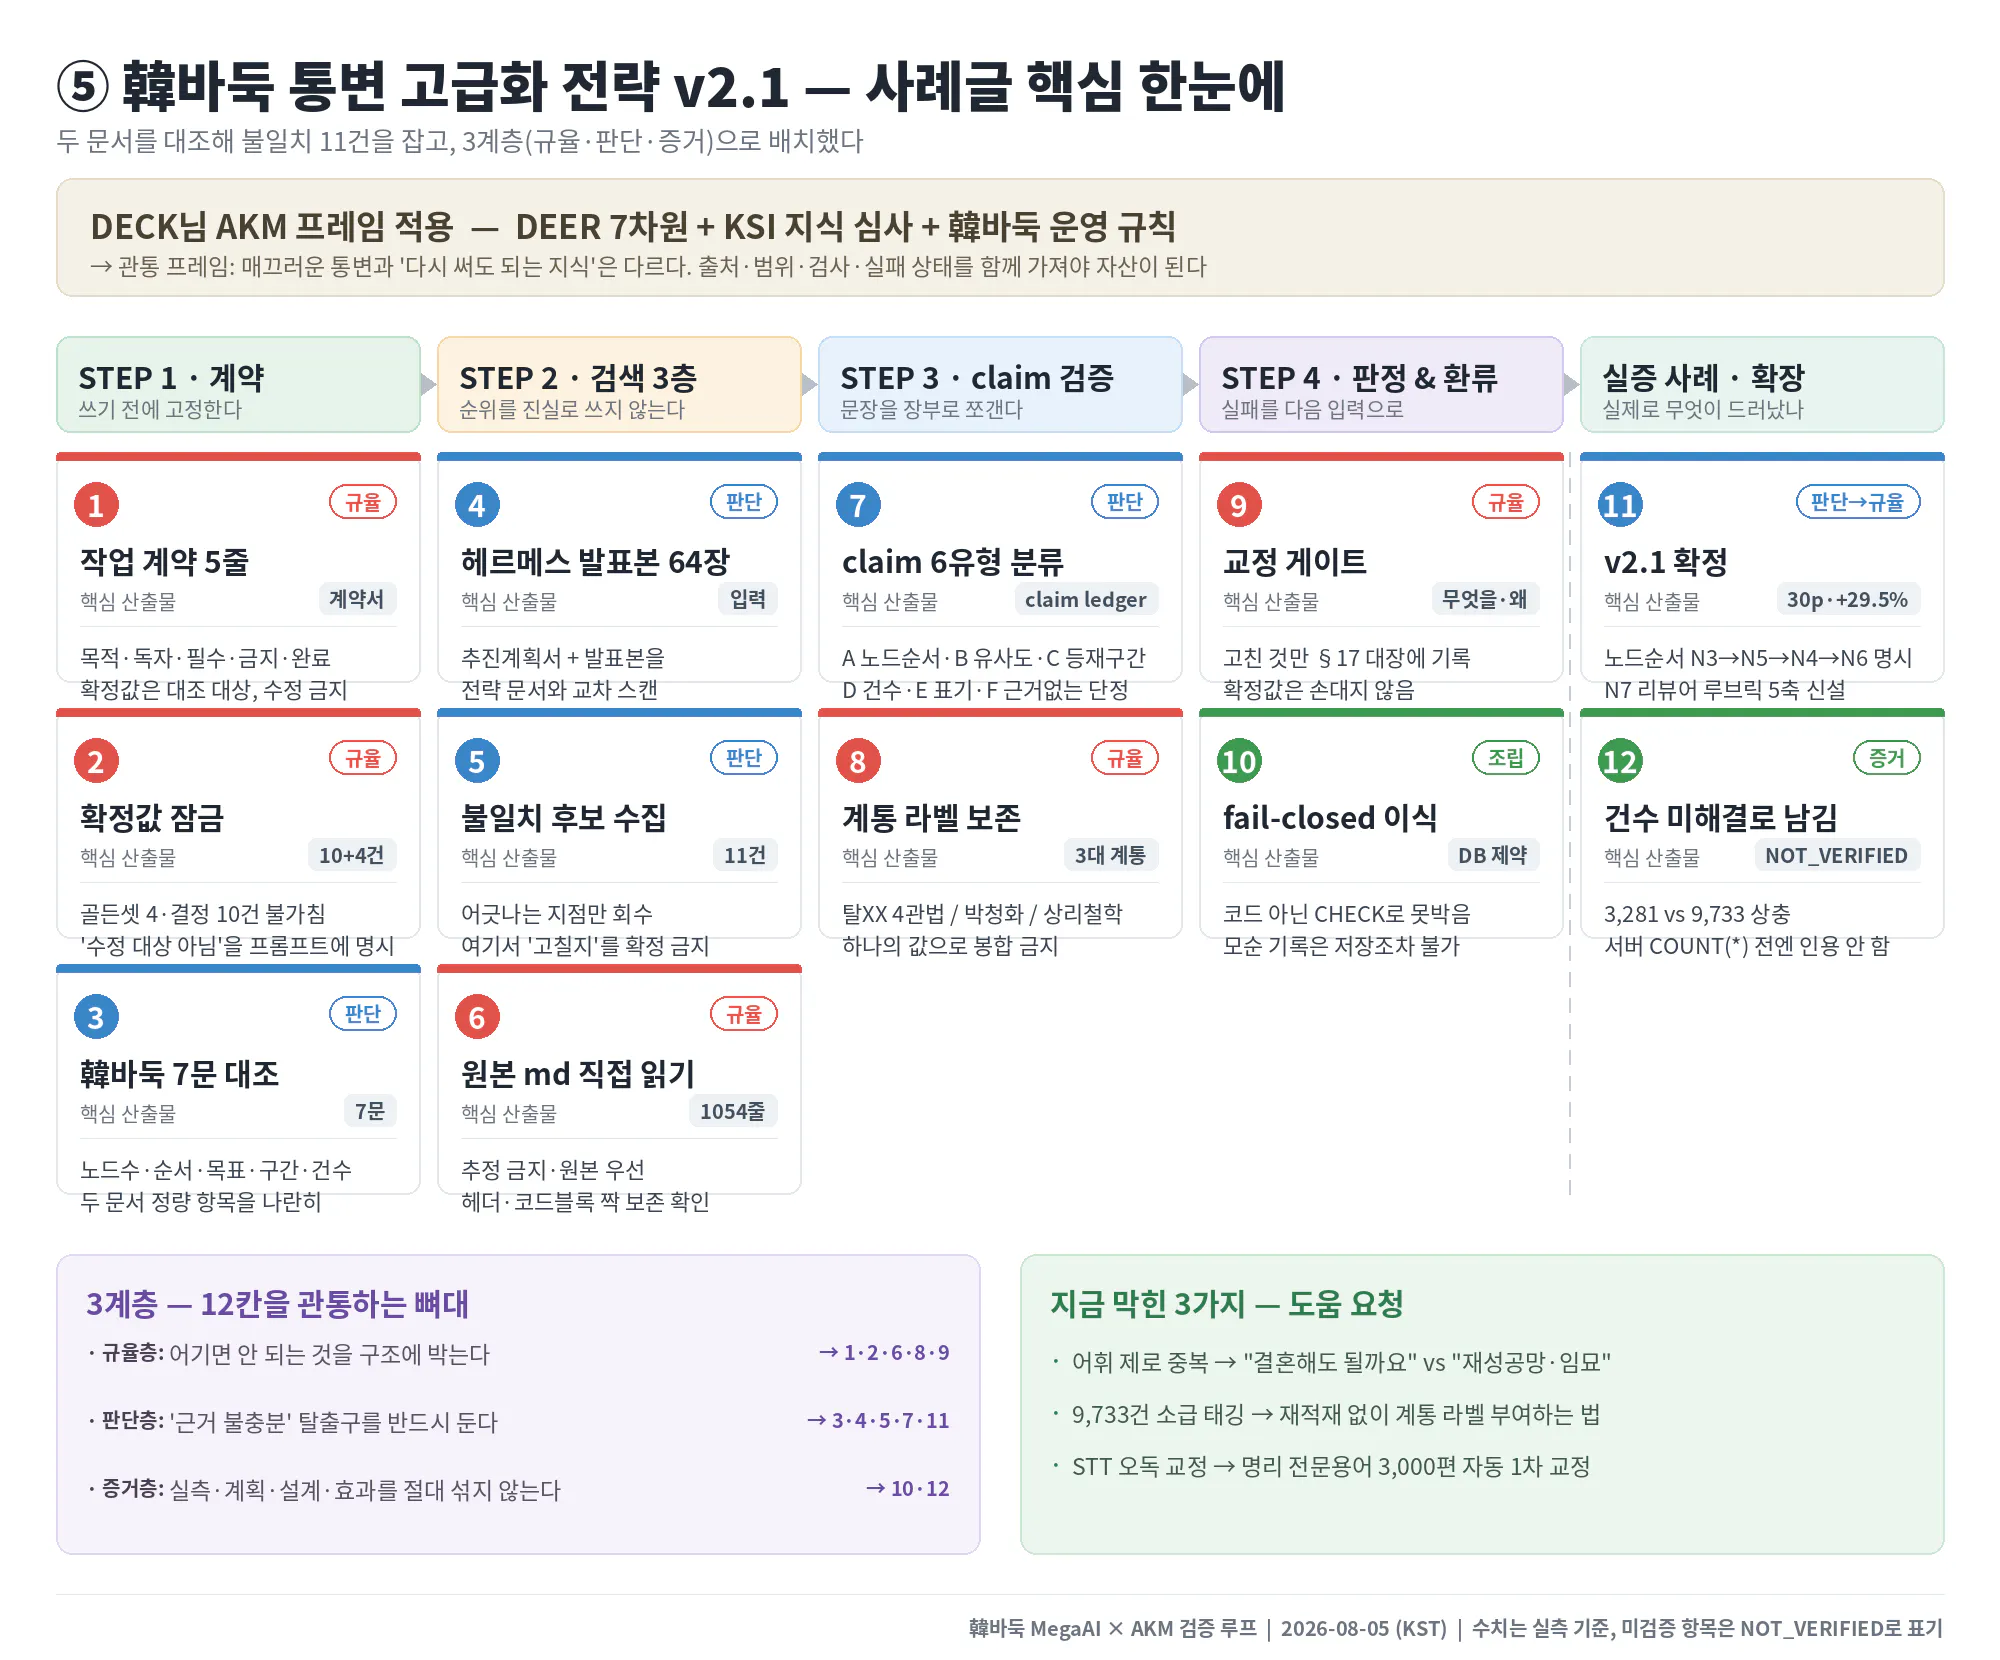
이 원칙을 담은 문서가 「통변 고급화 전략」이고, 이번 글은 그 문서를 v2.0 → v2.1로 끌어올린 교정 작업의 기록입니다. 별도로 작성한 헤르메스 추진계획서·발표본과 대조했더니 전략 문서 안에 불일치 11건이 숨어 있었고, 그걸 잡아내는 과정 자체가 "문서 ≠ 사실" 원칙의 실전 사례가 되었습니다.
진행 방법
사용 도구
Claude(Opus) — 두 문서 교차 대조, 불일치 식별, 문서 재작성
python-docx / docx-js — 최종 산출물(.docx) 생성
PostgreSQL(
hermes.*스키마) — 판정 로직·품질 지표를 DB 제약으로 강제
핵심 구조 — 3축 직교 태깅
통변을 "언제·무엇·어떻게" 세 축으로 분해했습니다. 이게 전략의 뼈대입니다.
        TS (단계)     ─── 언제 쓰는가 (순서: 구조→육신·신살→시간→상담전환)
         ×
      DOMAIN (영역)   ─── 무엇에 쓰는가 (직업·건강·재물·인연…)
         ×
      ROLE (역할)     ─── 어떻게 쓰는가 (원리·절차·사례·예외·상담문)
교정 과정 — 두 문서를 나란히 놓고 대조
작업의 핵심 프롬프트는 이것이었습니다.
전략 문서(v2.0)와 헤르메스 추진계획서·발표본 64장을 교차 대조해라.
- 노드 수·실행 순서, 유사도 목표, 등재 구간, 건수 같은
  '정량 항목'이 두 문서에서 어긋나는 지점을 전부 찾아라.
- 확정값(골든셋 4건·결정 10건·부재 판정 범위)은 교수님 확인을 거쳤으니
  손대지 말고, 대조 대상으로만 삼아라.
- 발견한 불일치는 표로 정리하되, '무엇을 왜 고쳤는지'를 반드시 남겨라.
  (문서 ≠ 사실 원칙)
이렇게 잡아낸 불일치 11건 중 대표적인 것들입니다.
위치
v2.0
v2.1
사유
노드 순서
"6노드(N1~N6)"만 표기
실행 순서 N3→N5→N4→N6 명시
가드레일은 만들어진 문장을 검사해야 하므로 합성(N5) 뒤에 와야 함
유사도 목표
0.80 단일
0.5395 → 0.80 → 0.90 3단계
추진계획서의 실제 정량 목표 반영
등재 구간
로드투프로 15~28강
8~28강(15~28 우선)
TS5 공백 구간과 등재 범위 구분
건수
미기재
미해결로 남김
3,281건 vs 9,733건 상충 → 서버 실측 대기
가장 신경 쓴 지점 — fail-closed를 코드가 아니라 DB가 지키게
"근거 없으면 차단"을 코드로만 두면 버그가 나면 뚫립니다. 그래서 DB 제약으로 못박았습니다. 코드에 버그가 있어도 모순된 기록 자체가 저장되지 않습니다.
sql
CONSTRAINT rtype_rs_consistent CHECK (
      (rtype = 'FULL'    AND recall_suff >= 1.0)
   OR (rtype = 'ABSENT'  AND recall_suff >= 1.0)
   OR (rtype = 'PARTIAL' AND recall_suff > 0 AND recall_suff < 1.0)
   OR (rtype = 'HELD'    AND recall_suff = 0)
   OR (rtype = 'BLOCKED'))
또 v2.1에서 새로 넣은 N7 리뷰어는 통변을 스스로 5축(근거성·계통순수·가드준수·표기규칙·겸손성)으로 채점합니다. 생성기와 채점기를 분리해 자기 편향을 없앴고, 근거성 축이 만점이 아니면 무조건 보류하도록 이중 방어를 걸었습니다.
python
def n7_review(state) -> dict:
    scores = grade_with_llm(state["draft"], RUBRIC)   # 각 축 0~2점
    total  = sum(scores.values())
    if total >= 9 and scores["근거성"] == 2:
        verdict = "통과"
    elif total >= 6:
        verdict = "수정"      # 백로그 상단으로
    else:
        verdict = "보류"      # 재생성
    return {"review_scores": scores, "verdict": verdict}
결과와 배운 점
결과 — 전략 문서를 v2.1(30페이지, .md + .docx)로 확정했습니다. 불일치 11건을 잡고, 노드 실행 순서·N7 채점·소요기간·난관 8종을 흡수했습니다. 글자수는 +29.5% 늘었지만 헤더 소실 0건, 코드블록 짝 정상으로 원본 구조를 그대로 보존했습니다.
꿀팁 셋
"문서에 완료"라고 적혀 있어도 그건 사실이 아니다. 이번에도 두 문서에서 건수가 3,281 vs 9,733으로 어긋났습니다. 서버
SELECT COUNT(*)전까지는 어느 쪽도 본문에 인용하지 않고 미해결로 남기는 게 맞습니다.확정값과 수정 대상을 처음부터 분리하라. 교수님이 이미 확인한 골든셋 4건·결정 10건은 "대조 대상이지 수정 대상이 아니다"라고 프롬프트에 못박으니, AI가 멀쩡한 확정값을 건드리는 사고가 사라졌습니다.
판정을 코드가 아니라 DB 제약으로 지키게 하라. 로직에 버그가 나도 모순된 데이터는 애초에 안 들어갑니다.
시행착오 — 초기 러너는 "ABSENT 2건"이라는 숫자만 대조해서, 엉뚱한 케이스가 ABSENT로 뒤바뀌어도 통과했습니다. 케이스 ID까지 대조하도록 고쳤습니다. 통과만 하는 테스트는 안전망이 아니라 장식이라는 걸 다시 배웠습니다.
도움이 필요한 부분 — 가장 큰 병목은 코딩이 아니라 원천 데이터입니다. 박청화 강의 전사·STT 교정과 4관법 DB 소스 정제는 명리학 원문 지식과 데이터 정제 역량을 동시에 요구해서 외주로 넘기기 어렵습니다. 명리 전문용어 STT 오류를 효율적으로 잡는 워크플로우에 대한 조언이 있으면 반갑겠습니다.
< 앞으로의 계획 >
RAG 유사도 0.5395 → 0.80 → 0.90 3단계 개선 (청크 재분할·맥락 태깅·강의 시점 랭킹)
60갑자 전수 커버리지 (현재 19/60 → 60/60)
가족 명식 4건 파일럿으로 RS·EU 실측 — 단, "내용 일치"는 합격 기준에 넣지 않는다. 목표는 같은 답이 아니라 근거를 남기는 것이니까.
최종적으로 헤르메스 통변 출력이 그대로 UNESCO 디지털 문화유산 등재 서류(2027)로 흐르게 하는 것
도움 받은 글 (옵션)
지피터스 23기 에이전트 하네스 과정 (Skill→Umbrella→Harness→Growth Loop 커리큘럼)
