


1. 소개
YouTube 콘텐츠를 기반으로 하는 하이브리드 RAG 멘토 챗봇을 만들기 위해, 자막과 메타데이터를 자동으로 수집하고 이를 Supabase에 저장해 벡터 검색이 가능한 구조로 설계하려고 했습니다.
결론적으로 단순히 자막 정보만 가져오는 자동화가 아니라, 데이터 흐름 전체를 설계하는 중요한 경험이 되었습니다. DifyBot을 성공하고, 데이터 쌓기를 금방(!)하고 멘토 챗봇을 실험하고 싶었는데. n8n 도구를 사용하면서 시행착오가 많았습니다.
2. 진행 방법
사용한 도구
n8n: 자동화 워크플로우 설계
Apify API, Google API: YouTube 정보 수집용
Supabase: 데이터 저장소
3. 워크플로우 흐름 💡
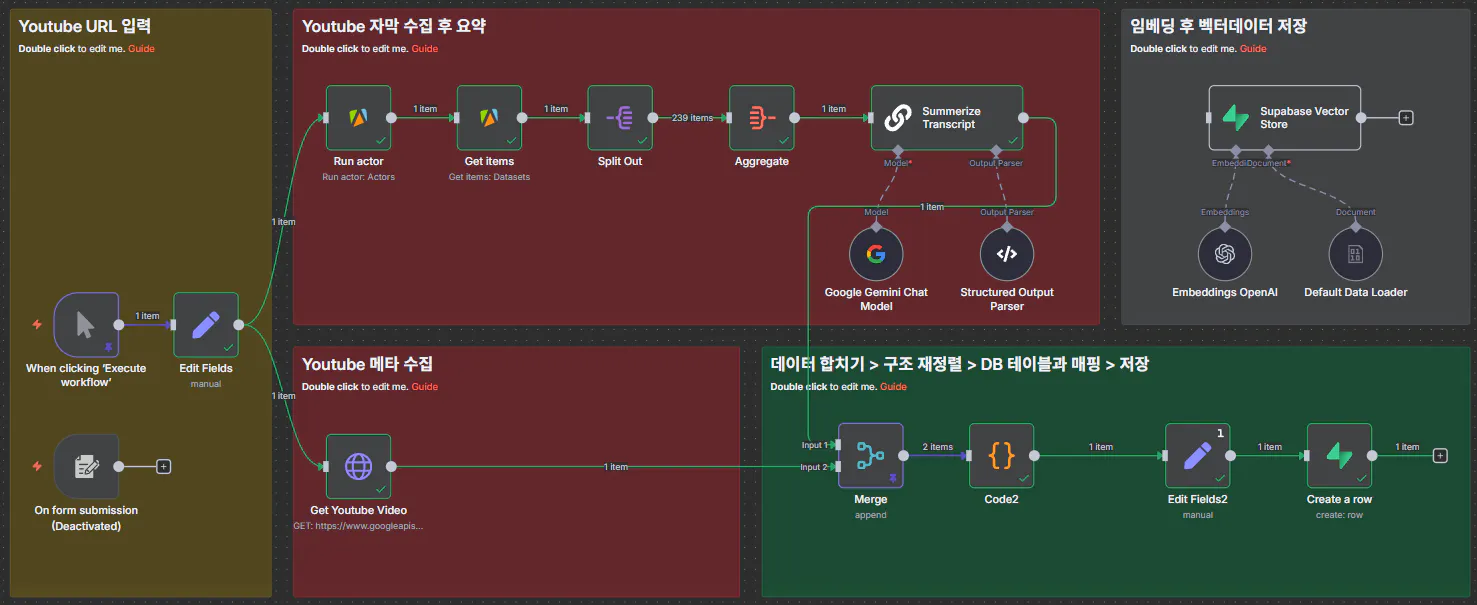
시스템의 다른 부분을 보여주는 다이어그램
- 주요 처리 단계:
YouTube URL 입력
자막 수집 → 요약 생성 (Structured Output Parser 사용)
메타데이터 수집 → 제목, 채널정보, 날짜 등
두 데이터 Merge 후 JSON 구조 정제
Supabase에 content, summary, tags 등 저장
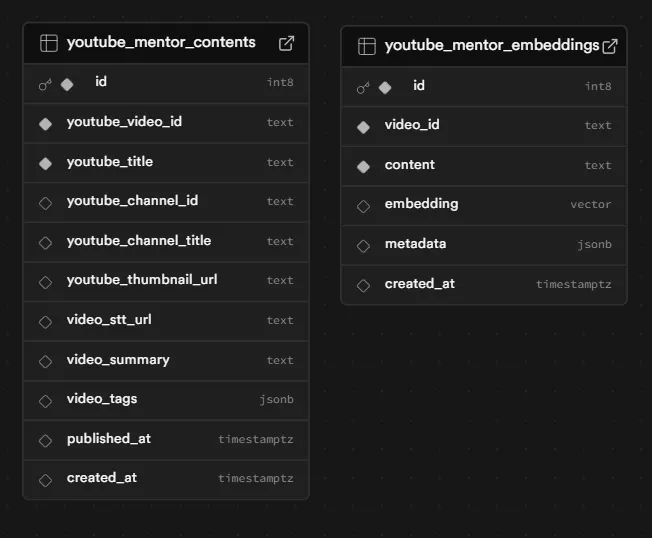
다양한 유형의 비디오를 보여주는 YouTube 앱의 스크린 샷
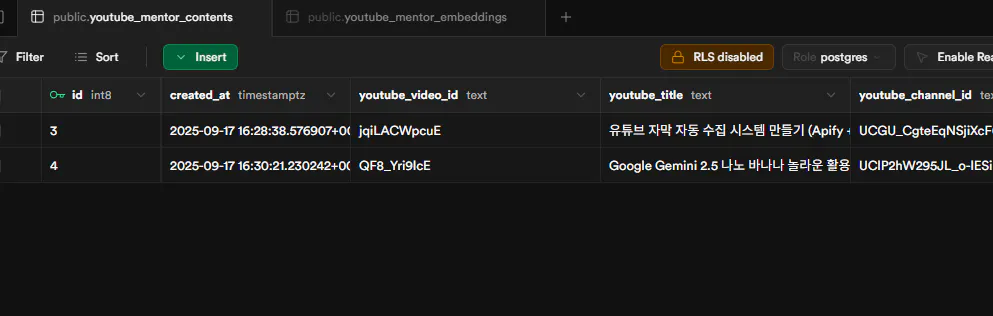
여러 다른 항목이있는 검은 색 화면의 스크린 샷
4. 시행착오 기록
문제1) n8n 버전이 YouTube transcript 커스텀노드 미지원
Apify API의 scraper 제공 기능 차이
youtube scraper : 메타데이터youtube transcript scraper : 자막 전용
Google API로는 metadata,transcript scraper로는 자막 수집
문제 2) n8n에서 merge node 와 json 구조화 이슈
단순 append는 구조 정리를 안 해주기 때문에 code 노드로 JSON 정제 작업 필요
n8n 버전이 combine 연관 옵션을 미지원
문제 3) 데이터가 쪼개져서 기록 됨
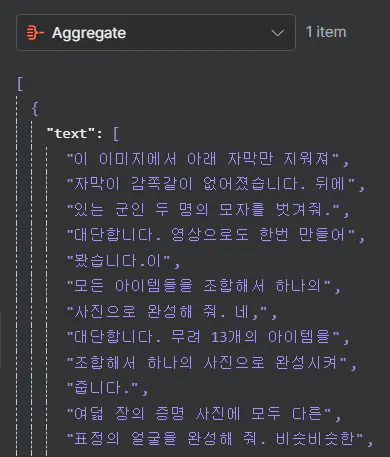
개행문자를 무시하고 줄바꿈 합치기 (join) 하는 작업이 필요
summary 버전 만들 때 structured output parser 노드 사용함
자막 전체 텍스트 확보 후 → 요약 생성 → Supabase에 저장
한국어 화면의 스크린 샷
문제 4) 벡터 저장 문제
Supabase Vector Store와 연결을 시도했으나, embedding, metadata 필드 매핑 불완전
n8n에서 다른 노드 활용 사용법
5. RAG 연동을 위한 고민
항목
현황
Supabase 저장
완료
챗봇 검색을 위한 Chunking
n8n or Python 예정
Embedding 및 Vector 저장
Supabase Vector Store 연결 실패
→ 다른 수단 전환 예정
DifyBot 에서 Supabase 검색
Dify API 활용 미정
6. 결과와 배운 점 😊
자동화란 도구 연결이 아니라, 서비스 흐름 설계다.
구현보다 데이터 흐름 기획이 선행되어야 시행착오가 줄어든다.
Chunking, Embedding, 저장 → 검색까지 흐름을 고려한 스키마가 중요
하나의 도구에 의존하기보단, 역할 분담 구조가 효율적이다.
메신저 챗봇R 기능 최소화 → 백엔드 중심 구조로 개발 운영 (API)
도움 받은 글 (옵션)
Apify 공식 Docs: https://docs.apify.com
자동화는 결국 작은 연결의 반복 💡
