


소개
구글애널리틱스의 한국어 버전
시도한 것
제가 발행한 사례글의 품질을 재는 채점표(루브릭)를 만들고, 그 채점표가 쓸 만한 물건인지 검정했습니다.
왜 했나 — 비대칭을 발견해서
명리학 강의 자료를 AI가 검색·인용할 수 있게 만드는 프로젝트를 하고 있고, 그 과정을 사례글로 연재하고 있습니다. 시스템 쪽에는 이미 자동 채점 장치를 붙여 뒀습니다. 통변(해석문) 하나가 나오면 별도 리뷰 노드가 다섯 개 축으로 채점하고, 한 축이라도 하드게이트에 걸리면 산출물을 내보내지 않습니다.
그런데 어느 날 이 상태를 알아챘습니다.
시스템이 만든 문장은 채점하는데, 그 시스템에 대해 내가 쓴 글은 아무도 채점하지 않는다.
사례글이 열두 편 쌓였는데 "잘 쓰고 있나"에 답할 방법이 없었습니다. 조회수나 좋아요는 품질 신호가 아닙니다. 발행 순서가 곧 개선 순서라는 보장도 없고요. 내 시스템에는 적용한 규율을 내 글에는 적용하지 않은 것이라, 그 비대칭을 메우기로 했습니다.
애초에 노렸던 것
숫자 하나를 얻으려던 게 아닙니다. 목표는 셋이었습니다.
고칠 자리를 지목하는 것 — "글이 좀 약하다"는 진단이 아닙니다
시계열로 보는 것 — 12편이 나아지고 있는지, 그냥 달라지고 있는지
채점표 자체를 검정하는 것 — 이게 실은 가장 중요했고, 실제로 여기서 다 터졌습니다
진행 방법
3-1. 사용 도구
도구
역할
Claude (프로젝트 지식 + 코드 실행)
채점, 앵커 추출, 게이트 스크립트 실행
내 발행 사례글 12편
채점 대상이자 앵커 원천
내 지식관리 문서
반성문 총괄표(35건·18패턴), 체크리스트, 전략서 — 하드게이트 근거
외부 사례글 12편
채점표 검정용 (인용·실명 없이 시험 재료로만 사용)
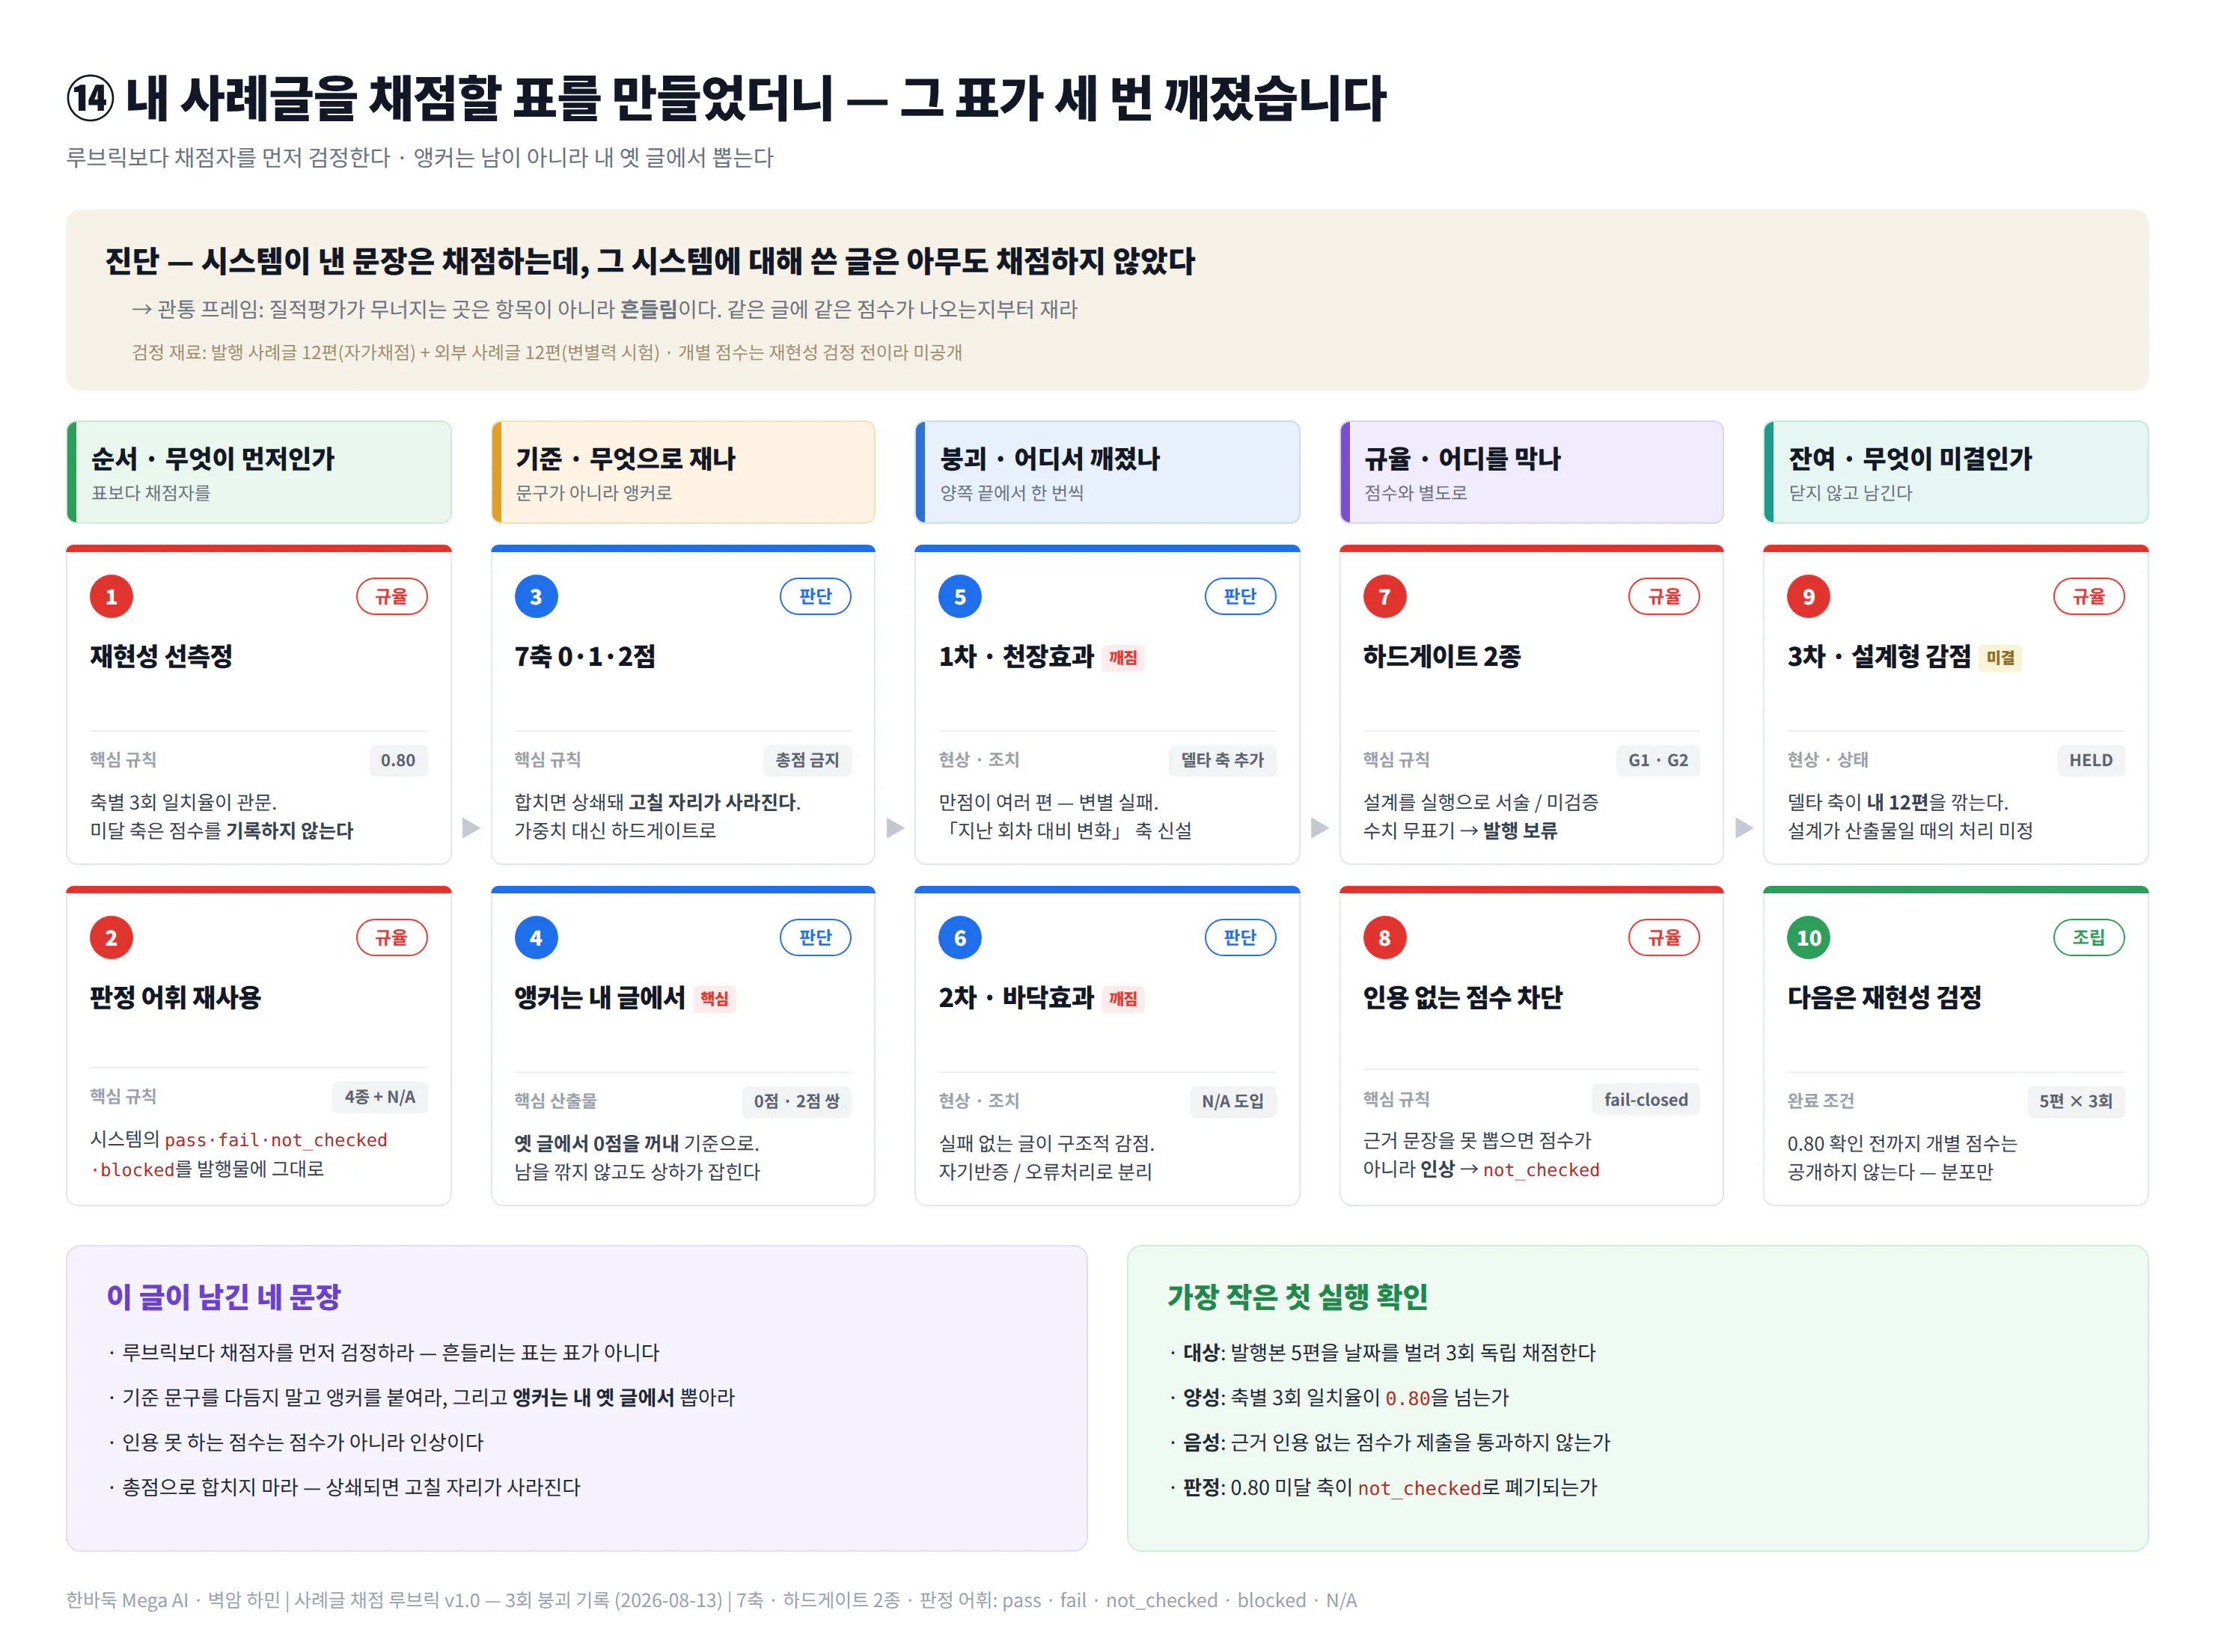
3-2. 순서를 뒤집었습니다 — 루브릭보다 재현성이 먼저
이게 이번 작업의 첫 번째 결정입니다.
보통 이런 일은 "항목을 정교하게 다듬는 것"부터 시작합니다. 저는 반대로 갔습니다. 질적평가가 무너지는 지점은 항목이 부족해서가 아니라, 같은 글에 같은 점수가 안 나와서입니다. 측정 도구를 검정하지 않고 측정부터 하면, 나온 숫자가 글의 품질을 잰 것인지 그날의 컨디션을 잰 것인지 구분할 수 없습니다.
그래서 판정식을 먼저 못 박았습니다.
축별 3회 일치율 = (3회 모두 같은 점수인 축의 수) / (축 수 × 편 수)

≥ 0.80      → 이 루브릭으로 측정 개시
0.60 ~ 0.79 → 앵커 보강 후 재측정 (문구 수정이 아니라 예시 추가)
< 0.60      → 그 축은 폐기하거나 하드게이트로 강등
조건은 셋 — 회차 간 결과를 안 보이게, 편 순서를 회차마다 섞어서, 총점이 아니라 축별로 기록.
0.80 미만인 축의 점수는 아예 기록하지 않습니다. not_checked로 남기는 게 낫습니다. 재현 안 되는 숫자를 남기면 나중에 그걸 근거로 "개선됐다"고 말하게 됩니다.
3-3. 판정 어휘를 시스템에서 그대로 가져왔습니다
새 어휘를 만들지 않고, 시스템 쪽에서 쓰던 네 단어를 그대로 썼습니다.
판정
의미
pass
확인함
fail
확인했고 미달
not_checked
아직 확인 못 함 — 값이 있어도 믿으면 안 됨
blocked
확인 자체가 불가(원본 부재 등)
그리고 이번에 N/A를 추가했습니다. 이유는 4장에서 설명합니다 — 이게 두 번째 붕괴의 수습책이었습니다.
3-4. 채점 지시 프롬프트 (전문)
내 사례글 6편을 아래 규칙으로 채점해 줘.

[대상]
첨부한 발행본 6편. 초안이 아니라 실제 게시된 본문 기준.

[축]
실측성 / 재현가능성 / 자기반증 / 오류처리 / 경계표시 / 독자이득 / 델타
각 0·1·2점. 축별로 따로 낼 것.

[규칙]
- 총점으로 합치지 말 것. 상쇄되면 고칠 자리를 못 짚는다.
- 점수를 매기기 전에, 그 점수의 근거가 되는 문장을 본문에서 그대로 인용할 것.
  인용 못 하면 그 축은 not_checked.
- 해당 사항이 아예 없는 축은 0점이 아니라 N/A로 둘 것.
  (실패가 없는 글에 "실패공개 0점"은 부당한 감점이다)
- 하드게이트 2종은 점수와 별도로 판정할 것.
- 어느 축이 낮게 나올지 미리 예상하지 말 것.
  예상하면 그걸 확인하는 방향으로 채점이 기운다.

[출력]
편 × 축 전체 표 + 하드게이트 위반 목록 + 근거 인용문
마지막 규칙이 실제로 일을 했습니다. 작업 중에 제가 "실측성은 높고 델타는 낮을 것 같다"고 말할 뻔했는데, 그 순간 이 줄이 걸렸습니다. 예측을 입 밖에 내면 채점자가 그걸 확인하러 갑니다. 채점자가 하나뿐일 때는 더 심하게 걸립니다.
3-5. 앵커 — 내 글에서 0점과 2점을 뽑았습니다
재현성을 올리는 거의 유일한 실효 수단이 앵커입니다. 기준 문구를 아무리 다듬어도 흔들림은 안 줄어듭니다. 대신 실제 문장 두 개를 위아래에 박아 두면, 채점자가 "이건 저것보다 위인가 아래인가"만 판단하면 됩니다.
앵커를 제 초기 글과 최근 글에서 뽑았습니다. 남의 글에서 뽑지 않은 이유가 있습니다 — 남을 깎지 않아도 되고, 무엇보다 제 문체 안에서의 상하 기준이 잡히기 때문입니다.
축
0점 앵커 (내 초기 글)
2점 앵커 (내 최근 글)
실측성
"누적 9,733건+" (출처·검증 상태 표기 없이)
"301~400 구간의 슬롯 필드 84건이 0으로 저장돼 있었다. 원본이 없어 재파싱할 수 없어 blocked로 남겼다"
자기반증
"3종 검증 전건 통과" (검증기 자체는 안 봄)
"문서에는 '검증한다'고 적혀 있었고, 실제 코드는 배열이 비었는지만 검사했다"
경계표시
"…을 구현한다" (미실행인데 완료형)
"최종 상태: not_checked — 그래프를 컴파일·실행하지 않았다"
델타
12편 연속 "설계 완료, 실행은 다음 편"
(2점 앵커 없음 — 이것이 4장의 발견)
0점 앵커가 전부 제 글이라는 게 이 표의 핵심입니다. 내 옛 글에서 0점을 꺼내 기준으로 삼으면, 채점이 남을 재는 일이 아니라 나를 재는 일이 됩니다.
3-6. 하드게이트 2종 — 점수와 무관하게 발행 보류
가중치는 정하지 않았습니다. 축 간 가중치는 근거를 만들 수 없고, 결국 원하는 결론이 나오게 조정됩니다. 명확한 위반은 가중치가 아니라 게이트로 뺐습니다.
게이트
판정 조건
G1 설계-실행 혼동
"…한다"로 적혔는데 실제로는 미실행
G2 미검증 수치 무표기
NOT_VERIFIED 대상을 확정치처럼 인용
G2는 저에게 실제로 걸리는 항목입니다. 제 문서에는 같은 누적 건수가 세 가지로 적혀 있습니다 — 2,387 / 2,700 / 9,733. 이건 제 지식관리 체크리스트에 미해결로 올라와 있는 사안이고, 그 숫자가 사례글에 표기 없이 들어갔다면 그건 게이트 위반입니다. 같은 숫자라도 표기 유무로 갈립니다.
3-7. 채점 게이트 — 사람이 아니라 코드가 막습니다
채점 결과를 그대로 믿지 않도록, 제출 전에 코드로 걸렀습니다.
python
import statistics
from collections import Counter

AXES = ["실측성","재현가능성","자기반증","오류처리","경계표시","독자이득","델타"]
VERDICTS = {"pass","fail","not_checked","blocked","N/A"}

def gate(rounds, quotes):
    """
    rounds: [{편: {축: 점수 or 'N/A'}}, ...]  3회분
    quotes: {(편, 축): 근거 인용문}
    실패 시 결과 제출 금지 (fail-closed)
    """
    errs = []

    # ① 축 누락 검사
    for r_i, r in enumerate(rounds):
        for post, scores in r.items():
            missing = set(AXES) - set(scores)
            if missing:
                errs.append(f"{r_i+1}회차 {post}: 축 누락 {missing}")

    # ② 근거 인용 없는 점수 차단 — 인용 못 하면 점수가 아니다
    for r in rounds:
        for post, scores in r.items():
            for ax, v in scores.items():
                if v != "N/A" and not quotes.get((post, ax)):
                    errs.append(f"{post}/{ax}: 근거 인용 없음 → not_checked 처리 필요")

    # ③ 축별 3회 일치율
    agree, total = 0, 0
    for post in rounds[0]:
        for ax in AXES:
            vals = [r[post][ax] for r in rounds]
            if "N/A" in vals:          # N/A 축은 분모에서 제외
                continue
            total += 1
            if len(set(vals)) == 1:
                agree += 1
    ratio = agree / max(total, 1)

    # ④ 0.80 미만 축은 점수 폐기
    weak = []
    for ax in AXES:
        vals_by_post = []
        for post in rounds[0]:
            vals = [r[post][ax] for r in rounds]
            if "N/A" not in vals:
                vals_by_post.append(len(set(vals)) == 1)
        if vals_by_post and sum(vals_by_post)/len(vals_by_post) < 0.80:
            weak.append(ax)

    if errs:
        raise SystemExit("채점 무효 — 제출 중단:\n" + "\n".join(errs))

    return {"agreement": round(ratio, 3),
            "weak_axes": weak,
            "publishable": ratio >= 0.80}
②번이 이번에 새로 넣은 것입니다. 근거 문장을 인용하지 못하는 점수는 점수가 아니라 인상입니다. 이 검사를 켜니 처음에 매긴 점수 몇 개가 실제로는 근거 없이 나온 것이었다는 게 드러났습니다.
(캡처 자리 ①: 축별 채점 결과 표 — 편 × 7축, N/A 표시 포함) (캡처 자리 ②: 게이트 스크립트 실행 화면 — 약한 축 탐지 출력)
결과와 배운 점
4-1. 결과 — 채점표가 세 번 깨졌습니다
이 작업의 산출물은 점수가 아니라 채점표의 결함 목록입니다. 순서대로 적습니다.
첫 번째 붕괴 — 천장효과. 5축으로 12편을 돌렸더니 만점이 여러 편 나왔습니다. 축이 나쁜 게 아니라 해상도가 부족했습니다. 셸 명령으로 수치를 뽑고, 자기 오류를 먼저 적고, 계획과 실행을 분리해 표기하는 글은 5축이 전부 2점으로 처리해 버립니다. 변별이 안 되는 채점표는 채점표가 아닙니다.
→ 조치: 「델타」축 추가. 지난 회차 대비 실제로 바뀐 것이 있는가. 0=측정만 / 1=판정 가능한 다음 시험을 설계 / 2=실제 변화 발생.
두 번째 붕괴 — 바닥효과. 반대편에서 터졌습니다. 작고 깔끔하게 완료한 글이 「실패공개」축에서 구조적으로 감점됐습니다. 실패가 없어야 좋은 작업인데, 실패가 있어야 점수를 주는 축이었으니까요.
→ 조치: 축을 둘로 가르고 N/A를 도입.
기존
수정
실패공개 (0~2)
자기반증 (0~2) — 자기 결론을 스스로 깨려 시도했는가
오류처리 (N/A 허용) — 실패가 발생했다면 어떻게 다뤘는가
not_checked가 아니라 N/A인 게 핵심입니다. 재려 했으나 못 잰 것과, 잴 대상이 애초에 없는 것은 다릅니다.
세 번째 붕괴 — 설계형 감점. 그런데 첫 번째 붕괴를 수습하려고 넣은 「델타」축이, 이번엔 제 글을 구조적으로 깎았습니다.
제 12편은 대부분 not_checked로 끝납니다. 4편 본문에는 이렇게 적혀 있습니다.
최종 상태:
not_checked— 그래프를 컴파일·실행하지 않았다.
정직한 표기이고 경계표시 축에서는 만점입니다. 그런데 델타 축에서는 0~1점입니다. 설계 자체가 산출물인 글에 "변화가 없다"고 감점하는 것이 맞는지가 걸립니다.
→ 조치: 보류. 지금은 "판정 가능한 다음 시험을 설계했으면 1점"까지만 인정하는데, 2점까지 열어야 할지 결론을 못 냈습니다. 열면 설계만 하고 실행 안 하는 상태에 만점을 주게 되고, 안 열면 설계 작업을 구조적으로 깎습니다. 4-4에 도움 요청으로 남깁니다.
4-2. 최종 7축
축
무엇을 보나
0점
2점
실측성
수치·상태가 측정된 것인가
형용사만
수치+출처+미검증 표기
재현가능성
독자가 따라 할 수 있나
결과만 서술
프롬프트·코드 전문 포함
자기반증
자기 결론을 스스로 깨려 했나
결론에서 멈춤
자기 가설을 반증할 측정을 추가
오류처리 (N/A 허용)
실패를 어떻게 다뤘나
언급만
원인+전파 범위+대응
경계표시
안 한 것을 안 했다고 하나
설계를 실행처럼
설계/실행/측정 3층 분리
독자이득
남이 가져갈 게 있나
자기 기록
남의 상황에 이식 가능한 규칙
델타
지난 회차 대비 바뀐 것
측정만
실제 변화 발생
4-3. 배운 점 & 나만의 꿀팁
① 루브릭을 만들기 전에 채점자를 검정하라. 가장 크게 배운 것입니다. 항목이 아니라 흔들림이 질적평가를 무너뜨립니다. 3회 독립 채점 → 축별 일치율 0.80이라는 관문을 앞에 두지 않으면, 나온 숫자를 믿을 근거가 없습니다.
② 기준 문구를 다듬지 말고 앵커를 붙여라. "근거가 충실한가"를 아무리 정교하게 서술해도 채점은 흔들립니다. 실제 문장 두 개(0점·2점)를 박아 두면 판단이 "위냐 아래냐"로 단순해집니다. 앵커는 문구 수정보다 몇 배 효과가 큽니다.
③ 앵커는 내 글에서 뽑는 게 낫다. 남의 글에서 뽑으면 남을 깎게 되고, 무엇보다 내 문체 안에서의 상하 기준이 안 잡힙니다. 옛 글에서 0점을 꺼내는 일은 껄끄럽지만, 그렇게 잡은 기준이 실제로 가장 잘 맞았습니다.
④ 총점으로 합치지 마라. 축별 점수를 합치는 순간 상쇄가 일어나 "무엇이 나빴는지"가 사라집니다. 고칠 자리를 지목하는 게 목적인데 총점은 지목을 못 합니다.
⑤ 가중치를 정하지 말고 하드게이트로 빼라. 축 간 가중치는 근거를 만들 수 없습니다. 명확한 위반(설계를 실행으로 서술, 미검증 수치 무표기)은 점수를 깎는 게 아니라 발행을 막는 쪽이 맞습니다.
⑥ 인용 못 하는 점수는 점수가 아니다. 근거 문장을 본문에서 그대로 못 뽑으면 그건 인상입니다. 게이트 ②번을 켜니 제가 매긴 점수 중 몇 개가 실제로 그랬습니다.
⑦ 어느 축이 낮을지 예상하지 마라. 예상하면 그걸 확인하는 방향으로 채점이 기웁니다. 채점자가 하나뿐이면 더 심합니다. 저는 작업 중에 이걸 어길 뻔했고, 프롬프트에 넣어 둔 한 줄이 막았습니다.
4-4. 시행착오
내 규칙을 내가 어길 뻔했습니다. ⑦번 그대로입니다. "실측성은 높고 델타는 낮을 것 같다"는 말이 나오려던 순간, 프롬프트의 마지막 줄이 걸렸습니다. 규칙을 문서에 적어 두는 것과 그 규칙이 실제로 작동하는 것은 다른 사건인데, 이번엔 작동했습니다.
초안과 발행본을 혼동할 뻔했습니다. 채점을 시작할 때 손에 있던 것은 제 초안 파일이었습니다. 발행본은 그 뒤에 손댄 버전이라 다를 수 있습니다. 실제로 실측성 축의 판정이 갈리는 지점이 정확히 여기입니다 — 초안에는 "게시 전 서버 COUNT로 확정하세요"라는 조건이 붙어 있고, 발행본에 그 표기가 남았는지 아닌지로 하드게이트 통과 여부가 뒤집힙니다. 초안 채점은 무효로 하고 발행본으로 다시 잡았습니다.
채점자가 저 하나입니다. 3회 독립 채점이라고 해도 같은 사람이 같은 날 하면 독립이 아닙니다. 날짜를 벌리고 순서를 섞는 것으로 완화했지만 완전히 못 없앱니다. 이 한계는 글에 적어 두는 게 맞다고 봅니다.
루브릭이 세 번 깨졌다는 게 실패처럼 보였습니다. 처음엔 그렇게 느꼈습니다. 그런데 세 번의 붕괴가 각각 다른 종류의 글에서 나왔고, 그 셋을 다 겪고서야 축이 서로 독립적으로 움직이기 시작했습니다. 실측성 만점인데 자기반증 0점인 조합이 처음 나온 게 세 번째 수정 뒤였습니다. 붕괴가 없었으면 지금도 만점만 찍는 표를 쓰고 있었을 겁니다.
4-5. 도움이 필요한 부분
① 설계형 산출물을 델타 축에서 어떻게 다룰지. 세 번째 붕괴의 미해결 항목입니다. 설계·규율 설정이 그 자체로 산출물인 글에, "실제 변화가 없다"는 감점이 맞습니까. N/A를 허용하면 실행 안 하는 상태에 면죄부를 주는 것 같고, 안 하면 설계 작업이 구조적으로 깎입니다. 비슷한 판단을 해보신 분의 기준이 궁금합니다.
② 채점자 1인 환경에서의 독립성 확보. 같은 사람이 3회 채점할 때 앵커링을 줄이는 실무적 방법 — 날짜 간격, 순서 섞기 말고 다른 게 있을까요.
③ 재현성 목표 0.80의 근거. 제가 임의로 정한 숫자입니다. 축별 3회 일치율에 통용되는 기준선이 있는지, 아니면 몇 편부터 이 비율이 의미를 갖는지 모릅니다. 표본 12편이 이 판정을 하기에 충분한지부터 확신이 없습니다.
< 앞으로의 계획 >
순위
항목
완료 조건
1
재현성 3회 검정
축별 일치율 0.80 확인. 미달 축은 점수 폐기
2
발행본 24건으로 확대
초기 12편 포함. 시계열로 유형 전환점 확인
3
하드게이트 전건 점검
특히 G2 — 세 가지로 갈린 누적 건수의 표기 여부
4
델타 축 결론
설계형 산출물 처리 방식 확정
5
분기 1회 정례화
3개월 뒤 같은 루브릭으로 재측정
5번에서 확인할 것은 점수 상승이 아닙니다. 측정 기준이 그사이 움직이지 않았는지를 먼저 봅니다. 기준이 헐거워지면 점수는 저절로 오릅니다.
그리고 2번에서 기대하는 것이 하나 있습니다. 초기 사례글은 데이터 구축 기록이고 최근 12편은 설계·규율 기록이라 한 사람 안에서 글의 유형이 바뀌었을 가능성이 있습니다. 그 전환점이 어디였고 무엇이 계기였는지는 총점으로는 절대 안 나오고, 축별 시계열로만 보입니다.
도움 받은 글 (옵션)
지피터스 에이전트 하네스반 강의 — 판정 어휘 고정, 인터페이스 카드의 MUST NOT 필드, fail-closed 게이트, 성장 루프. 이 채점표의 골격 전부가 여기서 나왔습니다.
(내부) 반성문 총괄표 — 35건·18패턴 누적. 특히 제35호 "문서에 적힌 검증을 코드가 실제로 하는지 확인하지 않음"이 자기반증 축의 2점 앵커가 됐습니다.
(내부) 지식관리 수정대상 체크리스트 — 하드게이트 G2(미검증 수치)의 근거. 같은 누적 건수가 세 가지로 갈려 있다는 미해결 항목이 여기 있습니다.
(내부) 통변 리뷰 노드 설계 문서 — 5축 루브릭·하드게이트 구조를 발행물로 이식한 원본.
