[AI 교차검수] AI가 써준 글, 그대로 믿어도 될까? — 초안을 다른 AI로 검수했더니 사실 오류 9건
[AI 교차검수] AI가 써준 글, 그대로 믿어도 될까? — 초안을 다른 AI로 검수했더니 사실 오류 9건
한줄 요약
AI 도구 3종(Antigravity·Claude Code·Cursor)에게 "너는 내 대화를 어떻게 저장하니?"를 물어 사례글 초안을 Claude Code로 작성한 뒤, 바로 올리지 않고 Cursor로 교차 검수했더니 사실 오류·과장·왜곡 9건이 나왔습니다. "AI가 쓴 결과물을 어떻게 검수할 것인가"에 대한 실전 기록입니다.
이런 분들께 도움돼요
AI가 써준 글·보고서를 그대로 올려도 되나 불안했던 분 (팩트체크·결과물 검수)
작성 AI와 검수 AI를 나누는 교차검증 방법이 궁금한 분
내 AI 대화가 어디에 저장되고 외부로 나가는지(데이터 주권)도 겸사겸사 알고 싶은 분
소개: 무엇을, 왜 하려 했나
문제 상황 (Before)
요즘 AI에게 글·보고서·정리 문서를 자주 맡깁니다. 문제는 결과물이 너무 매끄럽다는 거예요. 술술 읽히니까 "맞겠지" 하고 넘어가게 됩니다. 그런데 정말 사실일까요?
이번엔 그걸 실험해봤습니다. 소재는 마침 궁금하던 주제 — "내가 매일 쓰는 AI 도구들은 내 대화를 대체 어디에 저장하나?" 였습니다.
데이터 주권: 내 코드·기획이 담긴 대화가 나도 모르게 외부에 쌓이는 건 아닐까?
자산화: 대화가 도구 UI 안에만 갇혀 있으면 백업도 검색도 안 됩니다. 로컬 파일로 남아야 자산이 됩니다.
설계 참고: 내 프로젝트에 "대화 저장" 구조를 만들 참이라, 잘 만든 도구들의 실제 파일 구조가 궁금했습니다.
계기
자료를 AI로 모으고 → AI로 초안을 쓴 다음 → 다른 AI로 검수까지, 3단계를 한 번 돌려보기로 했습니다. "AI 결과물은 믿을 만한가"를 직접 확인하는 게 진짜 목적이었죠.
진행 방법
사용한 도구
Antigravity (Gemini 기반 IDE) · Claude Code (Anthropic CLI) · Cursor (AI 코드 에디터)
자료 수집 → 초안 작성은 Claude Code, 최종 검수는 Cursor (일부러 다른 AI에 맡김)
1단계 — 3개 AI에게 "너는 대화를 어떻게 저장하니?" 묻기
질문의 각도는 도구마다 조금씩 달랐고, 그래서 답변 성격도 달랐습니다.
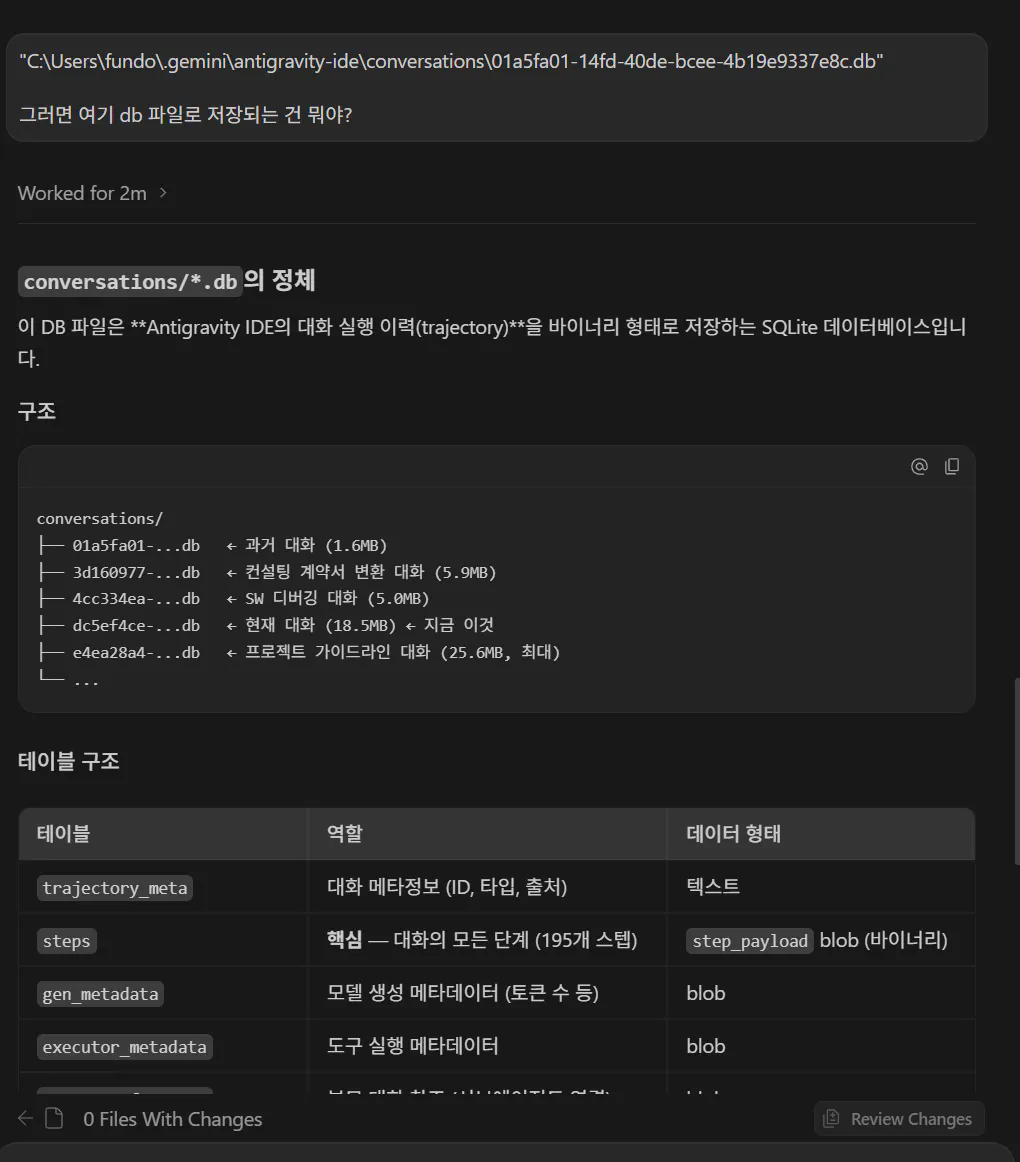
① Antigravity — 자기 경로를 실제로 열어 보여주다
내 대화 저장 구조를 설명해줘. 그리고 conversations/*.db 파일로 저장되는 건 뭐야?
자기 파일 경로를 직접 열어 4층 구조를 정리해줬습니다. (전부 C:\Users\fundo\.gemini\antigravity-ide\ 하위)
🖼️ [이미지 ①] Antigravity가 자기 저장 경로·DB 구조를 실제로 열어 설명하는 화면
로그가 둘로 나뉨: transcript.jsonl은 토큰 절약용(긴 출력은 잘림), transcript_full.jsonl은 완전한 원문 보존본.
역할 분리: JSONL은 사람이 grep 하는 로그, .db는 IDE가 화면을 복원하는 바이너리. 둘 다 로컬에만 있습니다.
원본 답변 표현 그대로 "외부 서버에 대화 이력이 영구 저장되지 않는다" 고 했습니다. (단, 이건 '저장' 이야기일 뿐, 추론 과정에서 내용이 전송되는지는 별개입니다.)
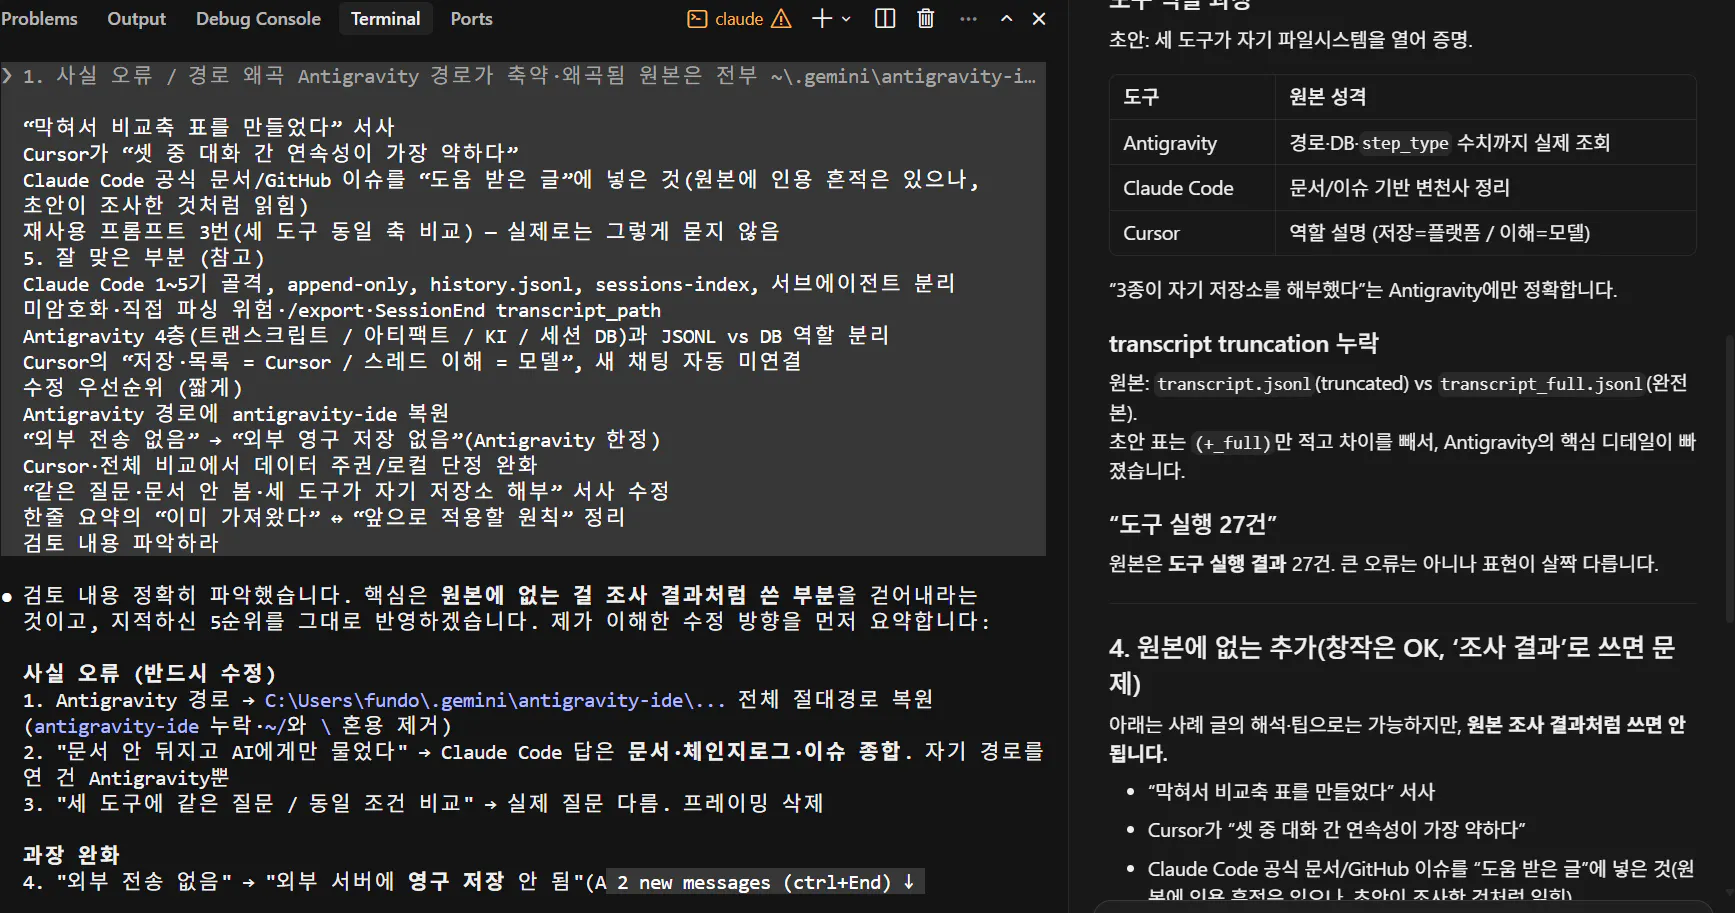
② Claude Code — 저장 방식 '변천사'를 정리해주다
Claude Code의 대화 내용 저장 방식 변천사를 알고 싶다.
이 답은 Antigravity와 성격이 달랐습니다. 자기 파일을 연 게 아니라, 공식 문서·체인지로그·GitHub 이슈를 종합한 정리였어요. ("공식 변천사 문서는 따로 없다"고 전제)
🖼️ [이미지 ②] Claude Code가 저장 방식 변천사 1~5기를 정리해준 답변 화면
1기 — ~/.claude.json 단일 파일에 전부 (커질수록 느려지고 깨짐)
2기 — 세션별 JSONL로 분리. append-only(덧붙이기) 방식이라 크래시가 나도 마지막 줄만 손실
3기 — 입력 이력을 history.jsonl로 분가
4기 — 인덱스 파일 + 서브에이전트 로그 분리
5기 — 세션을 이름 붙이고 복제·되감기 가능한 객체로
덤으로 얻은 주의점도 컸습니다.
트랜스크립트는 암호화 안 됨 → .env·비밀번호가 로그에 그대로 남을 수 있음
내부 포맷은 버전마다 바뀌니 직접 파싱 대신/export나 종료 훅(transcript_path) 사용 권장
③ Cursor — "저장은 도구, 이해는 나"
너는 대화 내용을 어떻게 저장·관리하니?
이건 경로도 변천사도 아닌 역할 설명이었습니다. 모델이 파일을 직접 만들지 않고, Cursor(플랫폼)가 채팅 히스토리를 저장하며, 과거 Agent 대화는 프로젝트별 로컬 기록으로 남기도 한다고 했습니다. 새 채팅은 이전 대화를 자동으로 잇지 않고요. (외부 저장·동기화 여부는 언급 없음.)
2단계 — ⭐ 결과물 검수: 초안을 Cursor로 교차 검증하기
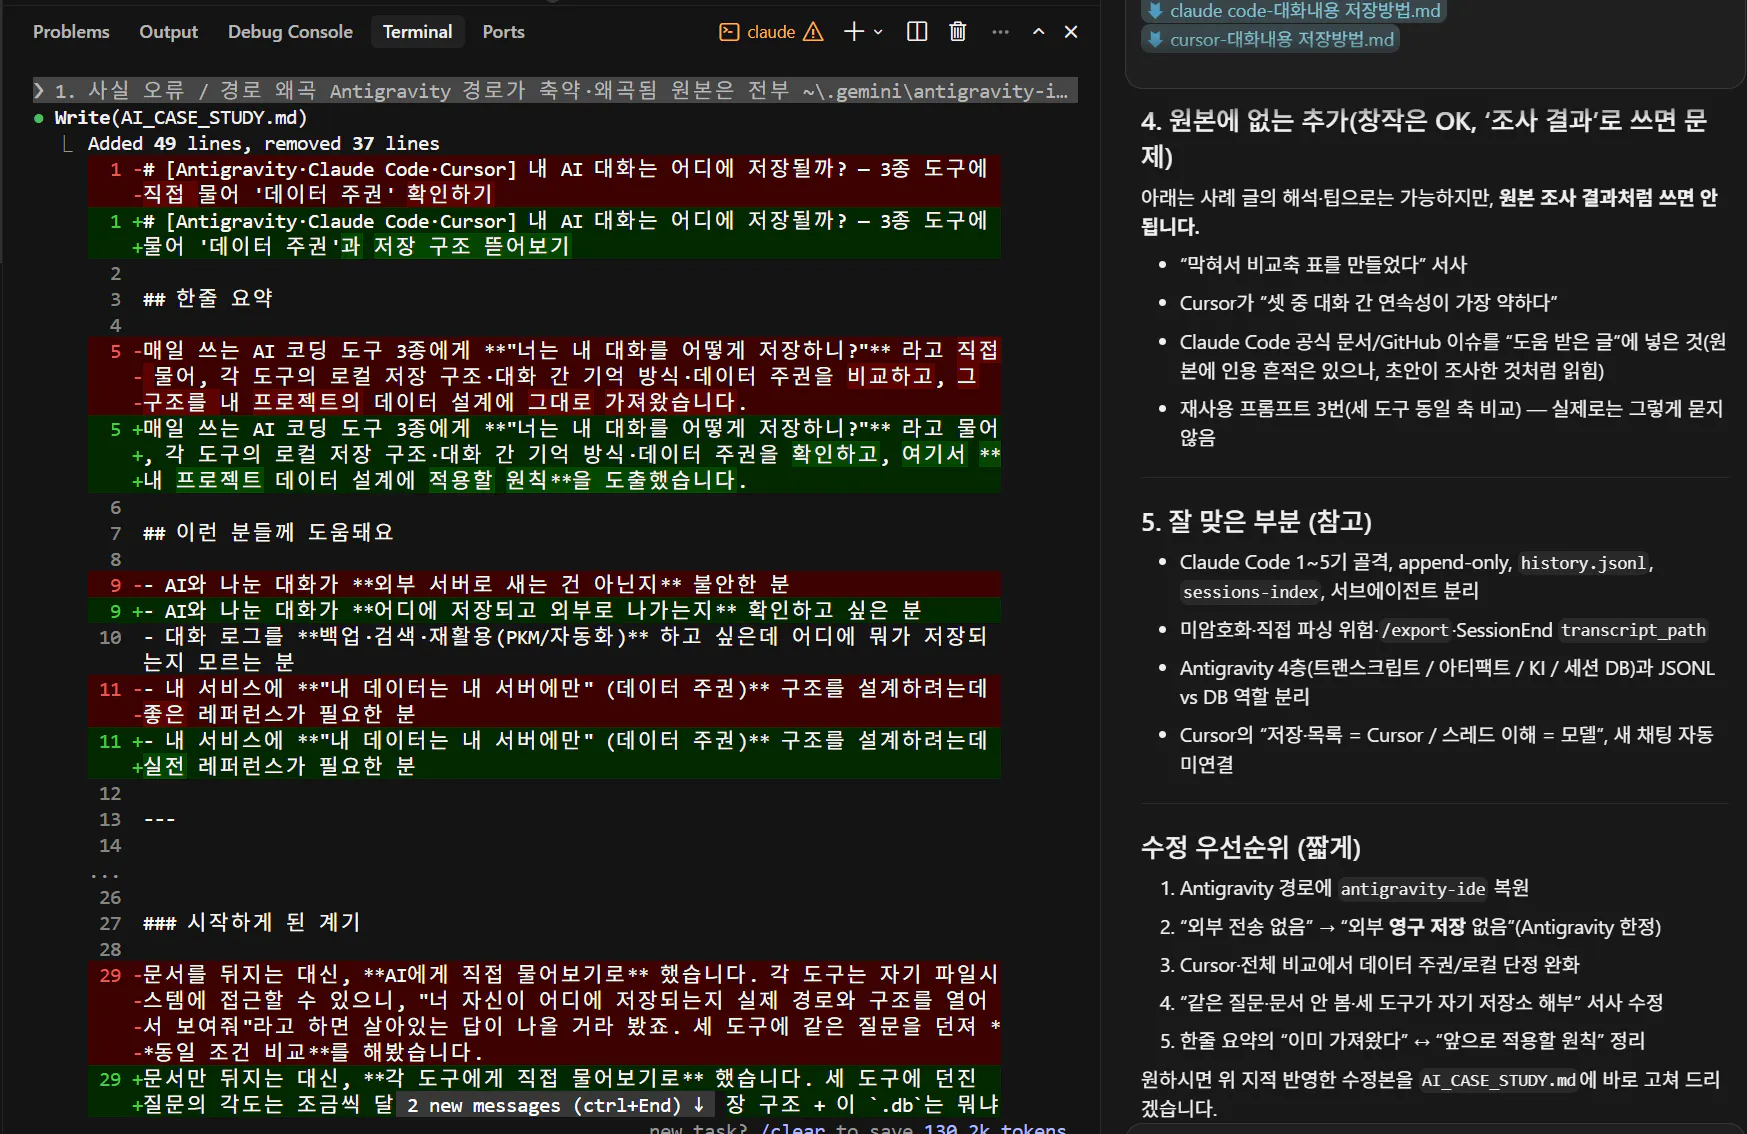
여기가 이 사례의 핵심입니다. 위 답변으로 Claude Code가 초안을 완성했는데, 바로 올리지 않았습니다. 원본 3개 문서와 초안을 함께 놓고, 일부러 다른 AI인 Cursor에게 검수를 맡겼어요.
이 초안이 원본 3개 문서와 비교해 사실 오류·과장·왜곡·내부 모순이 없는지 검수해줘. 항목별로 "초안 vs 원본"을 대조하고 수정 우선순위도 알려줘.
🖼️ [이미지 ③ ⭐핵심] Cursor가 초안을 원본과 대조하며 오류를 지적하는 검수 화면
한국어 웹사이트 스크린샷
결과는 충격이었습니다. Cursor가 유형별로 9건을 잡아냈어요. 문장이 매끄러워서 저 스스로는 전혀 못 본 오류들이었습니다.
유형
Cursor가 잡은 문제
경로 왜곡
Antigravity 경로에서 antigravity-ide가 빠지고 표기가 뒤섞임
사실 오류
"문서 안 보고 AI에게만 물었다" (실제론 문서·이슈 종합)
사실 오류
"세 도구에 같은 질문" (실제 질문은 도구마다 달랐음)
과장
"외부 전송 없음" (원본은 "영구저장 없음"까지만)
과잉 일반화
"세 도구 모두 로컬·데이터 주권" (Cursor엔 근거 없음)
단정
"agent-transcripts에 남는다" (원본은 "남기도 함")
내부 모순
요약 "그대로 가져왔다" ↔ 계획 "앞으로 재설계"
디테일 누락
로그 잘림본 vs 완전본 차이가 빠짐
창작 혼입
겪지도 않은 "막힌 순간"을 조사 결과처럼 서술
📊 검수 전 vs 검수 후 (Before / After)
항목
❌ 검수 전 초안
✅ 검수 후
Antigravity 경로
축약·왜곡
정확한 절대경로 복원
Claude Code 답 성격
"AI에게만 물음"
"문서·이슈 종합" 명시
질문 프레이밍
"같은 질문"
도구마다 달랐음 명시
데이터 주권
"세 도구 모두 전송 없음"
"Antigravity만 영구저장 없음, Cursor는 언급 없음"
요약 ↔ 계획
모순
"원칙 도출"로 통일
창작 서사
조사 결과처럼
해석·파생임을 명시
미확인 항목
"없다"고 단정
"언급 없음"으로 구분
사실 오류
9건
0건 (전부 수정)
🖼️ [이미지 ④] 지적 9건 → 수정 완료 대조표 (또는 초안 수정 diff 화면)
한국 컴퓨터 화면의 스크린샷
느낀 점: AI가 쓴 글은 매끄러울수록 검증이 더 어렵습니다. '그럴듯함'이 '정확함'을 가려버리니까요. 그런데 초안을 쓴 AI(Claude Code)와 검수한 AI(Cursor)를 다르게 했더니, 같은 모델이면 그냥 넘어갔을 자기 확신 오류가 드러났습니다. 검수 후 초안은 사실상 다른 글이 됐습니다.
인상적이었던 순간
Antigravity가 자기 세션 .db를 열어 내부 테이블의 단계 분포(모델 응답 89건, 도구 실행 결과 27건, 사용자 입력 20건…)까지 실제 수치로 뽑아준 순간이었습니다. AI가 자기 저장소를 스스로 해부해 보여준다는 게 신기했어요. (이 정도로 파고든 건 세 도구 중 Antigravity뿐이었습니다.)
막혔던 순간과 해결
세 답변의 성격이 제각각(경로 해부 / 문서 종합 / 역할 설명)이라 그냥 나열하니 "그래서 뭐가 다른데?"가 안 보였습니다. → 같은 비교 축(저장 위치·형식·검색·기억·외부저장)으로 표를 만들어 정렬하니 차이가 한눈에 드러났습니다.
결과와 배운 점
세 도구 비교 요약
🖼️ [이미지 ⑤] 세 도구 저장 방식을 한 축으로 정렬한 비교 표
비교 축
Antigravity
Claude Code
Cursor
저장 위치
...\antigravity-ide\ (로컬)
~/.claude\projects\ (로컬)
플랫폼 + 로컬 기록(남기도 함)
형식
JSONL(+완전본) + MD + SQLite
append-only JSONL
채팅 히스토리 + *.jsonl
검색
grep
grep + 인덱스
UI 히스토리
대화 간 기억
KI 자동 로드
/resume·--fork
기본 미연속(수동 참조)
외부 영구저장
없음(원본 명시)
로컬, 단 미암호화
원본 언급 없음
"언급 없음"은 "안전하다"가 아니라 "확인 안 됨"이라는 뜻입니다.
배운 점 (이 사례의 핵심)
AI 초안은 반드시 원문과 대조 검수한다 — 특히 경로·수치·인용·날짜는 그럴듯하게 틀립니다. 매끄러운 문장일수록 의심하세요.
작성 AI ≠ 검수 AI — 같은 모델은 자기 오류를 방어합니다. 다른 도구로 교차검수할 때 오류가 가장 잘 드러났습니다.
"언급 없음"과 "없음"을 구분 — 확인 안 된 걸 단정하지 않기. ("영구저장 없음"이 "전송 없음"은 아님)
창작과 사실을 섞지 말기 — 해석·팁은 좋지만, 원본에 없는 서사를 '조사한 사실'처럼 쓰면 글 전체 신뢰가 무너집니다.
덤으로 얻은 설계 원칙 (내 프로젝트에 적용 예정)
append-only로 시작하라 — 덮어쓰기 대신 한 줄씩 덧붙이면 크래시에 강하고 원문이 보존됩니다.
역할별로 저장소를 분리하라 — 사람이 읽는 로그 / 앱이 복원하는 상태 / 재사용 기억을 각각 따로.
데이터 위치를 확인하고 로컬 우선을 기본값으로 — 단, 확인 안 되면 "모른다"로 남겨둘 것.
앞으로의 계획
종료 훅 / n8n으로 대화 로그 자동 아카이빙 → 검색 가능한 PKM으로 축적
내 프로젝트 저장 스키마를 append-only + 역할 분리 + 기억 계층으로 설계
재사용 가능한 프롬프트
1·2번은 실제로 쓴 질문, 3번은 비교용 파생 템플릿, 4번이 이 사례의 핵심입니다. 대괄호는 본인 상황에 맞게 바꾸세요.
프롬프트 1 — 도구의 저장 구조 해부
너는 내 대화 내용을 어떻게 저장·관리하니?
실제 파일 경로와 디렉터리 구조를 직접 열어서 보여주고,
각 파일/DB의 역할과 외부 전송·저장 데이터가 있는지 정리해줘.
프롬프트 2 — 저장 방식 '변천사'로 설계 의도 파악
[도구명]의 대화 저장 방식 변천사를 알고 싶다.
초기부터 현재까지 어떻게, 왜(성능/안정성/기능) 바뀌었는지 정리하고,
근거가 실제 파일 확인인지 문서·이슈 종합인지도 밝혀줘.
프롬프트 3 — 여러 도구 같은 축으로 비교
[도구 A], [도구 B], [도구 C]의 저장 방식을 다음 축으로 표 비교해줘:
저장 위치 / 형식 / 검색 / 대화 간 기억 / 외부 영구저장 여부.
확인 안 된 항목은 "언급 없음"으로 남겨줘.
프롬프트 4 — ⭐ AI 결과물 교차 검수 (다른 AI에게)
[원본 자료]와 [작성된 초안]을 함께 검토해줘.
항목별로 "초안 vs 원본"을 대조해서 아래가 없는지 찾아줘:
1) 사실 오류·경로/수치/인용 왜곡
2) 과장·과도한 일반화(확인 안 된 걸 단정)
3) 내부 모순
4) 원본에 없는 창작을 '조사 결과'처럼 쓴 부분
각 지적마다 수정 방향과 우선순위도 알려줘.
💡 작성한 AI와 다른 AI에게 맡기세요. 자기가 쓴 오류는 스스로 잘 못 봅니다.
마무리
AI에게 일을 시키는 것만큼, AI 결과물을 검수하는 것도 하나의 실력이 되어가는 것 같습니다. 이번처럼 "작성 → 다른 AI로 검수" 한 단계만 더 붙여도 결과물의 신뢰도가 크게 올라갑니다. 여러분도 AI가 써준 글, 올리기 전에 다른 AI에게 한 번 검수시켜 보세요. 🙂
📌 이미지 넣는 곳: ① Antigravity 경로 설명 · ② Claude Code 변천사 · ③ Cursor 검수 화면(핵심) · ④ Before/After · ⑤ 비교 표 — 본문 🖼️ 표시 자리에 드래그하면 됩니다.