


📖 소개
저는 ‘작성한 글’ 화면에 원고가 네 건뿐인 상태에서 다음 문제를 먼저 봤습니다. 지금처럼 넓은 카드로 계속 보여주면 원고가 수백 건으로 늘었을 때 찾기와 관리가 어려워지고, 상용화 후 여러 고객이 수천 건씩 쌓기 시작하면 화면뿐 아니라 저장 방식도 한계에 부딪힐 수 있다는 점이었습니다.
그래서 이번 대화에서는 화면을 조금 다듬는 수준을 넘어, 이 도구를 고객 홈페이지의 관리자 화면에 연결하는 콘텐츠 SaaS로 확장할 때 필요한 구조를 검토했습니다. 날짜·카테고리·상태·검색 필터, 서버 원본 저장, 고객별 데이터 격리, 수백만 건 확장, 인프라 비용, 고객이 자신의 AI API 비용을 부담하는 BYOK까지 하나의 흐름으로 정리했습니다.
이번 사례의 결과는 기능 배포가 아닙니다. 현재 코드의 위험 요소를 확인하고, 이후 개발에서 기준으로 사용할 상용화 기획 문서와 아키텍처 방향 검토 문서를 만든 것이 결과입니다.
🛠️ 진행 방법
Codex와 함께 현재 프로젝트의 화면, Neon PostgreSQL 저장 구조, 브라우저 로컬 저장, 이미지 저장 방식을 확인했습니다. 먼저 ‘작성한 글’을 카드 갤러리가 아니라 검색 가능한 콘텐츠 관리함으로 다시 정의했습니다. 그다음 홈페이지 관리자 로그인과 연결했을 때 데이터의 원본을 어디에 둘지, 여러 고객을 어떤 키로 격리할지, 데이터와 비용이 커질 때 어떤 순서로 확장할지를 검토했습니다.
대화에서 나온 제안은 곧바로 확정 사항으로 취급하지 않았습니다. 제가 요구한 방향, Codex가 권장한 구조, 아직 결정하지 않은 요금제와 보관 정책을 문서에서 구분했습니다.
프롬프트 1 — 원고가 수천 건으로 늘어나는 상황부터 질문하기
덱스야, 이제부터 또 수정할 거 알려줄게.
첨부한 이미지 보면 앞으로 작성한 글들이 점점 많아질 건데, 이렇게 카드 형식으로 넓게 만들 필요가 있어? 많아지면 어떻게 하려고 그래?
그리고 저장은 지금 DB로 쌓이는 구조일 거 아니야? 그러면 나중에 이걸 내가 상용화했을 때, 계속 만들어낸 게 날짜별로 쌓이든지 어떤 분류 구조 같은 게 있어야 되지 않아?
내가 상용화를 해야 되고, 블로그가 한두 글이 아니라 수백 수천 건이 쌓인다는 전제하에 그런 구조까지 생각해서 제안해 봐.
현재 네 건을 보기 좋은 화면이 아니라, 실제 서비스에서 수천 건을 관리하는 조건으로 UI와 DB를 함께 검토하게 한 질문입니다.
프롬프트 2 — 고객 컴퓨터와 서버 중 원본 저장소 결정하기
나는 나중에 홈페이지를 만들어주면서 이 블로그 콘텐츠, 그러니까 키워드 레이더부터 콘텐츠 생성기를 쉽게 연결해서 붙이고 싶어. 즉, 홈페이지의 어드민으로 로그인했을 때 그 안에서 이 기능들이 로그인한 관리자에 의해서만 작동하게 하고 싶은 거지.
여기서 중요한 건 DB 구조와 프로그램 저장 방식이야:
프로그램과 데이터를 각 사용자의 컴퓨터에 저장되게 하는 게 맞을까, 아니면 서버에 저장하는 게 맞을까?
사업자인 내가 그 모든 고객들의 발행 콘텐츠를 내 서버에 담아두는 게 맞을까, 아니면 그들의 컴퓨터에 담아두게 하는 게 맞을까?
제품의 설치 방식과 데이터 책임 범위를 정하기 위해, 원본 데이터의 위치를 직접 비교한 질문입니다.
한국사이트 스크린샷
프롬프트 3 — 고객이 AI 사용료를 직접 부담하는 방식 검토하기
만약에 원가 계산은 나중에 좀 더 예민하게 해봐야 되겠지만, 블로그 콘텐츠를 만들어주는 로직을 제공할 때 AI 비용은 고객의 AI 구독비로 연결해서 처리하게 하면 어떨까?
설치해 줄 때 좀 복잡해지려나?
AI 비용이 고객 수와 생성량에 따라 커지는 문제를 보고, 고객 API 키를 연결하는 BYOK의 운영 난이도까지 확인한 질문입니다.
한국사이트 스크린샷
💡 결과와 배운 점
1. 원고 보관함은 카드 화면이 아니라 검색 가능한 콘텐츠 관리함이어야 했습니다
‘오늘’, ‘이번 주’, ‘이번 달’은 원고의 순서를 바꾸는 정렬이 아니라 해당 기간의 원고만 남기는 필터입니다. 여기에 카테고리, 상태, 블로그, 제목·키워드 검색을 조합하고, 결과 안에서 최근 수정순이나 생성순으로 정렬하는 구조가 필요했습니다. 현재 DB에는 카테고리 값이 있지만 화면과 서버 조회에는 필터가 아직 없다는 점도 확인했습니다.
목록에서는 제목, 카테고리, 상태, 생성일, 수정일 같은 요약 정보만 25~50건씩 가져오고, 원고를 열 때 본문과 버전을 조회해야 합니다. 넓은 카드는 보조 보기로 남길 수 있지만 기본 관리는 한 줄 목록과 검색이 더 적합합니다.
한국사이트 스크린샷
2. 서버를 원본 저장소로 두는 운영 방향을 정했습니다
제가 만들려는 제품은 고객 홈페이지의 관리자 계정으로 로그인해 사용하는 서비스입니다. 이 조건에서는 프로그램과 원고의 원본을 서버에 두는 중앙형 SaaS가 맞았습니다. 고객 컴퓨터만 원본으로 사용하면 기기 교체, 백업, 협업, 모바일 접근, 업데이트, 사용량 관리가 모두 어려워집니다.
다만 서버에 저장한다고 해서 콘텐츠의 소유권이 제게 넘어오는 것은 아닙니다. 콘텐츠 소유자는 고객이고, 제 서비스는 계약에 따라 보관하고 처리하는 운영자라는 경계를 명확히 해야 합니다. 데이터 내보내기, 계약 종료 후 삭제, 백업, 감사 기록, 비공개 이미지 접근 정책도 제품 기능에 포함해야 합니다.
3. 워크스페이스 격리를 권장 구조로 정리했습니다
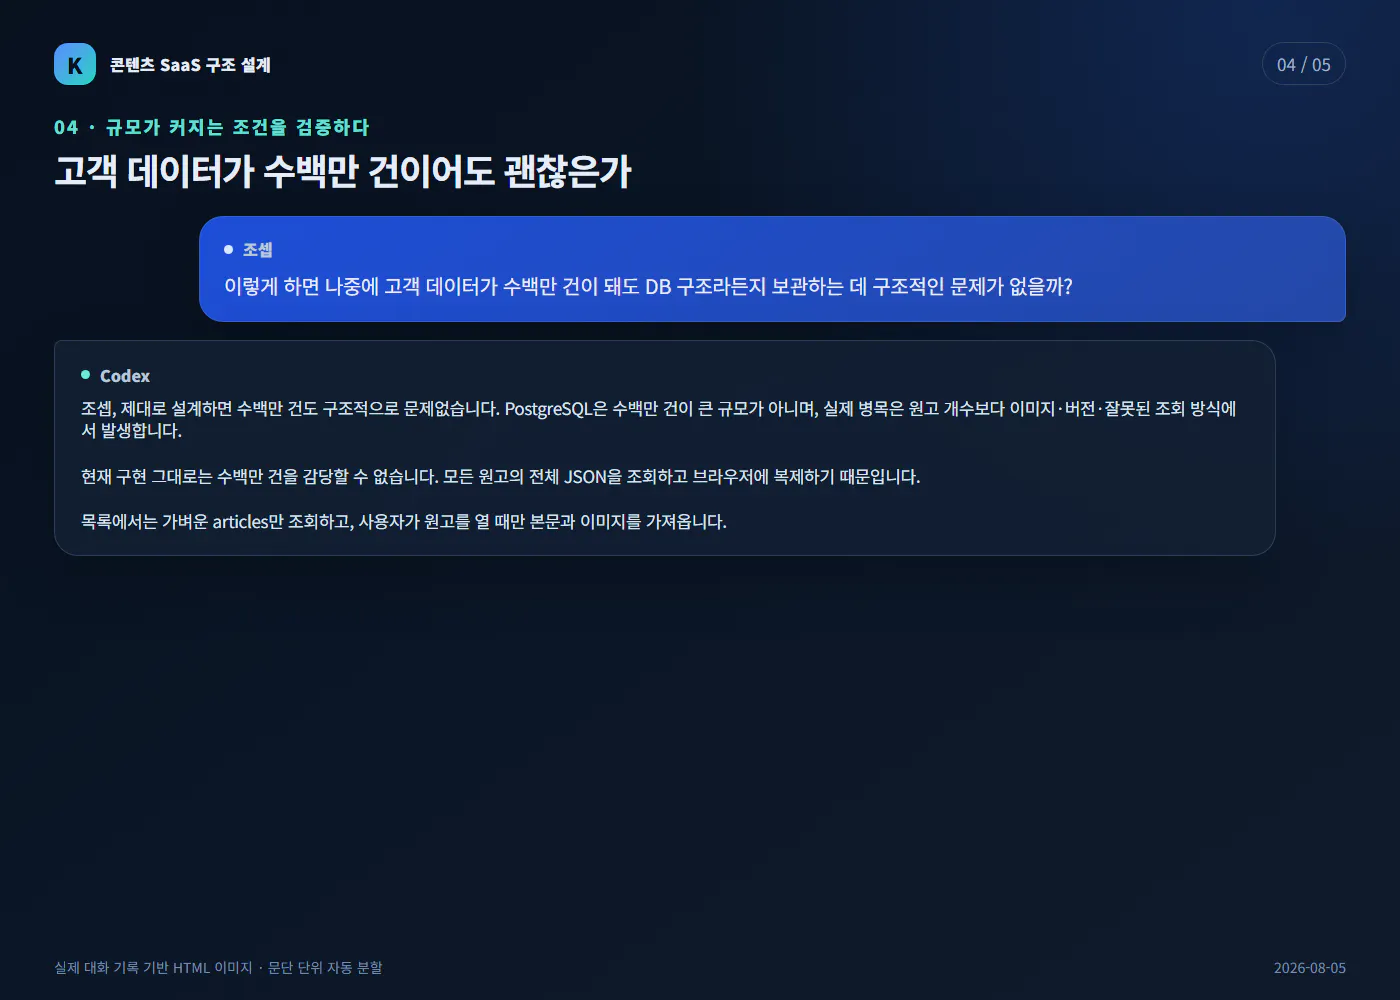
초기에는 고객마다 별도 데이터베이스를 만드는 대신 하나의 PostgreSQL에서 모든 주요 데이터에 workspace_id를 넣는 다중 고객 구조가 적합합니다. 로그인한 사용자의 workspace_id를 모든 조회 조건에 강제하면 고객이 늘어날 때마다 테이블이나 프로그램을 새로 만들 필요가 없습니다.
Codex는 원고 목록용 articles, 본문용 article_contents, 주요 수정 이력용 article_versions, 이미지 메타데이터용 assets, 발행 기록용 publications를 분리하는 방안을 제안했습니다. 실제 이미지는 객체 저장소에 두고 DB에는 경로와 메타데이터만 남기는 방향입니다. 저는 이 제안을 이후 구현의 기준으로 정리했으며, 전체 원고 JSON을 한 번에 가져와 브라우저 localStorage에 복제하는 현재 방식은 상용화 전에 제거하기로 했습니다.
수백만 건 자체보다 전체 조회, 잘못된 인덱스, 과도한 버전, 이미지 파일을 DB에 넣는 방식이 더 큰 위험이라는 점도 배웠습니다. 처음부터 모든 데이터를 나누기보다 단일 PostgreSQL과 복합 인덱스, 커서 페이지네이션으로 시작하고, 실제 병목이 나타날 때 파티셔닝·읽기 복제본·검색 서버·샤딩 순서로 확장하는 편이 합리적입니다.
한국사이트 스크린샷
4. 저장 비용보다 AI 생성 비용을 먼저 통제해야 했습니다
대화 당시 공식 요금을 기준으로 계산했을 때, 원고 본문과 이미지 파일을 보관하는 비용보다 원고와 이미지의 신규 생성·재생성 비용이 더 빠르게 증가했습니다. 따라서 상품을 설계할 때 고객 수만 세는 방식으로는 부족합니다. 고객별 원고 생성 수, 이미지 장수와 재생성, AI 사용액, 저장공간을 별도의 사용량 원장으로 기록해야 합니다.
무제한 생성 상품보다 월 원고 수와 이미지 크레딧을 정하고, 70%·90%·100% 사용 알림과 월 지출 한도를 제공하는 편이 손익과 장애 대응에 유리합니다. 구체적인 원가는 모델 가격과 실제 토큰 사용량이 달라질 수 있으므로 출시 직전에 다시 산정해야 합니다.
5. ChatGPT 구독 연결과 BYOK는 다른 개념이었습니다
고객의 ChatGPT Plus나 Business 구독을 서비스의 API 비용으로 연결할 수는 없습니다. BYOK를 제공하려면 고객이 OpenAI API에서 별도 프로젝트와 결제를 설정하고 프로젝트 전용 API 키를 발급해야 합니다. 키는 브라우저나 고객 홈페이지의 공개 환경에 두지 않고 중앙 서버가 암호화해 보관하며, 해당 고객의 생성 요청에만 사용해야 합니다.
비개발자 고객에게 BYOK만 강제하면 가입과 결제, 키 오류, 잔액 부족에서 이탈과 문의가 늘 수 있습니다. 그래서 기본 상품은 제 서비스의 AI 크레딧을 포함하고, 사용량이 많은 고객은 자신의 API 키를 연결할 수 있는 혼합형이 적합하다는 권장안을 남겼습니다. BYOK 채택 여부와 할인 구조는 아직 확정하지 않았습니다.
시행착오: 처음에는 카드 크기와 날짜별 분류가 중심 문제처럼 보였지만, 코드를 확인하자 모든 원고의 전체 JSON 조회, 브라우저 전체 복제, personal 고정 소유자, 공개 이미지 저장이 더 먼저 해결할 문제였습니다.
도움 필요한 부분: 인증 방식, 고객별 권한 등급, 휴지통 보존 기간, 개인정보가 포함되는 실제 범위, BYOK의 상품 정책은 출시 전에 추가 결정과 법률·보안 검토가 필요합니다.
앞으로의 계획: 로그인과 workspace_id 격리부터 적용한 뒤 요약 목록 API, 검색·필터·커서 페이지네이션, 비공개 이미지, 내보내기·삭제 정책, 사용량·과금 순으로 구현할 계획입니다.
논의 결과는 프로젝트의 상용화 기획, 서버 저장·멀티테넌시 방향, AI 비용·BYOK 검토 문서로 나눠 저장했습니다. 확정 사항과 권장 사항, 미결 사항을 분리했기 때문에 이후 개발자가 대화 맥락 없이도 결정 상태를 확인할 수 있습니다.
📚 도움 받은 글 (옵션)
PostgreSQL 테이블 파티셔닝 — 데이터가 매우 커졌을 때 파티셔닝을 도입할 조건을 확인했습니다.
PostgreSQL 데이터베이스 한계 — 수백만 행 자체보다 저장소와 쿼리 설계가 실제 제약이라는 판단에 참고했습니다.
OpenAI API 요금 — 서버 고정비와 AI 생성 변동비를 분리해 계산할 때 사용했습니다.
ChatGPT 구독과 API 결제 안내 — ChatGPT 구독료에 API 사용료가 포함되지 않는다는 점을 확인했습니다.
OpenAI API 키 보안 지침 — 고객 키를 브라우저에 노출하지 않고 서버에서 관리해야 하는 근거로 사용했습니다.
개인정보 보호법 제21조 — 보유 목적이 끝난 개인정보의 파기 원칙을 검토했습니다.
✅ Do (해야 할 것)
목록 조회용 요약 데이터와 원고 본문·버전·이미지를 분리하기
모든 핵심 테이블과 조회 조건에 workspace_id를 적용하기
날짜·카테고리·상태·블로그·검색어 필터를 서버 조회와 연결하기
고객별 AI 생성량·이미지 재생성·저장공간·비용을 기록하기
확정 사항·권장 사항·미결 사항을 개발 문서에서 구분하기
❌ Don't (하지 말아야 할 것)
모든 원고의 전체 JSON을 한 번에 조회해 브라우저에 복제하기
고객마다 처음부터 별도 DB와 별도 프로그램을 반복 설치하기
실제 이미지 파일을 PostgreSQL 본문 데이터와 함께 저장하기
ChatGPT 구독료가 OpenAI API 사용료까지 포함한다고 안내하기
BYOK 키를 브라우저·localStorage·공개 환경변수에 저장하기
