


https://www.gpters.org/nocode/post/ai-solves-unsolved-math-s4CvJIbluqFbEIl
위 포스트에서 ReasoningBank에 대해서 언급을 했었는데요.
ReasoningBank에서의 특징을 한 줄로 정리해보면 다음과 같습니다.
"성공과 실패 사례를 정리해서 기억시키자."
오늘 소개드릴 이야기는 Just-in-Time Memory라는 논문내용입니다.
https://arxiv.org/abs/2609.27334
회의가 끝나고 회의록을 세 줄로 짧게 요약해서 저장해 둔 적, 다들 있으실까요?
위 사례가 아니더라도 정리, 요약을 해놓았는데 구체적인 내용 질문을 하면 난감한 상황이 발생합니다.
이럴 때에는 원본 녹음 파일이 있으면 바로 해결이 됩니다.
위 논문 Just-in-Time Memory에서 말하는 내용이 바로 이겁니다. AI 에이전트가 이 실수를 하고 있다고 말합니다. 그리고 해결책은 생각보다 단순합니다. "요약은 필요할 때 하자."
AI 에이전트의 기억 저장 방식
요즘 LLM 에이전트는 한 번 대답하고 끝나는 게 아니라, 여러 작업을 이어서 처리합니다. 그러다 보니 "지난번에 비슷한 일을 이렇게 해결했지"를 기억해 두면 다음 작업을 더 잘할 수 있습니다. 이걸 agent memory라고 합니다.
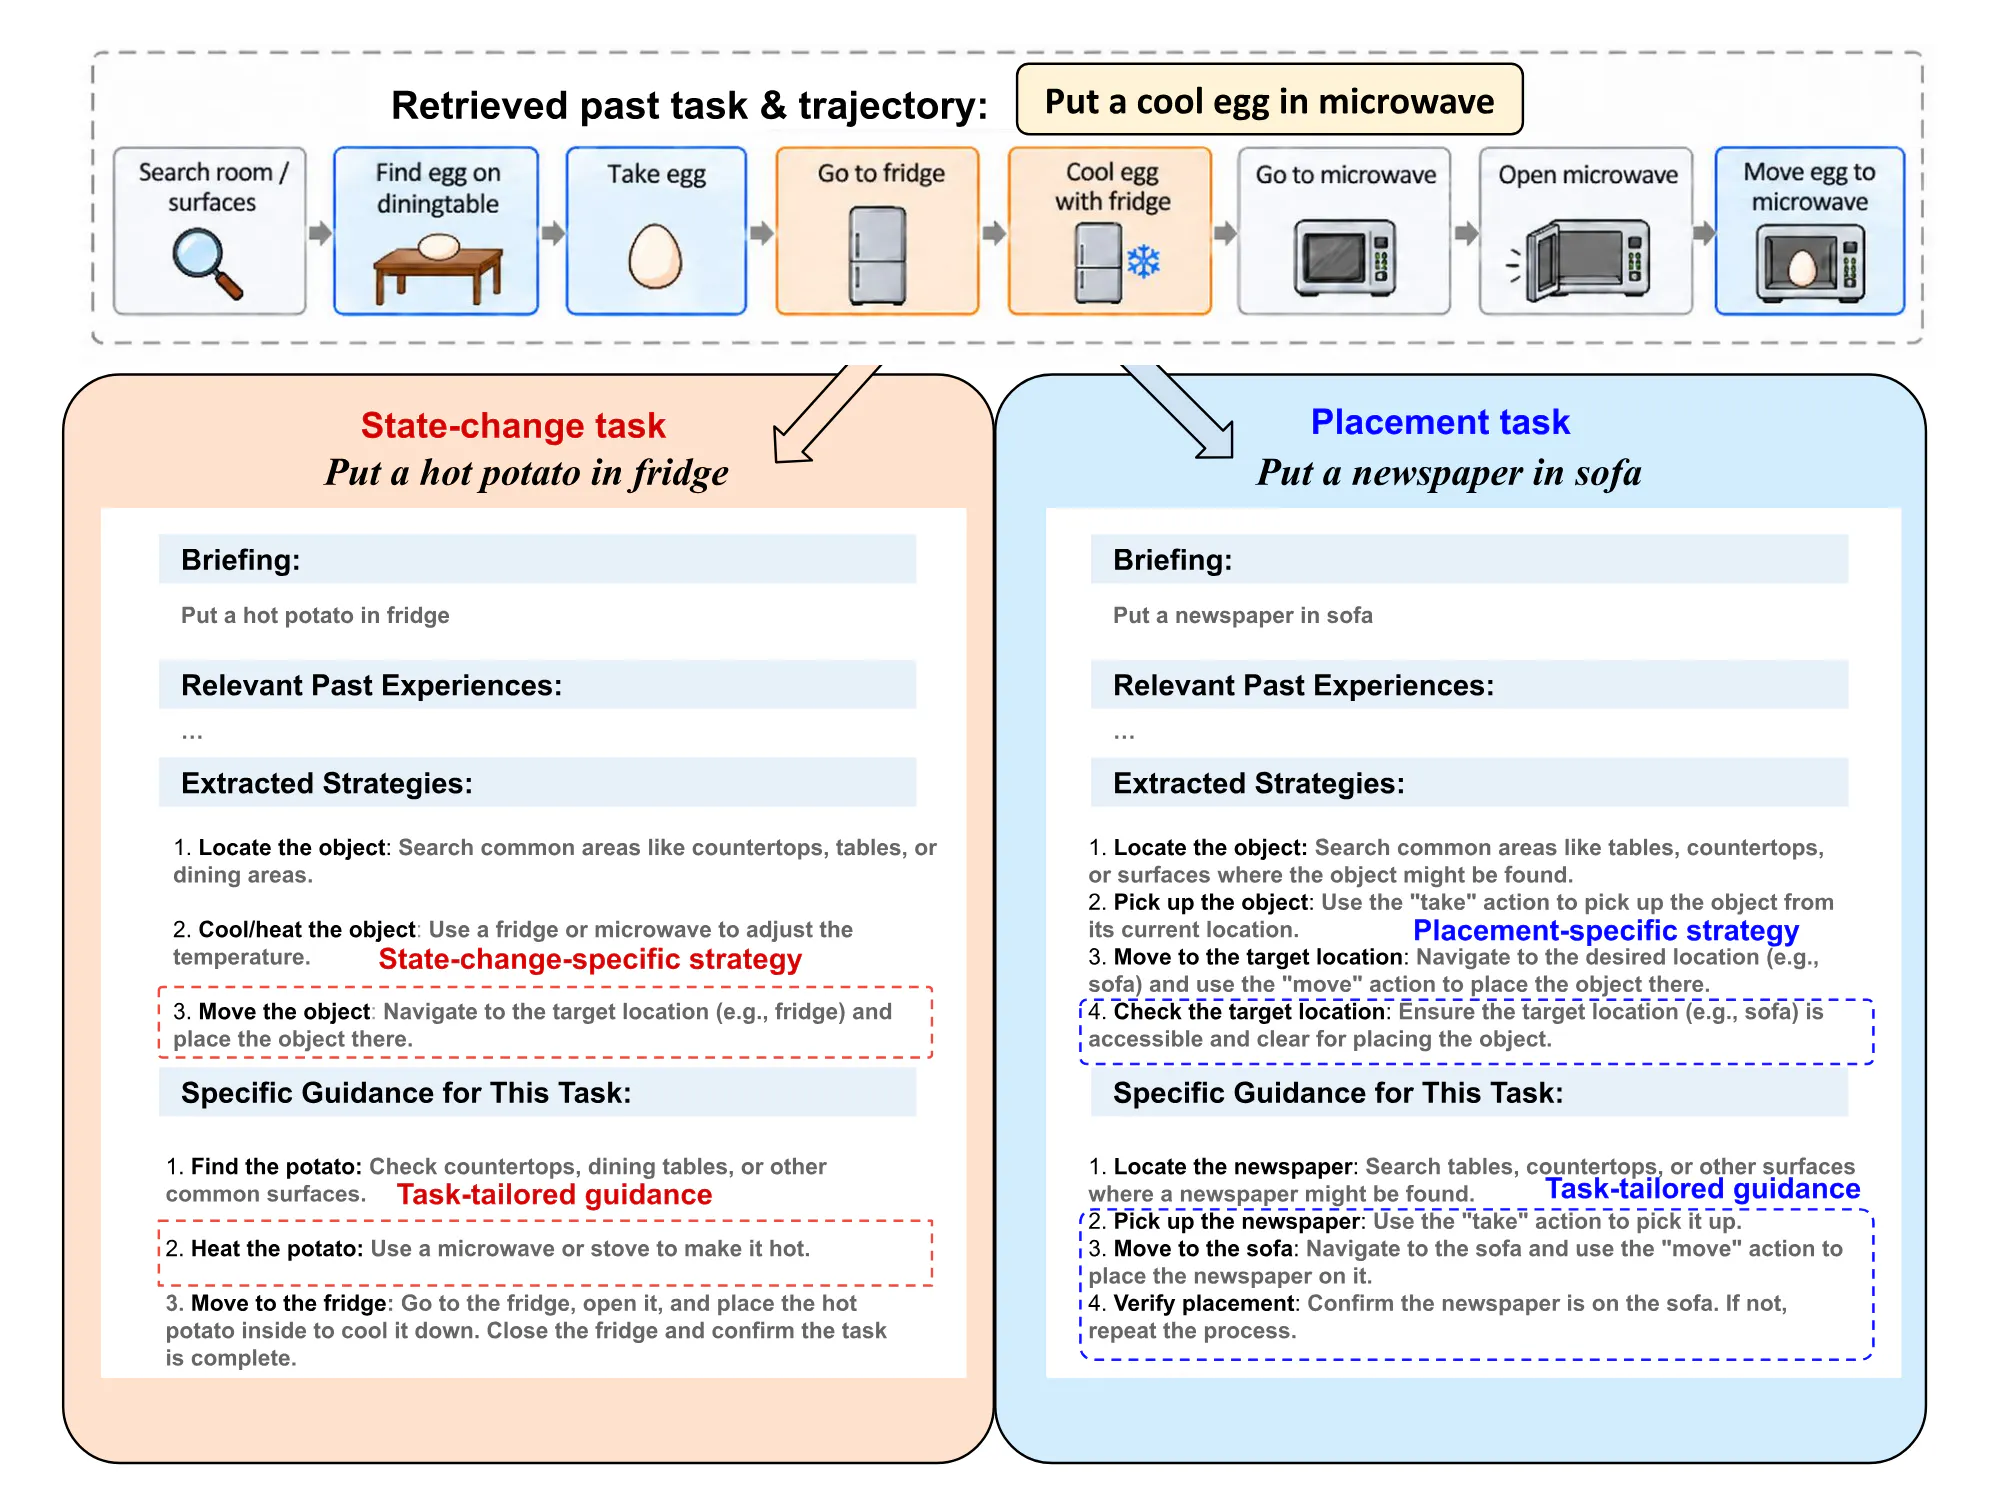
여기서 에이전트가 기억하는 건 작업 과정 전체의 기록입니다. 이걸 trajectory라고 부릅니다. 예를 들어 "달걀을 식혀서 전자레인지에 넣어라"라는 작업을 했다면 trajectory는 이렇게 생겼습니다.
방을 둘러본다 → 식탁에서 달걀을 찾는다 → 달걀을 집는다 → 냉장고로 간다 → 냉장고로 달걀을 식힌다 → 전자레인지로 간다 → 문을 연다 → 달걀을 넣는다
이 달걀 기록을 글 끝까지 계속 쓸 테니 기억해 주세요.
기존 메모리 관리법의 한계
지금까지 나온 방법들은 대부분 작업이 끝나자마자 trajectory를 요약해서 저장합니다. 이걸 write time 정리라고 합니다. 달걀 기록이라면 이런 식입니다.
교훈: 물건 온도를 바꿔야 하면 냉장고나 전자레인지를 써라.
깔끔해 보이지만 논문은 두 가지 문제를 짚습니다.
버린 정보는 되찾을 수 없습니다. 나중에 "신문을 소파에 놓아라"라는 작업이 오면, 달걀 기록에서 필요한 건 "물건을 찾아서, 집어서, 목적지에 놓는 순서"입니다. 그런데 요약본에는 온도 얘기만 남아 있습니다. 회의록 세 줄 요약과 똑같은 상황입니다.
요약 하나로 모든 미래 작업을 감당해야 합니다. 기록 하나에는 교훈이 여러 개 들어 있습니다. 그런데 어떤 교훈이 중요한지는 다음 작업이 뭔지에 달려 있고, 요약하는 순간에는 그걸 알 수가 없습니다.
문제가 하나 더 있습니다. 요약을 잘하도록 가르치기가 어렵습니다. "이렇게 요약한 게 잘한 건가?"는 한참 뒤 그 기억을 꺼내 쓸 때에야 알 수 있기 때문입니다. 강아지를 훈련할 때 잘한 행동에 일주일 뒤 간식을 주면 뭘 칭찬받은 건지 모르는 것과 비슷합니다.
Just-in-Time Memory의 혁신
논문이 제안하는 JitMem(Just-in-Time Memory)은 순서를 바꿉니다.
저장할 때: 요약하지 않고 trajectory 원본을 그대로 저장합니다. 회의 녹음 파일을 통째로 보관하는 겁니다.
꺼낼 때: 새 작업이 오면, 그 작업을 보면서 필요한 부분만 뽑아 정리합니다.
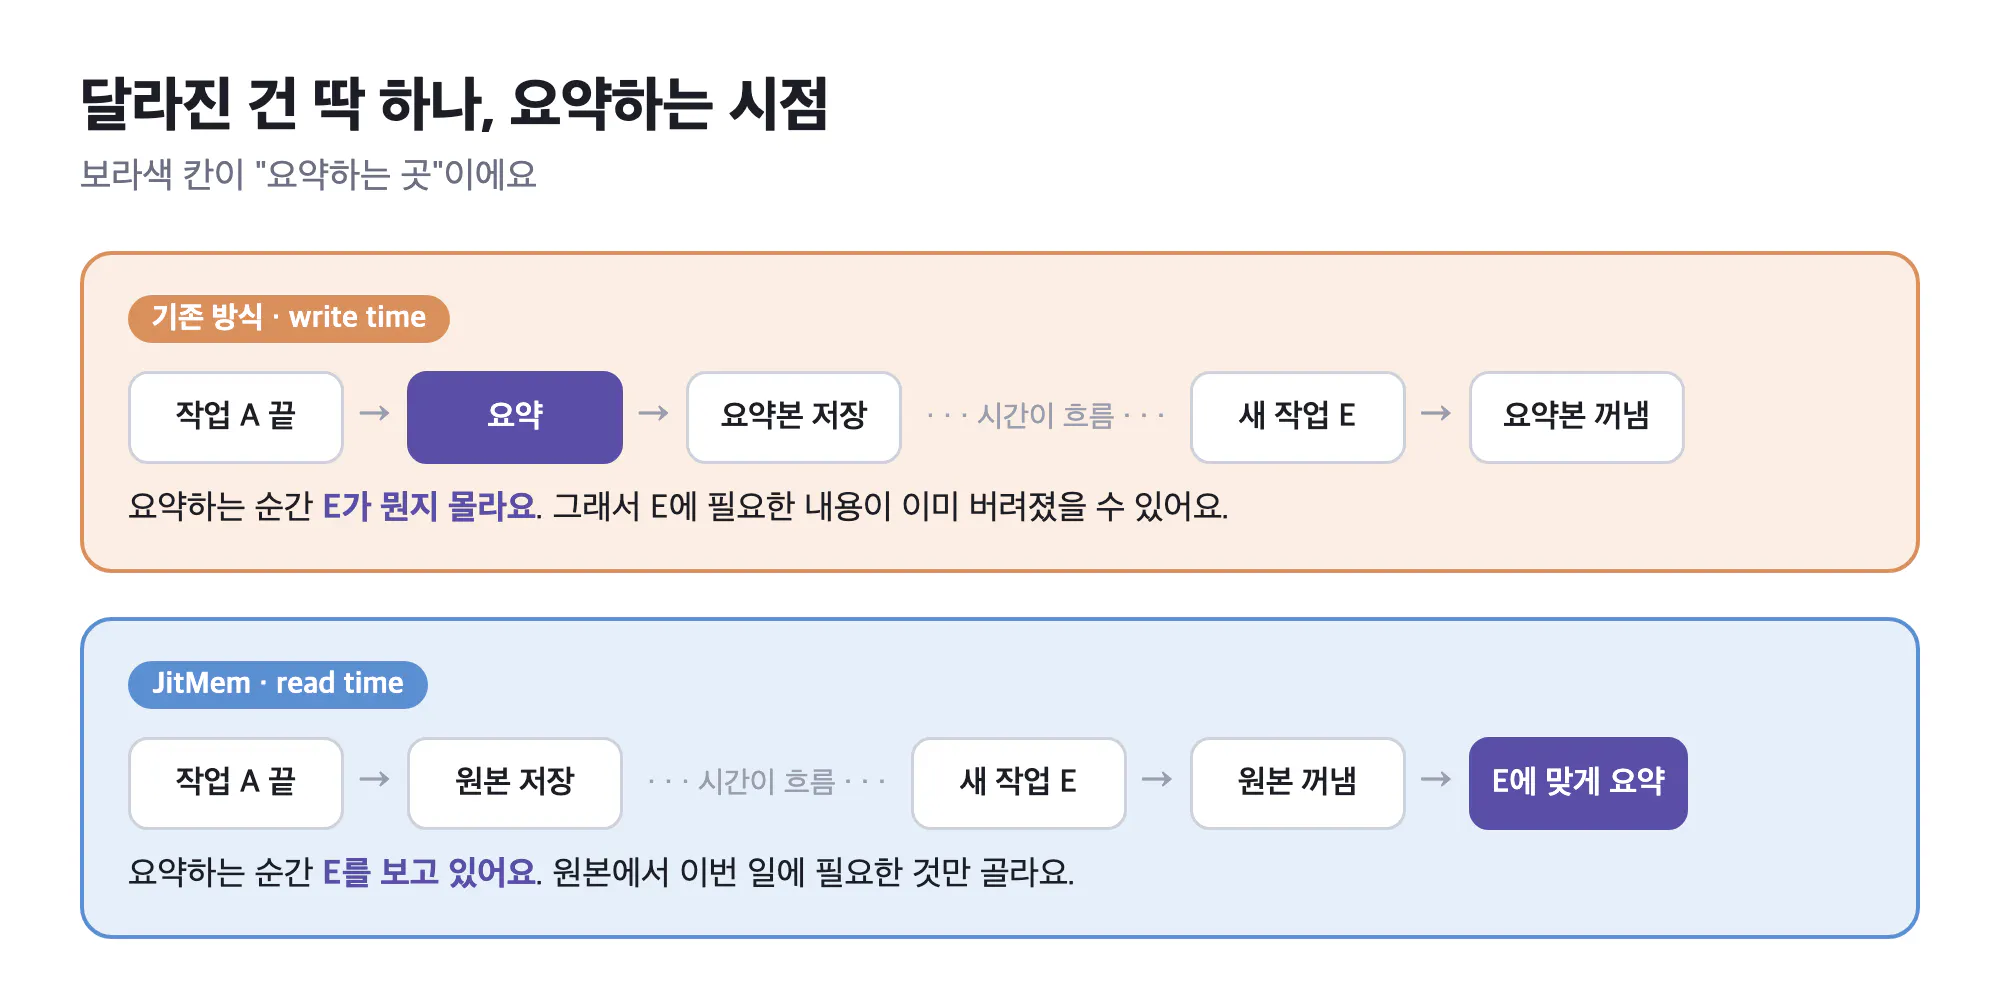
비유를 통해 설명하면 다음과 같습니다.
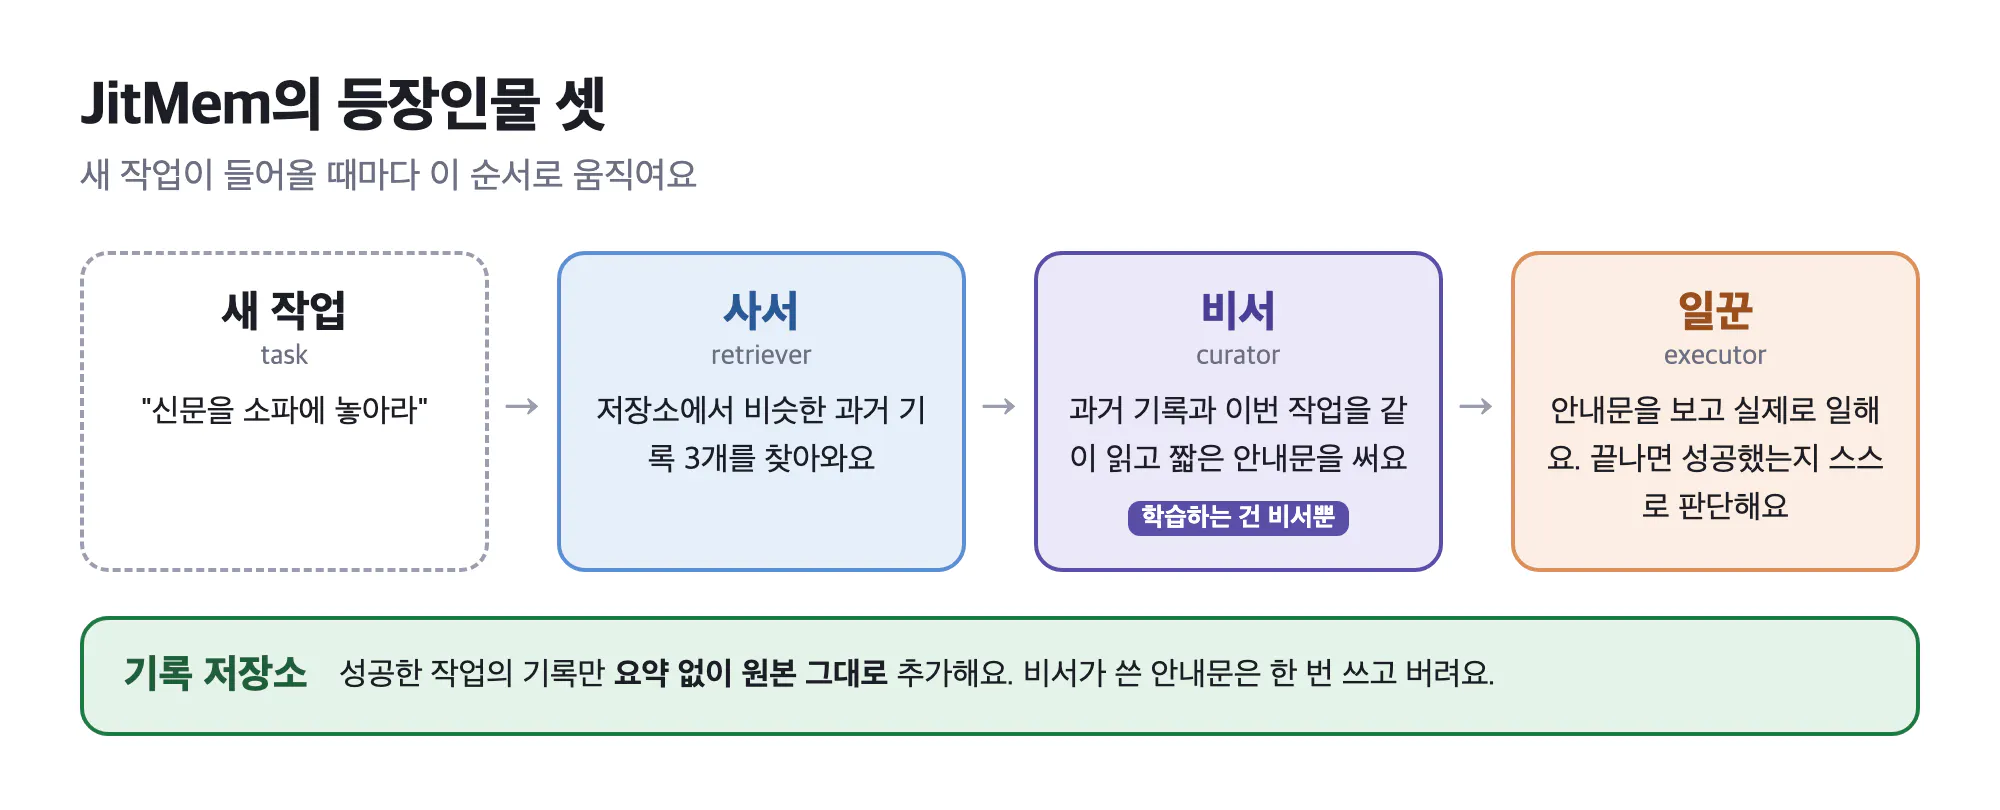
사서(Retriever) -새 작업과 비슷한 과거 기록 3개를 찾아옵니다.
비서(Curator) - 찾아올 기록과 이번 작업을 같이 읽고, "이번에는 이렇게 하세요"라는 짧은 안내문(payload)을 씁니다.
일꾼(Executor) - 안내문을 받아 실제로 일을 합니다. 일이 끝나면 스스로 성공했는지 판단해서, 성공한 기록만 다시 저장합니다.
논문에 실린 전체 구조 그림은 아래 사진과 같습니다.
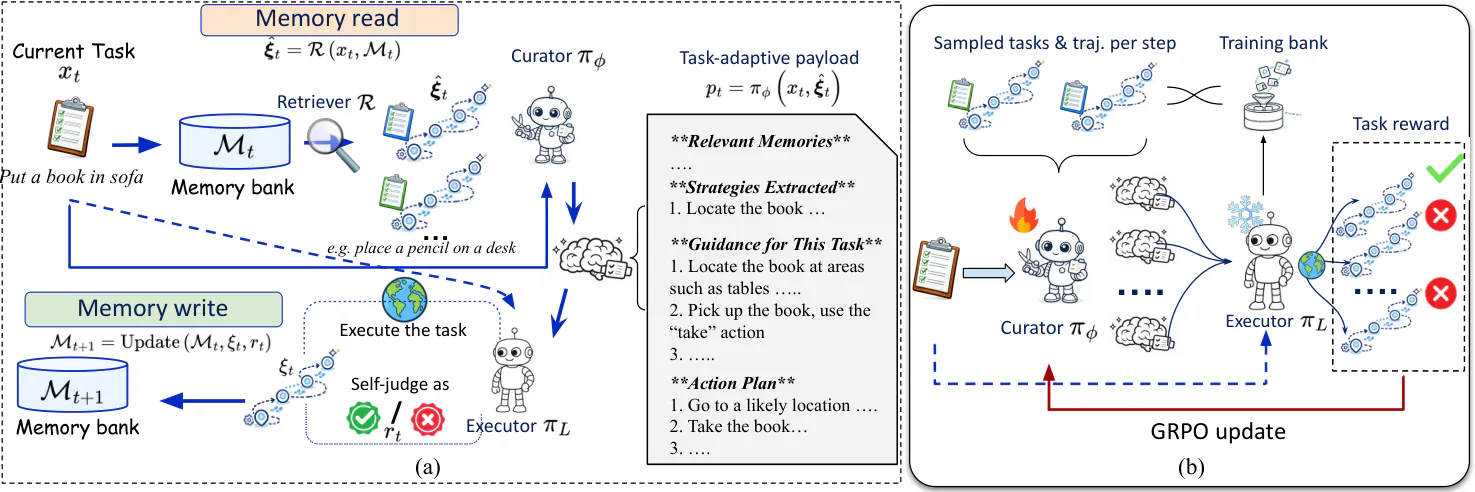
메모리 카드의 프로세스를 보여주는 다이어그램
왼쪽이 설명한 흐름이고, 오른쪽이 비서를 학습하는 과정입니다.
그렇다면 궁금증이 하나 생길 것입니다.
요약하는 시점만 바꿨을 뿐인데 뭐가 그렇게 달라졌을까?
흥미로운 내용을 하나 말씀드리면, 논문에 실제로 같은 달걀 기록이 두 작업에서 다르게 정리되는 예시가 나옵니다.
"뜨거운 감자를 냉장고에 넣어라": 비서는 달걀 기록에서 온도 바꾸는 부분을 뽑습니다. 그리고 "식혀라"를 "감자를 먼저 데워라"로 바꿔서 안내합니다.
"신문을 소파에 놓아라": 같은 기록에서 이번에는 "물건을 찾고, 집고, 놓고, 제대로 놓였는지 확인하라"를 뽑습니다.
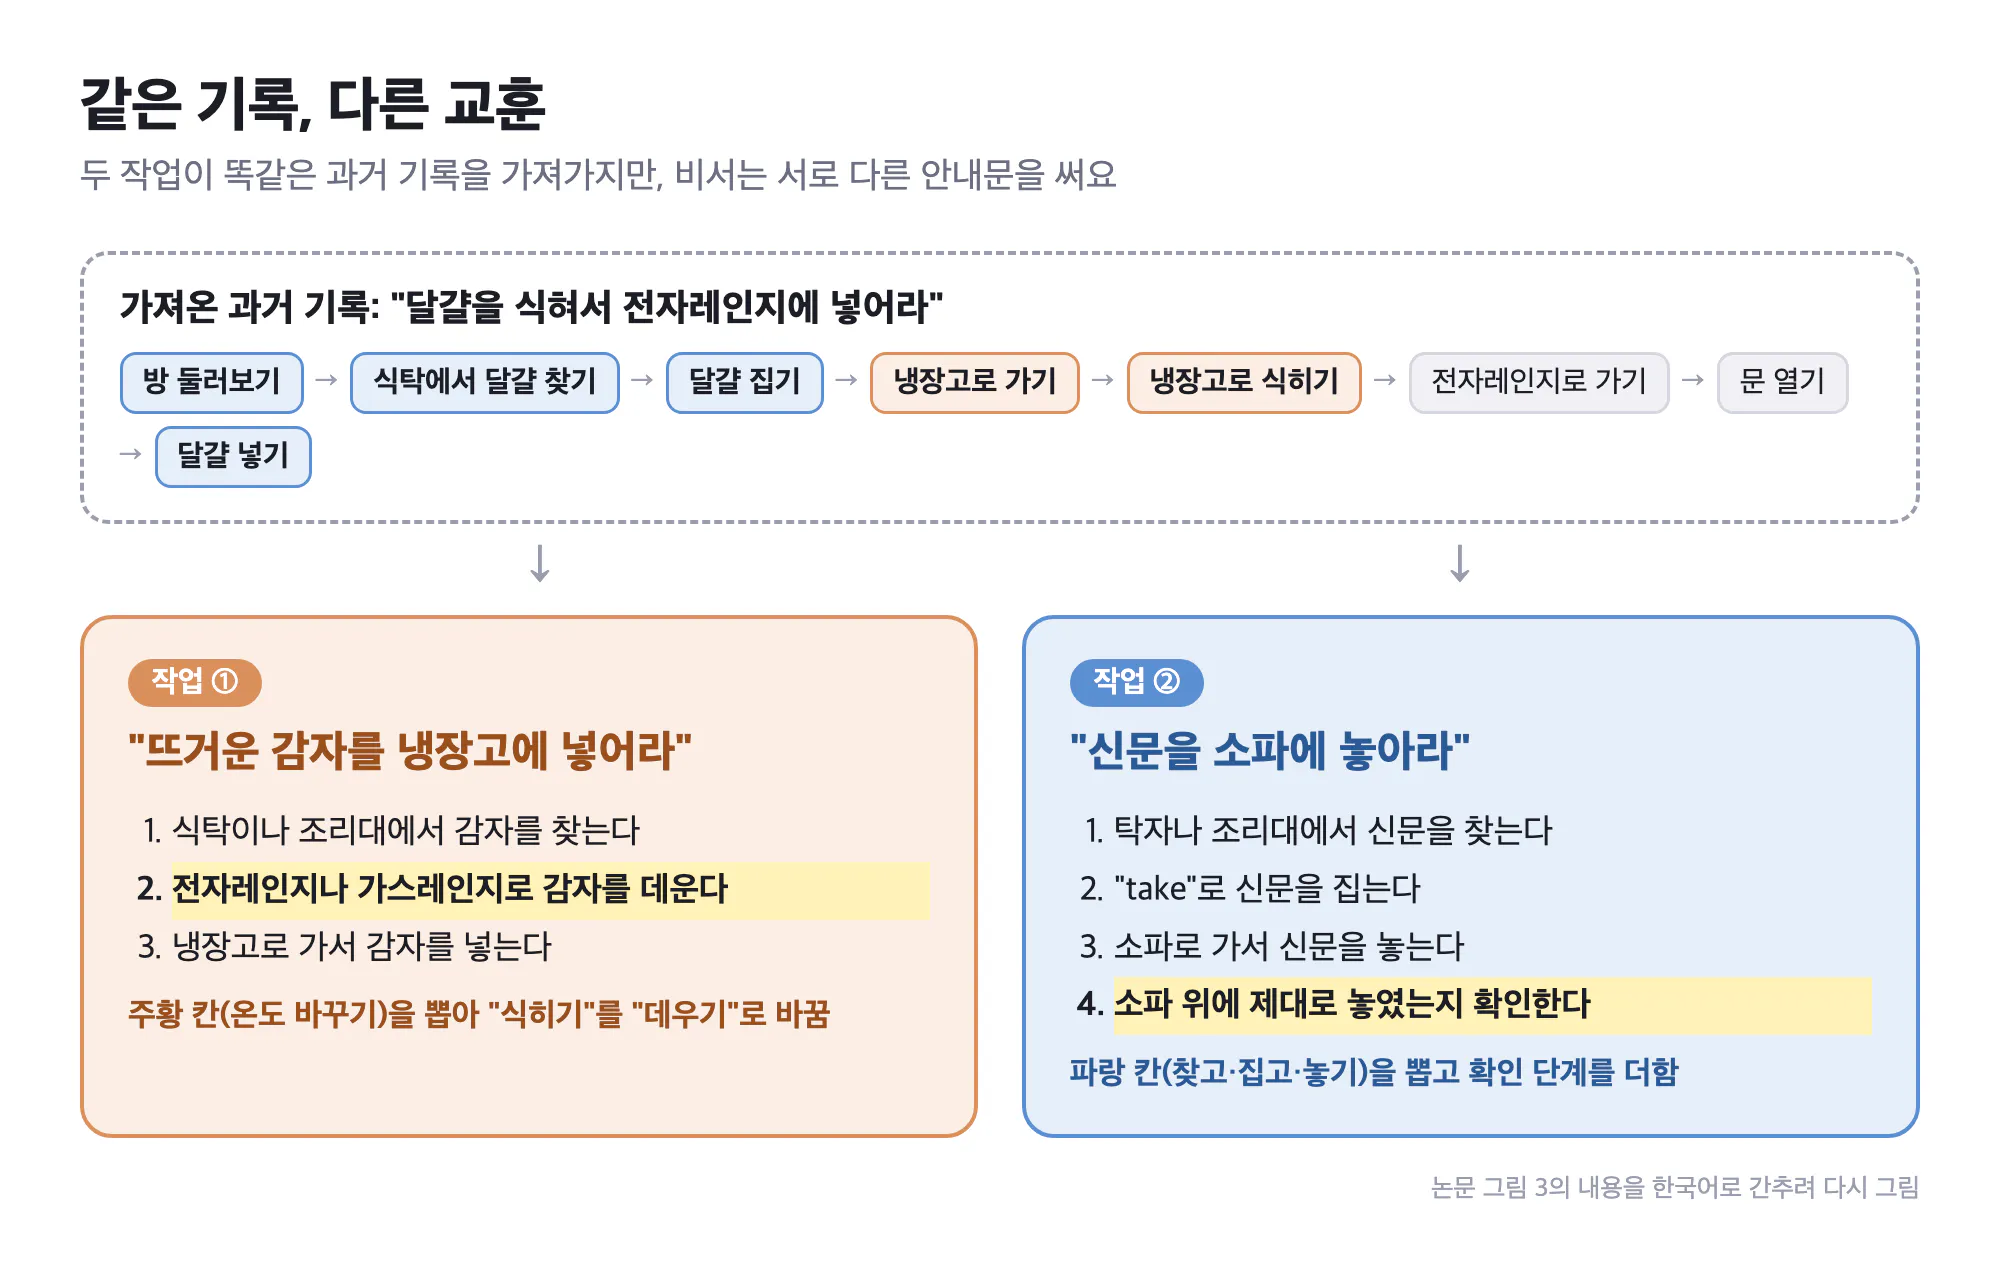
한국 비즈니스의 다양한 단계를 보여주는 다이어그램
논문 원본 그림은 다음과 같습니다.
신용카드 사용법을 보여주는 다이어그램
미리 요약을 해두었다면 둘 중 하나만 할 수 있었을 것입니다. 원본을 들고 있으니 작업마다 다른 교훈을 가져올 수 있는 것입니다.
그래서 효과가 있었냐고 하면 여러 벤치마크에서 좋은 성능을 기록했습니다.
구체적인 수치는 논문에서 찾아보시면 도움이 될 것 같습니다.
위 논문을 읽으면서 두 가지가 마음에 걸렸습니다.
첫째, 과거 기록(trajectory)을 찾는 과정이 단순합니다. BM25라는 키워드 기반 매칭기법을 사용합니다. 따라서 예시와 같은 단순한 작업이 아닌 사람들이 AI를 활용하는 복잡한 task에 적용했을 때도 결과가 같은지 궁금했습니다.
둘째, 과거 기록을 그대로 들고 다니는 것에 대한 저장공간이 걱정되었습니다. 이런 부분에서 결국에는 요약해서 정리하는 것이 필요하지 않을까라는 생각입니다.
논문의 Conclusion을 정리해보면
기존 에이전트 메모리는 작업이 끝나자마자 경험을 요약해 저장했습니다. 그래서 다음 작업이 뭔지 모른 채 정보를 버렸고, 요약을 잘하도록 가르치기도 어려웠습니다.
JitMem은 원본을 그대로 저장해 두고, 새 작업이 올 때 그 작업에 맞게 정리합니다. 같은 기록에서 작업마다 다른 교훈을 꺼낼 수 있고, 정리가 잘됐는지 바로 알 수 있어 가르치기도 쉽습니다. 실제로 학습 없이도 기존 방법과 비슷하거나 더 좋았고, 학습을 더하면 차이가 더 벌어졌습니다.
좋은 기억은 무엇을 저장하느냐뿐 아니라 언제, 어떤 일을 위해 정리하느냐에 달려 있다고 하며 논문은 마무리됩니다.
저의 AX에 접목해 본다면
저는 Claude Code나 Codex를 쓰면서 CLAUDE.md나 메모리 기능에 "이건 이렇게 해줘", "이럴 때는 이렇게 처리해"와 같은 규칙을 적어두고 있습니다. 이 논문을 읽고 나니 기억을 2가지로 나눠서 다뤄봐야겠다는 생각을 했습니다.
첫째, 규칙과 자주 틀리는 부분은 지금처럼 CLAUDE.md에 적어둡니다. 어떤 작업이 와도 통할 것들이기에 미리 요약을 해두어도 문제될 것이 없습니다.
둘째, 작업 경험은 다르게 둡니다. Claude Code는 세션 기록 원본을 이미 저장하고 있기에 새 작업을 할 때 이전에 이런적이 있었다면 "지난 세션 중 비슷한 작업을 찾아서 이번 작업에 필요한 것만 정리해줘"라고 해볼까 합니다. (이전 세션에서 어떤 것들이 있었는지를 기억한다면 토큰 절약에 좋겠죠 ㅎㅎ)
AI에게 이번 task를 하는데 딱 맞는 기억을 건네주는 것을 제 업무에 적용해보겠습니다.