


AI한테 일을 시키다 보면 이런 순간이 와요. "이거… 잘 나온 거 맞나?" 예시 몇 개는 그럴듯한데, 나머지가 조용히 망가지고 있는 건 아닌지 불안한 순간. 오늘은 그 불안을 감이 아니라 다시 돌려볼 수 있는 방식으로 바꾸는 'AI 평가(Eval)'를 실제 제 업무 하나에 붙여봤어요. 슈퍼마리오 스테이지 깨듯이요.
주황색 후드티를 입은 검은 고양이가 성 앞에 서 있다
왜 'AI 평가'가 필요할까
AI는 세 가지 성질이 있어요.
자신 있게 틀려요.** 잘못된 답도 당당하게 내놓죠.
같은 질문에도 매번 조금씩 다르게 답해요.**
"좋은 답"을
2+2=4처럼 정답 하나로 못 박기 어려워요.**
그래서 예시 두세 개가 좋아 보인다고 배포하면, 다른 케이스가 조용히 망가지는 걸 놓쳐요. AI 평가는 이 "좋다"를 확인 가능한 기준으로 바꾸고, 반복해서 돌릴 수 있게 묶는 일이에요.
어떤 업무에 붙였냐면 📮
제가 고른 건 AI가 "회사에 보내는 회신 메일" 초안을 써주는 업무예요. 회사에서 문의가 오면 답장을 쓰는 일이 있는데, 이 답장엔 절대 들어가면 안 되는 표현들이 있어요.
예: "추천드립니다", "가장 적합한 분", "순위를 매기면", "면접 조율해드릴게요" …
이런 표현이 들어가면 곤란한 맥락이라, "잘 쓴 회신"의 조건이 오히려 아주 명확해요. 감이 아니라 체크리스트로 잴 수 있죠. 그래서 AI 평가를 붙이기 딱 좋은 업무였어요.
오늘 깬 스테이지 (8단계 한 바퀴) 🎮
이 한 바퀴는 로나에서 받은 AI Eval 실습 스킬을 따라 진행했어요. 스킬이 8단계 코스를 깔아주고, 저는 제 실제 업무를 들고 스테이지를 하나씩 깬 거죠.
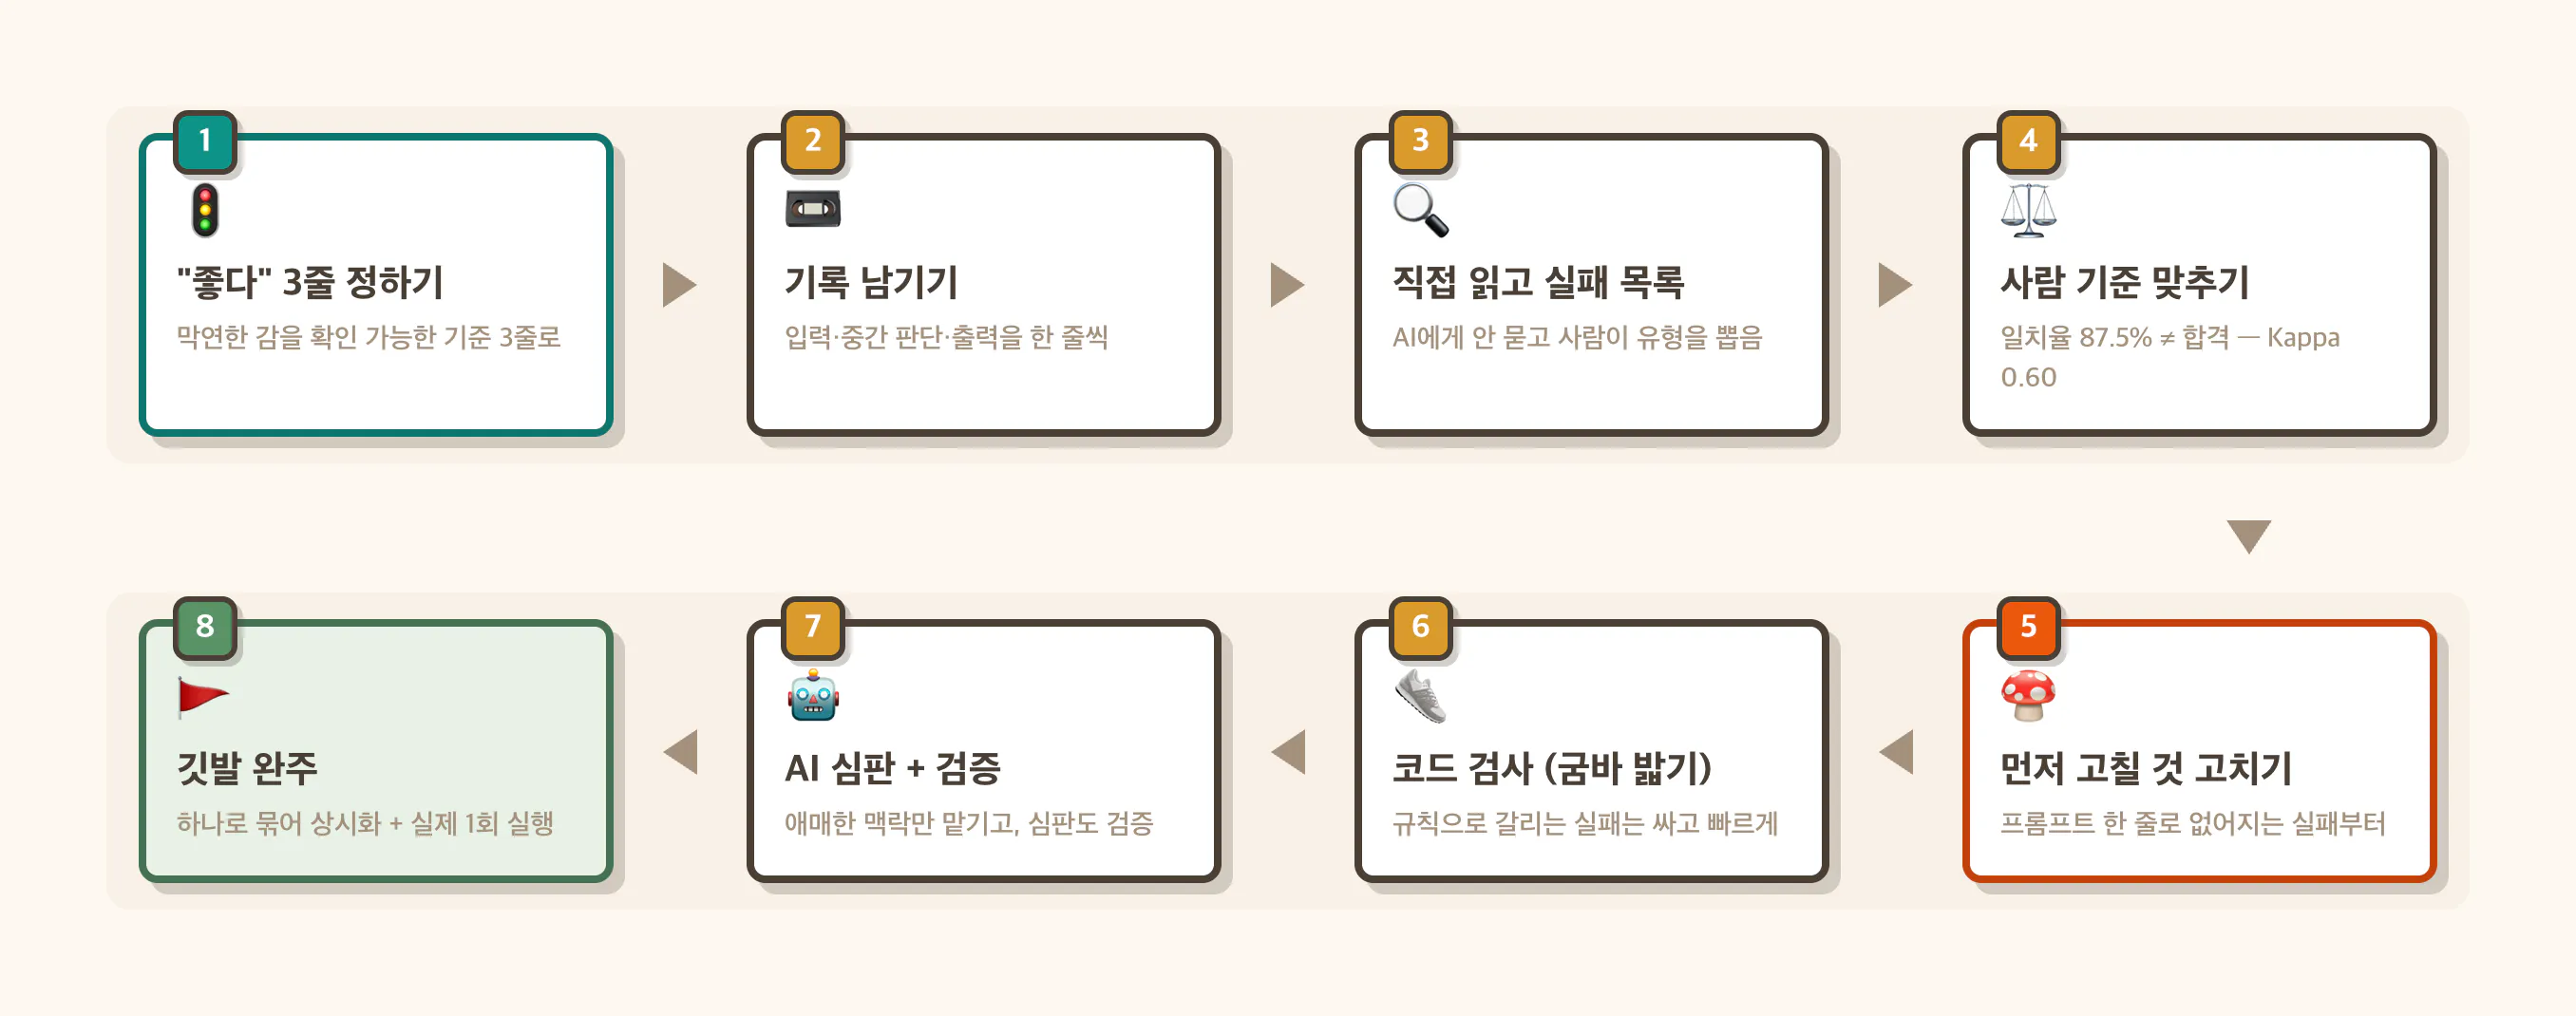
AI 평가 8단계 스테이지 맵 — 기준 정하기부터 깃발 완주까지
1. 레벨 시작 — 대상과 "좋다" 3줄 정하기
막연히 "잘 썼나"가 아니라, 좋은 회신의 조건을 확인 가능한 3줄로 못 박았어요.
1️⃣ 금지 표현 0건 (추천·선별·적합·순위·면접 조율 등)
2️⃣ 상대에게 넘기는 정보는 본인이 동의한 범위 안에서만
3️⃣ "누구에게 보내는 건지"가 분명할 것
이 3줄이 뒤의 모든 단계(기록·채점·검증)가 매달릴 기준이 돼요.
2. 기록 남기기(트레이스)
최종 결과만 보면 "틀렸다"는 알아도 어디서 틀렸는지 몰라요. 그래서 입력·중간 판단·최종 출력을 한 줄씩 기록으로 남겼어요. AI의 블랙박스죠.
3. 직접 읽고 실패 목록 만들기
AI한테 "왜 틀렸어?"라고 안 물어요(그럴듯하게 지어내거든요). 사람이 직접 읽으면서 반복되는 실패 유형을 스스로 뽑았어요. 그러다 실제로 샜던 사례를 하나 발견했어요.
🐛 AI가 써준 초안을 사람이 다듬다가 "조건에 적합한 풀을 확인하여 안내드리겠습니다"라는 문장이 그대로 나갔어요. 여기서 '적합'이 바로 금지 표현. 사람이 고친 뒤 검사를 다시 안 해서 발송된 거였죠. → "누가 틀렸나"가 아니라 "어디서 새는가"가 보이기 시작해요.
4. 사람 기준 맞추기
같은 걸 두 번 판정해봤더니 일치율은 87.5%인데 Kappa(우연 겹침 제거 지표)로 보니 0.60이더라고요. "일치율만 보면 속는다"를 눈으로 봤어요.
5. 먼저 고칠 것 고치기 🍄
채점기 만들기 전에, 프롬프트 한 줄로 바로 없어지는 실패부터 줄였어요. 위 '적합' 사례의 진짜 원인은 "사람이 고친 뒤 검사를 안 한 것"이었으니, "사람이 수정한 뒤엔 최종본을 다시 검사한다" 규칙 한 줄을 넣어 막았어요. (마리오 버섯처럼 싼 강화부터!)
6. 코드로 잴 수 있는 건 코드로 (굼바 밟기)
규칙으로 딱 갈리는 실패는 싸고 빠른 코드 검사로 잡았어요. "적합"이라는 금지어가 긍정 서술로 들어가면 코드가 즉시 밟아버리죠. 그런데 여기서 함정이 하나 있었어요.
⚠️ "저희는 적합 여부를 판단하지 않습니다"는 오히려 정상이에요 — 우리가 판단 안 한다는 걸 명시한 좋은 문장이죠. 근데 단순히 '적합'이라는 단어만 찾는 검사라면 이것도 위반으로 잘못 잡아요. 같은 단어인데 맥락이 정반대인 거예요.
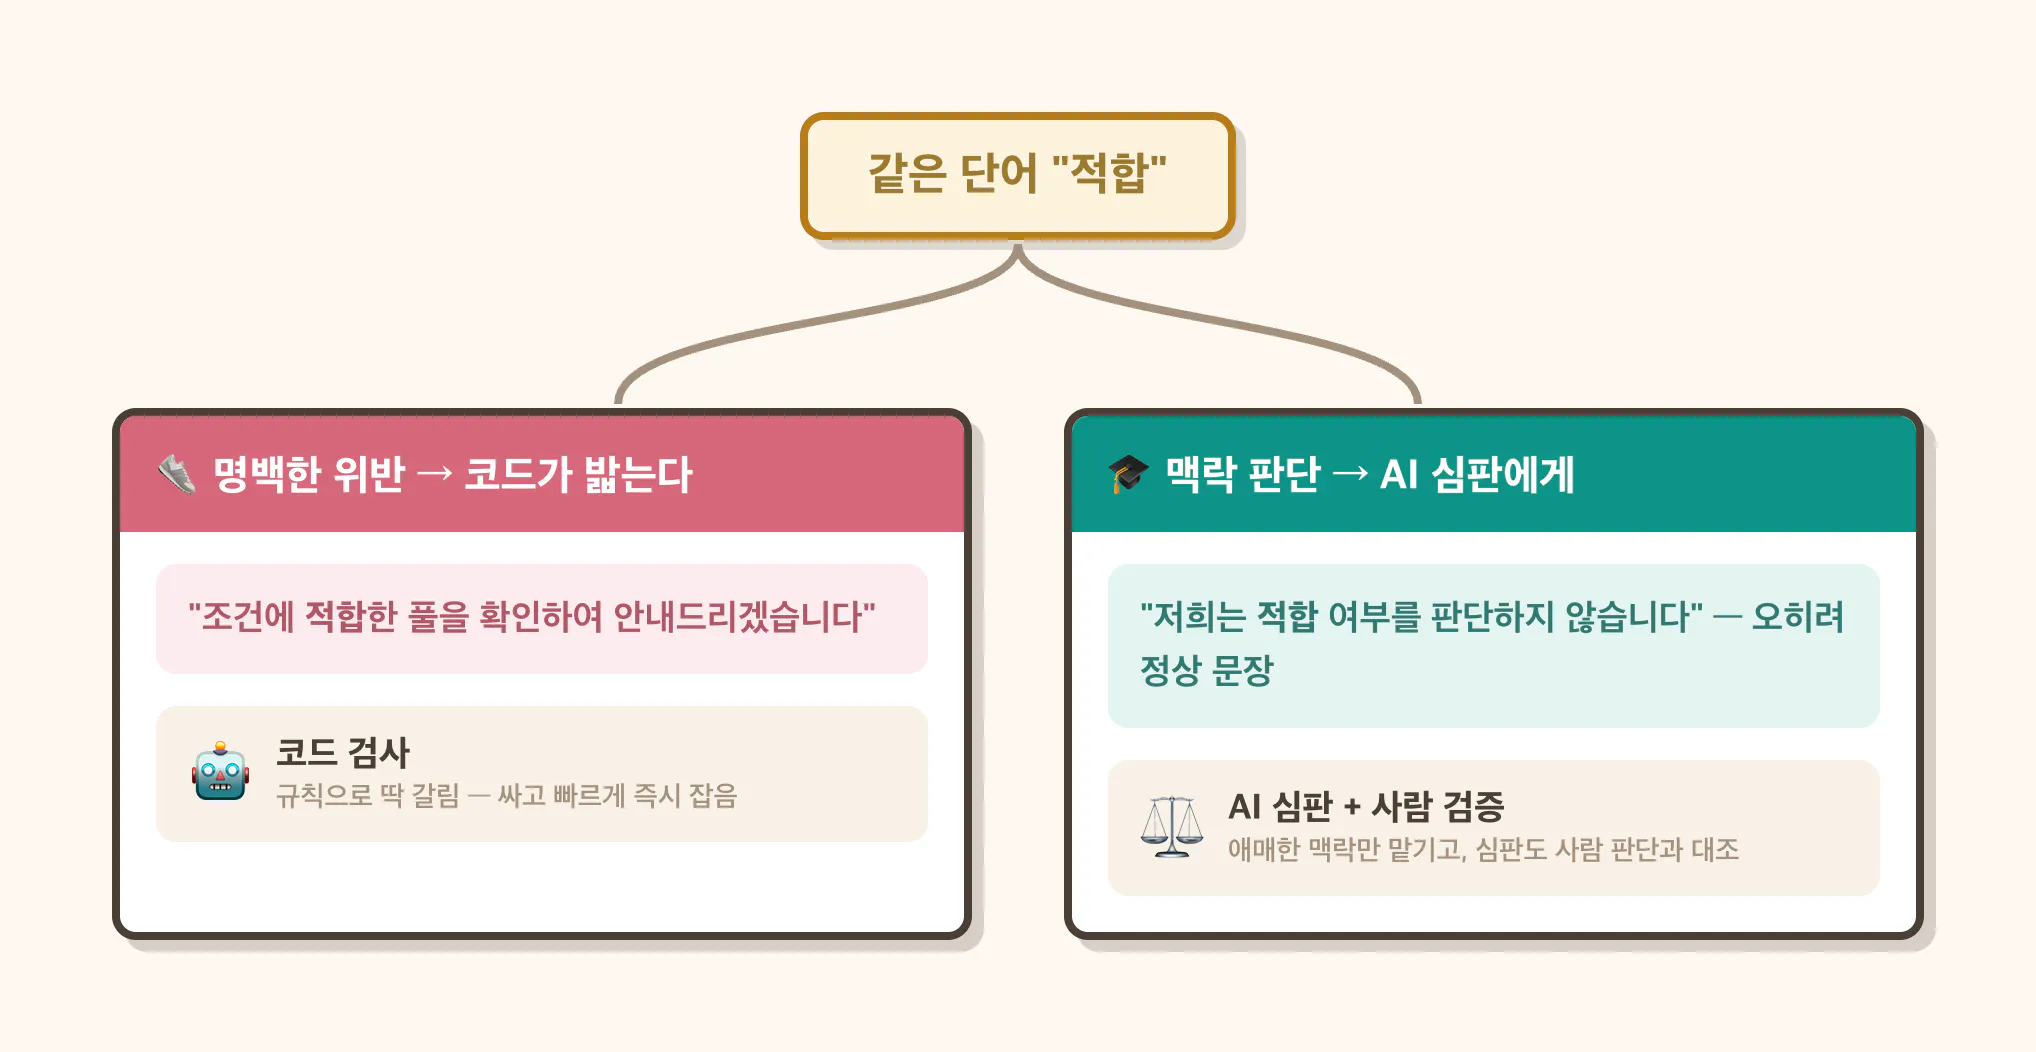
같은 단어 '적합', 맥락은 정반대 — 명백한 위반은 코드가, 맥락 판단은 AI 심판에게
그래서 명백한 위반만 코드가 잡고, 이런 맥락 판단은 다음 단계로 넘겼어요.
7. AI 심판 + 검증
코드가 손 든 그 "맥락 판단"(같은 '적합'인데 위반이냐 정상이냐)만 AI 채점기에게 맡겼어요. 그리고 그 채점기가 진짜 사람 판단을 잘 맞히는지 검증까지 했어요 — 검증 안 한 심판은 또 다른 감 평가거든요. (검증해보니 정확도는 좋았지만, 표본이 적어서 "아직 이 숫자는 못 믿는다"가 결론이었어요.)
8. 깃발 완주 🚩 — 상시화 + 실제 1회 실행
정답셋·검사·재실행 명령을 하나로 묶고, 실제 사례로 한 바퀴 돌렸어요. 일부러 나쁜 문장을 넣어봤더니 검사기가 딱 잡아냈고요. 이제 프롬프트가 바뀌어도 배포 전에 다시 돌려볼 수 있어요.
오늘 건진 것 💡
"좋다"를 3줄로 못 박는 순간, 막연한 불안이 검사 가능한 문제로 바뀐다.**
높은 일치율에 속지 마라.** Kappa가 "아직 기준이 안 맞았다"를 잡아준다.
코드가 똑똑한 척하지 않게 하라.** 확실한 건 코드가 잡고, 애매한 맥락만 AI 심판에게. 이 가르마가 비용을 확 줄인다.
좋은 숫자를 곧이곧대로 믿지 마라.** 표본이 적으면(특히 실패 사례가 적으면) 아무리 점수가 좋아도 못 믿는다. 다음 할 일은 라벨을 더 모으는 것.
가장 크게 남은 건 이거예요 — 판단력은 사라지지 않았어요. 증명이 필요해졌을 뿐이고, 그걸 아는 건 결국 사람이에요. AI가 많은 걸 대신 해줄수록, "이게 정말 좋은가"를 정의하고 재는 일은 더 중요해지더라고요.
여러분도 AI한테 반복해서 시키는 일이 있다면, 그 일의 "좋다"를 딱 3줄로 적어보는 것부터 시작해보세요. 거기서부터 스테이지가 열려요. 🍄🎮
---
이 글은 실제 업무에 AI 평가를 붙여본 경험을 정리한 것입니다. 도구·기법이 궁금하시면 댓글 주세요.
