


안녕하세요, 지피터스 김현철입니다.
지난번에 매일 아침 커맨드 한 번으로 B2B 리드를 찾아주는 Loop를 만들었다는 글을 올렸는데요, 그 Loop를 며칠 돌리다 보니 찜찜한 게 하나 생겼습니다. AI가 매일 후보 회사마다 0~100점을 매기는데, 그 점수가 맞는지는 아무도 확인 안 하고 있었어요. 실제로 같은 기사를 두 번 채점시켰더니 한 번은 73점, 한 번은 63점이 나왔습니다. 10점이 그냥 흔들린 거죠.
그래서 이번엔 로나(rona.so)에서 "내 기능에 평가 붙이기 — AI Eval 한 바퀴" 실습을 받아서, 이 채점기에 재실행 가능한 평가 세트를 붙였습니다. 반나절 정도 걸렸고, 끝나고 나니 커맨드 한 번으로 채점기의 품질을 다시 검사할 수 있게 됐습니다.
뭘 만들었나
AI 평가(Eval)는 거창한 게 아니라 이 순환을 만드는 일이었습니다:
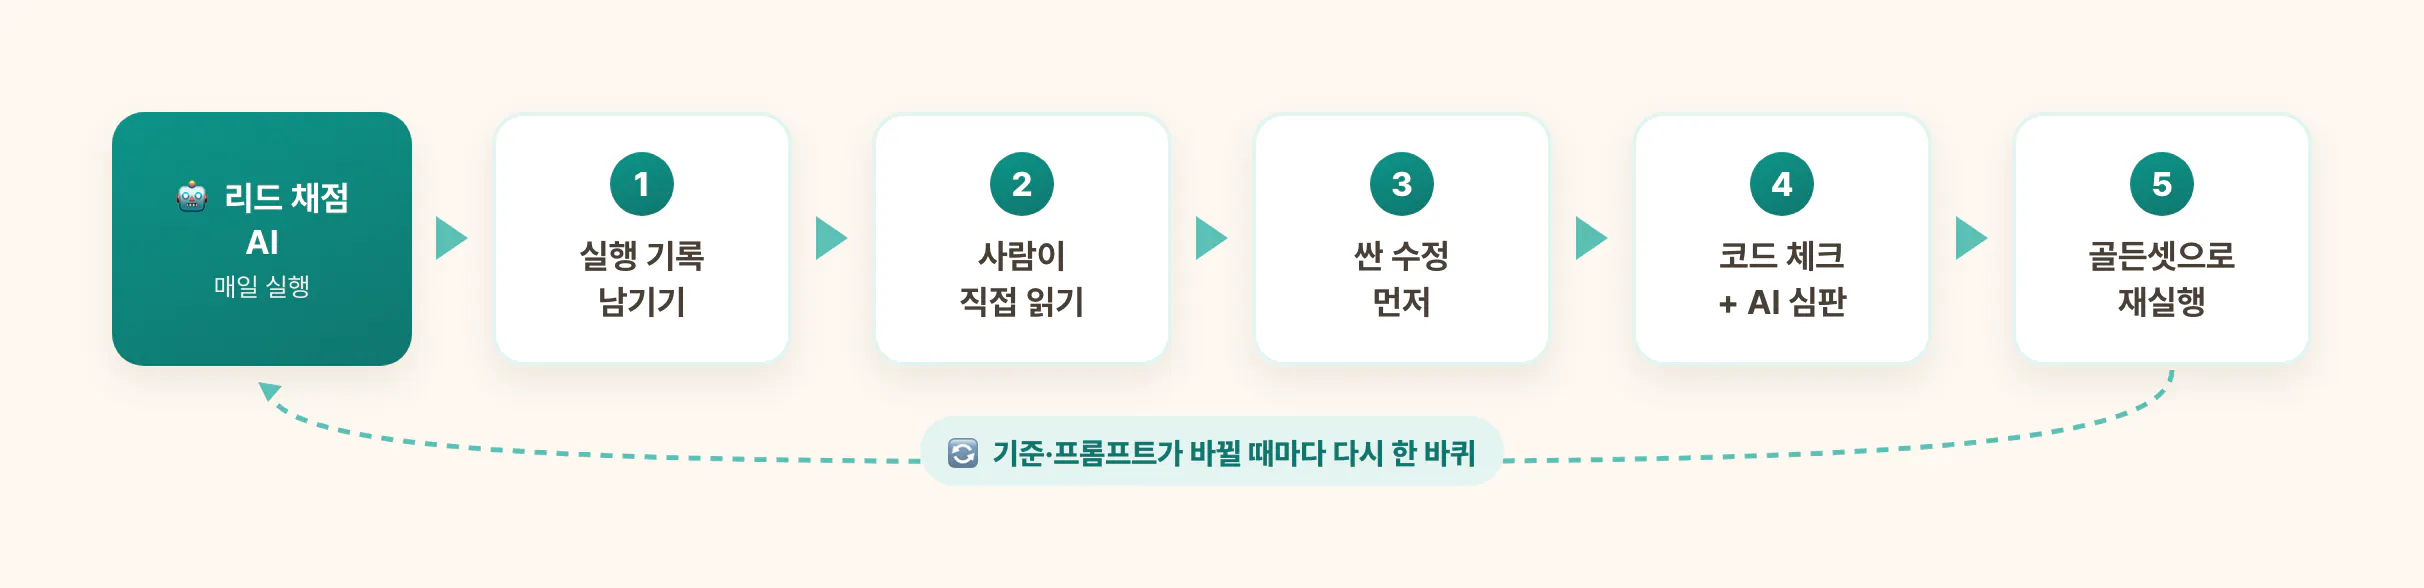
AI 평가 한 바퀴: 기록 남기기, 직접 읽기, 싼 수정, 코드 체크와 AI 심판, 골든셋 재실행 사이클
실행 기록 남기기 — 오늘 수집된 실제 기사 15건을 채점시키고, 최종 점수만이 아니라 차원별 점수와 근거 문장까지 한 줄씩 기록으로 남깁니다. 나중에 "왜 63점이지?"를 되짚을 수 있는 블랙박스예요.
사람이 직접 읽기 — 통계보다 먼저 제가 15건을 전부 읽었습니다. 미리 실패 유형을 정해놓고 끼워 맞추는 게 아니라, "이상하다" 싶은 걸 그대로 메모하고 나중에 묶었어요.
싼 수정 먼저 — 발견된 문제 중 두 개는 채점기가 아니라 규칙 한 줄로 고쳐지는 거였습니다. 바로 설정 파일에 박았어요.
코드 체크 + AI 심판 — 남은 것 중 "총점이 공식과 맞나" 같은 건 if문으로, "근거 문장이 점수를 정당화하나" 같은 판단만 AI 채점기(심판)로 나눴습니다.
골든셋으로 재실행 — 제가 정답을 확정한 문제집 7개를 만들어, 기준이나 프롬프트가 바뀔 때마다 전체를 다시 돌립니다.
배운 것 3가지
1. 실패는 제가 생각한 곳에 없었습니다
읽기 전엔 "점수가 후하거나 짜겠지"라고 예상했는데, 15건을 직접 읽어보니 채점 자체는 견고했어요(버려야 할 기사 10건은 10건 다 정확히 버림). 진짜 문제는 점수를 매긴 다음이었습니다. 기준상 등록해야 할 B급 리드가 "하루 1건" 규칙과 충돌하면 아무 기록 없이 조용히 사라지고 있었어요. 트레이스를 직접 읽지 않았으면 영영 몰랐을 겁니다.
2. AI 심판의 숫자는 검증 전까지 믿으면 안 됩니다
"근거가 점수를 정당화하나"를 판정하는 AI 심판을 만들어 돌렸더니 5건 중 4건이 불합격, 실패율 80%가 나왔습니다. 여기서 그냥 믿었으면 멀쩡한 채점기를 뜯어고쳤을 거예요.
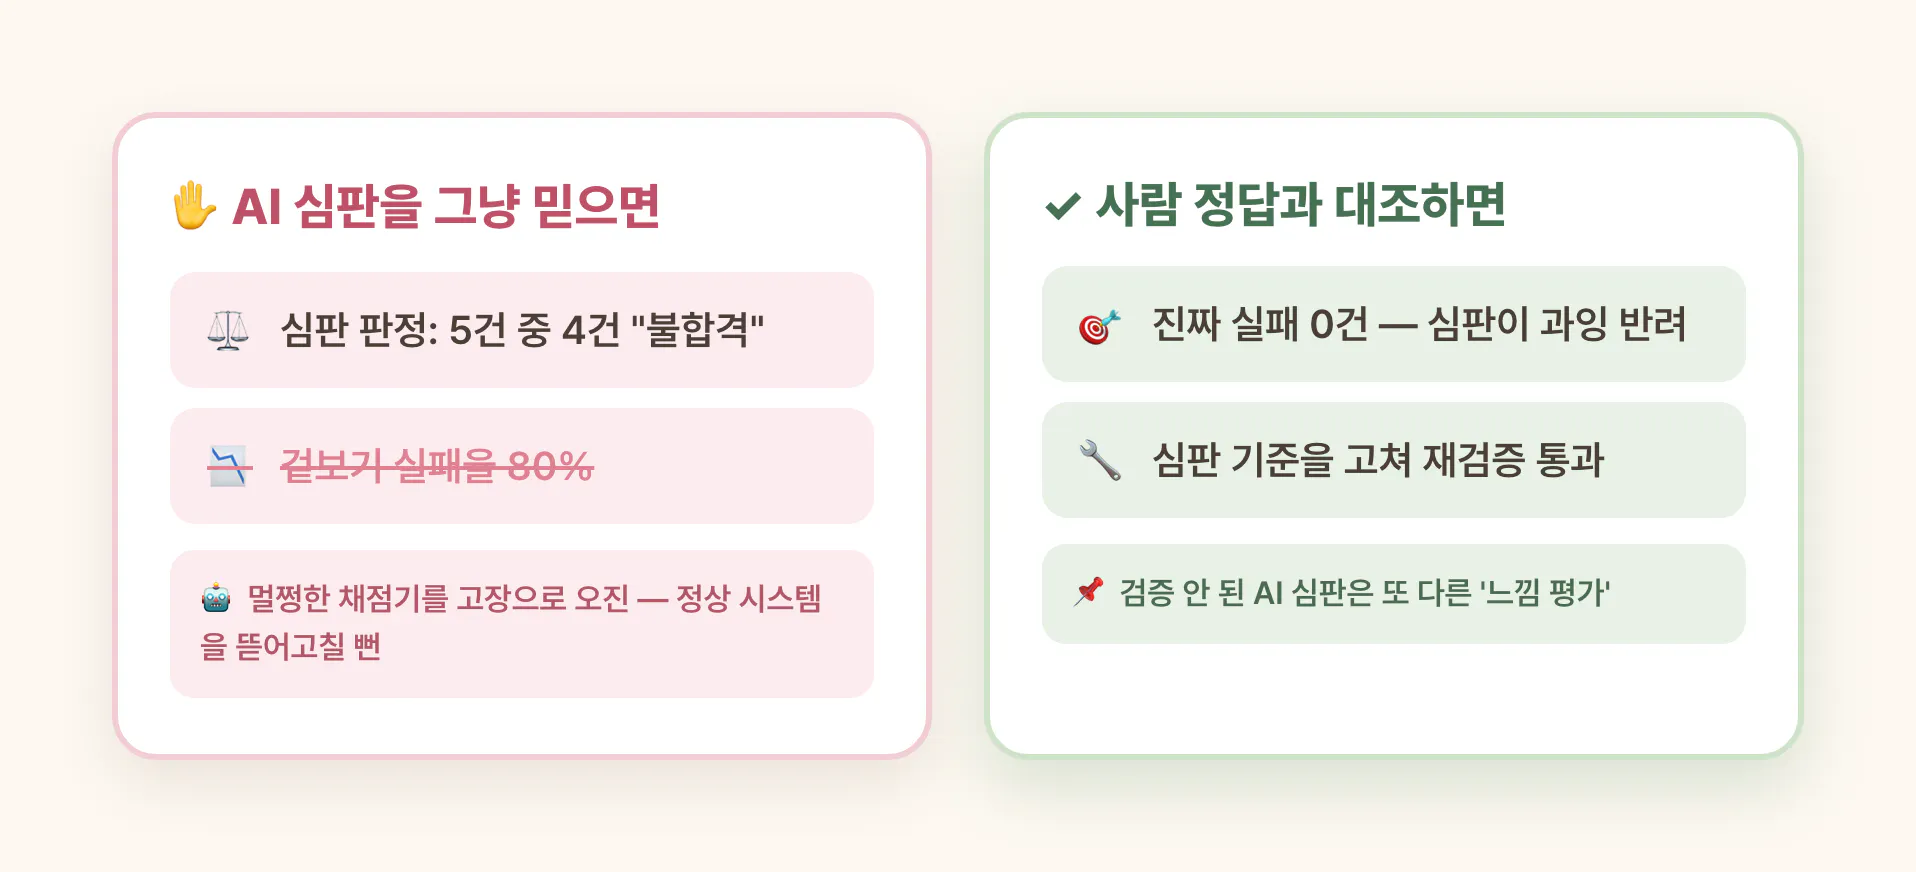
AI 심판 검증 전후 비교: 그냥 믿으면 멀쩡한 채점기를 오진, 사람 정답과 대조하면 과잉 반려 발견
제가 정답 라벨을 붙여 대조해보니 진짜 실패는 0건 — 심판의 기준이 저와 어긋나 과잉 반려하고 있던 것이었습니다. 심판 기준을 제 기준으로 고쳐 재검증을 통과시켰어요. "검증 안 된 AI 심판은 또 다른 느낌 평가다"라는 말을 숫자로 체감한 순간이었습니다.
3. AI에게 "그거 어떻게 알았어?"라고 물어보세요
심판이 불합격시킨 이유가 "출처 없는 근거"였는데, 정작 그 근거들("이 회사엔 인재개발원이 있다" 같은 것)이 어디서 왔는지 궁금해서 물었습니다. 답은 검색이 아니라 AI의 사전학습 지식이었어요. 출처를 같이 기억하지 못하고, 낡았을 수 있고, 드물게 지어낼 수도 있는 지식이죠. 그래서 "실재가 확인되는 상설 조직만 인정하되 반드시 표기하고, 컨택 전에 사람이 재검증한다"는 규칙을 기준 문서에 못 박았습니다. AI의 판단 재료가 어디서 오는지 캐물으면, 그 답이 그대로 운영 규칙이 됩니다.
마지막 관문: 일부러 부숴보기
전부 초록불이 뜬 다음, 마지막으로 가짜 데이터를 일부러 주입했습니다. 차원 합은 55점인데 총점을 70점으로 부풀린 채점을 몰래 끼워 넣었어요. 검사가 즉시 잡아냈습니다. 앞으로 프롬프트나 모델이 바뀌어 채점이 슬쩍 부풀려지는 일이 생기면, 사람이 눈치채기 전에 이 검사가 막아줍니다. 초록불만 보고 안심하지 말고, 한 번은 일부러 부숴서 방어막이 진짜 작동하는지 확인해보세요.
마무리
지난 글에서 "AI에게 일을 시킨다는 건 내 판단 기준을 인수인계 문서로 만드는 일"이라고 썼는데, 이번 작업은 그 다음 문장이었습니다. "그 기준이 지켜지는지는 별도의 검사 장치가 재본다." 감으로 "잘 되는 것 같은데"가 아니라, 커맨드 한 번으로 골든셋 7문제가 다시 풀리고 회귀가 걸러지는 상태가 되니, 이제 기준을 고치는 게 무섭지 않습니다.
궁금한 점 있으면 댓글로 물어봐주세요!
사용 도구: Claude Code + 로나(rona.so) 실습 "내 기능에 평가 붙이기" + gpters-evals 플러그인 · 제작 시간: 약 반나절 · 결과: 평가 폴더 12파일 + 재실행 커맨드 /lead-prescreen-eval + 운영 규칙 3건 개선
