GEO 체크리스트로 내 블로그 검색 노출 점검하기
2026.10.08
소개
제 블로그의 검색 노출 상태를 강의의 점검 순서로 사이트맵 주소 180개 전체에 대 보았고, 구글에 뜬 블로그 글이 23편 중 0편이라는 것을 확인했습니다. 블로그나 개인 사이트를 운영하면서 검색엔진과 AI 검색에 실제로 노출되는지 직접 재 보고 싶은 분께 도움이 될 것 같습니다.
제 블로그(kakyungkim.github.io)는 Jekyll로 만든 한/영 이중언어 사이트입니다. 연구 노트를 한국어와 영어로 한 쌍씩 쓰고, 그 옆에 매일 자동 발행되는 경제 브리핑(econ-radar)과 주간 논문 다이제스트(paper-radar)가 함께 올라갑니다.
23기에 같은 체크 스터디장의 GEO 스터디를 청강했습니다. 그때 4주 동안 사례글마다 "서치콘솔 등록"과 "hreflang 추가"를 1순위로 적었고, 4주차 글의 제목이 "hreflang은 4주 내내 0개였습니다"였습니다. 7주가 지난 지금 그 상태가 어떤지, 이번 강의가 준 점검 순서로 다시 재 보기로 했습니다.
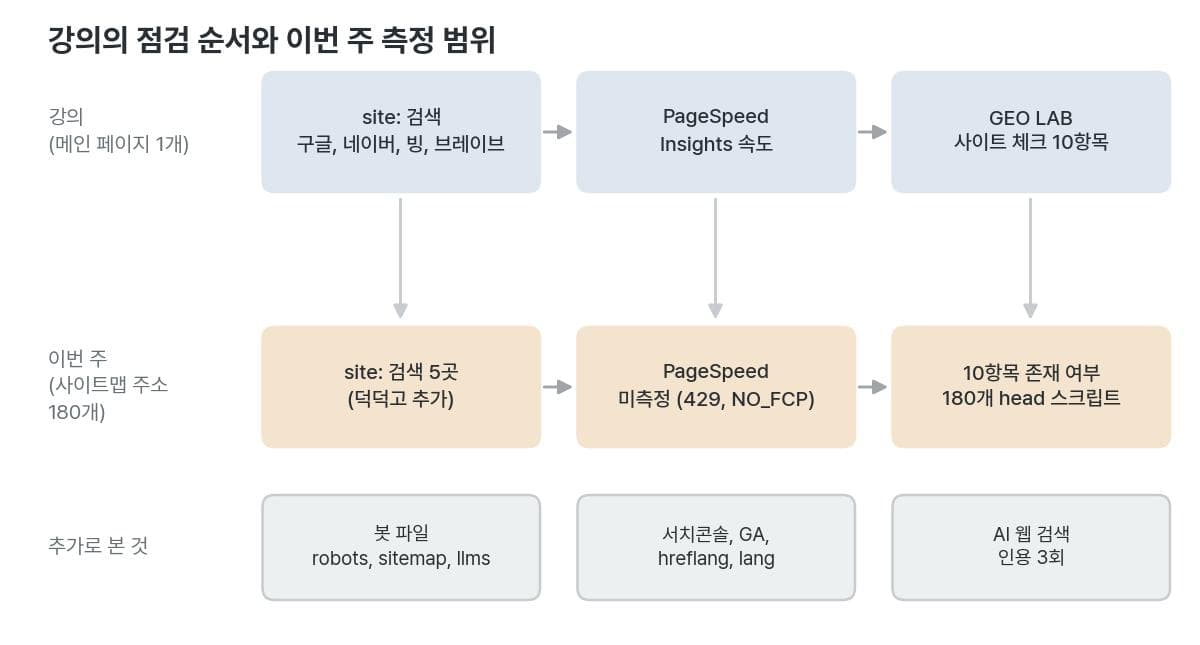
이번 1주차 강의의 목표는 "현재 상태를 먼저 확인하는 것"이었습니다. 스터디장은 세 단계를 함께 따라 하게 했습니다. 구글, 네이버, 빙, 브레이브에서 site: 검색하기, PageSpeed Insights로 속도 보기, 스터디장이 만든 GEO LAB 사이트 체크로 기본 체크리스트 10항목 보기입니다. 수업 중에는 메인 페이지 하나로 했지만, 강의가 "메인 페이지보다 검색에 뜨기를 원하는 세부 페이지가 중요하다"고 했으니 저는 사이트맵에 있는 주소 180개 전체로 넓혔습니다. 이번 기수 제목이 "AI가 추천하게 만들려면"이라, AI 검색이 제 블로그를 인용하는지도 확인할 수 있는 데까지 봤습니다.
블로그 설정은 고치지 않았습니다. 이번 주는 재기만 하고, 고칠 것은 계획으로 남겼습니다.
진행 방법
사용 도구: Claude Code, curl, Python 3, git, 크롬(검색엔진 화면 확인), Claude Code의 웹 검색 도구
Step 1. 측정 대상 정하기
로컬 저장소가 원격보다 늦을 수 있어 먼저 받아 왔습니다.
cd ~/kakyungkim.github.io && git fetch -q origin
git rev-list --left-right --count HEAD...origin/main     # 0  1
원격이 1커밋 앞서 있었고, 10/3 econ-radar 자동 발행분이었습니다. 저장소 쪽 확인은 모두 origin/main 기준으로 했습니다. 측정 대상은 공개 사이트의 사이트맵입니다.
curl -s https://kakyungkim.github.io/sitemap.xml | grep -o "<loc>[^<]*" | sed 's/<loc>//' > sm.txt
wc -l < sm.txt                                   # 180
구성 | 23기 4주차 (8월 중순) | 이번 주 (10/4) |
|---|---|---|
econ-radar 리포트 | 73 | 127 |
paper-radar 리포트 | 11 | 17 |
한국어 페이지( | 14 | 16 (글 12, 홈, 소개, 주제) |
영어 페이지( | 14 | 15 (글 11, 홈, 소개, 주제) |
발표 자료, 기타 | 5 | 5 (루트 포함) |
합계 | 117 | 180 |
127+17+16+15+5 = 180으로 맞습니다. 블로그 글은 한국어 12편, 영어 11편, 합쳐 23편입니다. 한/영 짝은 11쌍이고 9/8 ADMET 글만 한국어판뿐입니다. 7주 동안 늘어난 63개 중 54개가 econ-radar입니다.
Step 2. 검색엔진 네 곳에서 site: 검색
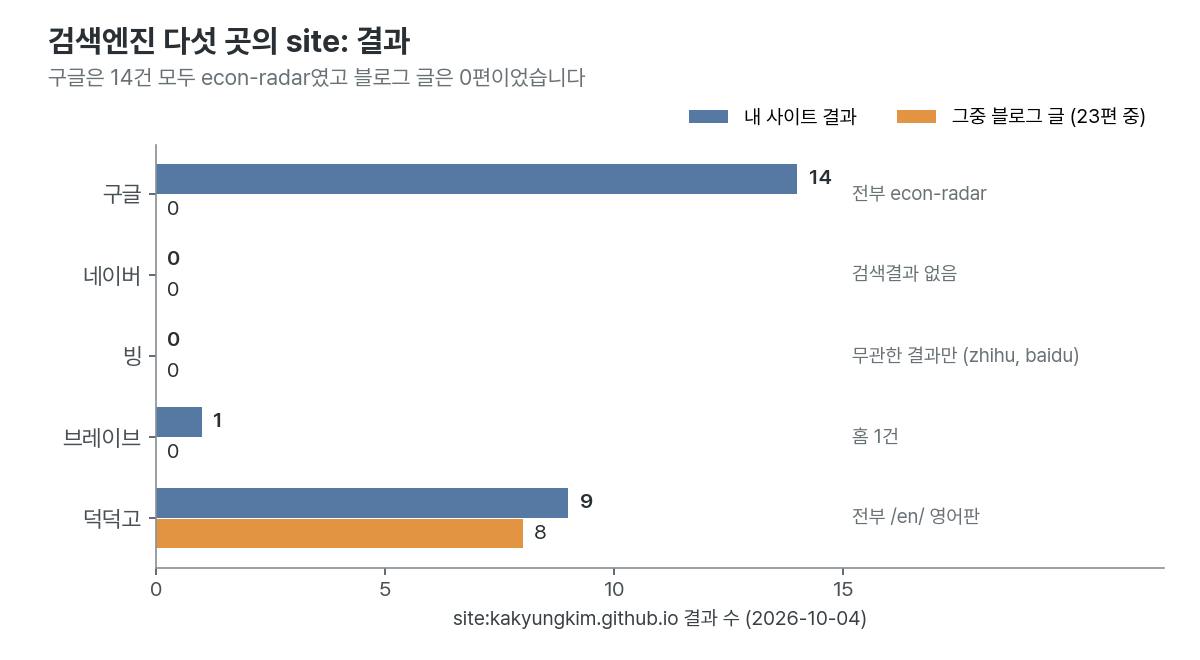
강의 순서 그대로 구글, 네이버, 빙, 브레이브를 봤습니다. curl로는 구글이 자바스크립트 이동 페이지만 돌려주고 브레이브는 429(요청 과다)를 내서, 이 둘과 빙은 크롬에서 직접 열어 결과를 읽었습니다. 네이버와 덕덕고는 curl로 받았습니다.
Q="site%3Akakyungkim.github.io"
curl -s -A "$UA" --max-time 20 "https://search.naver.com/search.naver?query=$Q"   # "검색결과가 없습니다"
curl -s -A "$UA" --max-time 20 "https://html.duckduckgo.com/html/?q=$Q" \
  | grep -o 'kakyungkim\.github\.io/[^"<& ]*' | sort -u | wc -l                     # 9
검색엔진 | 검색어 | 내 사이트 결과 | 그중 블로그 글 |
|---|---|---|---|
구글 |
| 14건 (2쪽), 전부 econ-radar | 0 |
구글 |
| 0건 | 0 |
구글 |
| 0건 | 0 |
네이버 |
| 0건 | 0 |
빙 |
| 내 사이트 없이 무관한 결과(zhihu, baidu)만 | 0 |
빙 |
| 첫 쪽에 고유 주소 6개(홈, 한국어 소개, 2025-09 글 한/영, econ-radar, CV PDF) | 1쌍 |
브레이브 |
| 1건(홈) | 0 |
덕덕고 |
| 9건, 전부 | 8 (영어판만) |
구글에 나온 14건의 사이트 이름은 모두 "GitHub Pages documentation"으로 표시됐습니다. 깃허브 공식 문서 사이트의 이름이고, 제 이름은 어디에도 없었습니다.
Step 3. GEO LAB 기본 체크리스트 10항목을 180개 주소에
사이트 체크 화면에는 "기본 검사는 항목의 존재 여부를 확인해요"라고 적혀 있습니다. GEO LAB 화면은 한 번에 주소 하나만 받아 180번 넣을 수 없으니, 같은 10항목의 존재 여부를 180개 페이지의 <head>에서 세는 스크립트로 대신했습니다.
c = {'title': has(head, r'<title>[^<]+</title>'),
     'description': has(head, r'<meta[^>]*name=["\']description["\']'),
     'canonical': has(head, r'<link[^>]*rel=["\']canonical'),
     'og:title': ..., 'og:description': ..., 'og:image': ...,
     'viewport': has(head, r'name=["\']viewport'),
     'robots_meta': has(head, r'<meta[^>]*name=["\']robots["\']'),
     'sitemap': True, 'robots.txt': True}   # 사이트 단위 항목, 둘 다 HTTP 200
묶음 | 페이지 수 | 점수 (10점 만점) | 빠진 항목 |
|---|---|---|---|
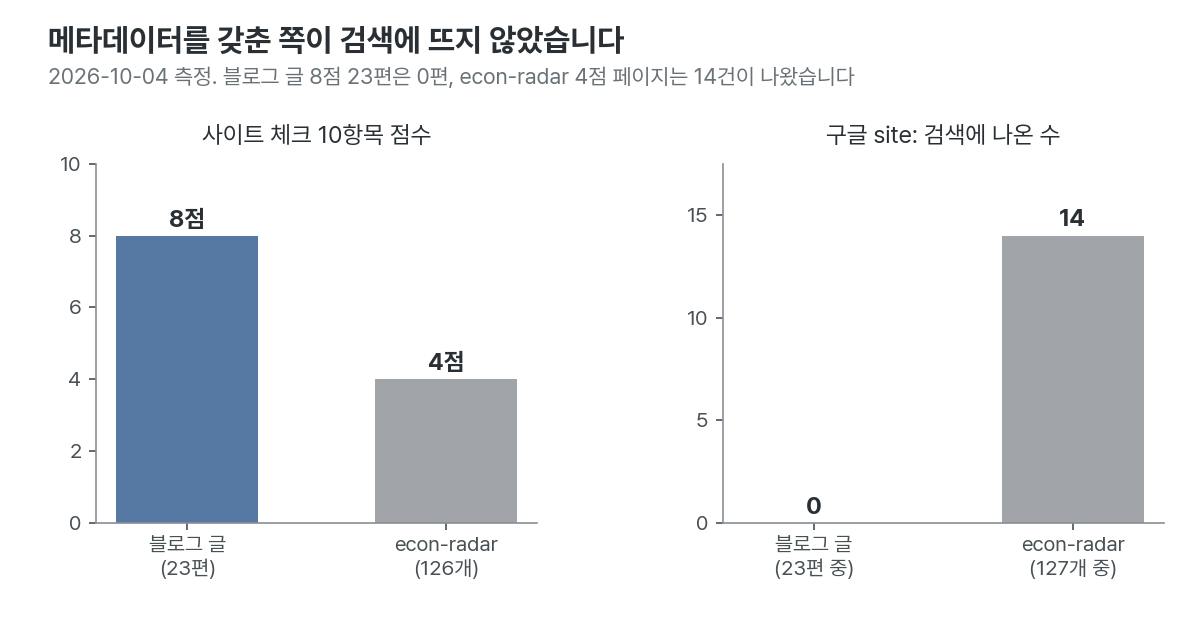
블로그 글과 홈, 소개( | 32 | 전부 8점 | og:image, 검색로봇 메타태그 |
econ-radar | 127 | 126개 4점, 목록 페이지 1개 8점 | description, canonical, og 셋, 검색로봇 메타태그 |
paper-radar | 17 | 16개 4점, 1개 5점 | 위와 같음 |
발표 자료, PDF | 4 | 2~5점 |
|
항목 | 있는 페이지 / 180 |
|---|---|
title, viewport | 177 |
description | 34 (19%) |
og:title / og:description | 34 / 33 |
canonical | 32 |
og:image | 1 |
검색로봇 메타태그 | 0 |
평균은 4.71점입니다. 검색로봇 메타태그는 없으면 기본값이 "색인해도 된다"라 빠졌다고 막히는 것은 아닙니다. 다만 GEO LAB은 존재 여부로 채점하니 점수에서는 빠집니다.
Step 4. 봇이 먼저 보는 파일
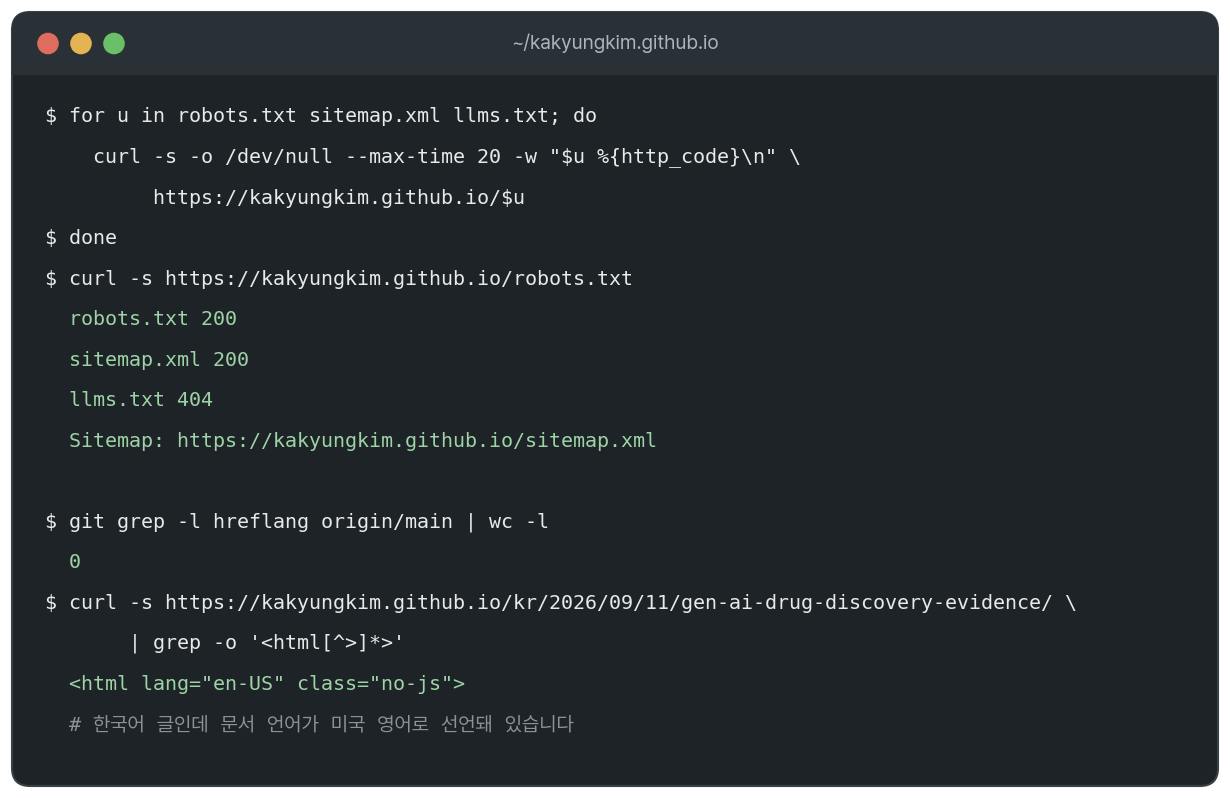
for u in robots.txt sitemap.xml llms.txt; do
  curl -s -o /dev/null --max-time 20 -w "$u %{http_code}\n" https://kakyungkim.github.io/$u
done
curl -s https://kakyungkim.github.io/robots.txt
robots.txt 200
sitemap.xml 200
llms.txt 404
Sitemap: https://kakyungkim.github.io/sitemap.xml
robots.txt는 23기와 같이 Sitemap: 한 줄뿐입니다. 막는 규칙이 없으니 GPTBot, ClaudeBot, PerplexityBot 같은 AI 크롤러도 모두 들어올 수 있습니다. 크롤러를 막지 않았는데도 검색 결과에 남은 흔적은 econ-radar뿐이었습니다.
Step 5. 서치콘솔, GA, hreflang, 언어 선언
git ls-tree -r --name-only origin/main | grep -iE 'google[0-9a-f]+\.html|naver[0-9a-f]+\.html|BingSiteAuth'   # 없음
git grep -n -iE 'site_verification|msvalidate|analytics|gtag' origin/main -- _config.yml _includes index.html   # 없음
git grep -l hreflang origin/main | wc -l                                                                         # 0
curl -s https://kakyungkim.github.io/kr/2026/09/11/gen-ai-drug-discovery-evidence/ | grep -o '<html[^>]*>'
# <html lang="en-US" class="no-js">
항목 | 결과 |
|---|---|
서치콘솔 소유 확인 흔적(구글, 네이버, 빙) | 0 |
GA 코드 | 0 |
hreflang | 0 / 180 페이지, 저장소 0개 파일 |
| 한국어 페이지 16개가 전부 |
마지막 줄은 이번에 처음 확인했습니다. _config.yml의 locale: "en-US"가 테마 레이아웃의 <html lang>으로 들어가, 한국어 글도 "이 문서는 미국 영어"라고 선언하고 있었습니다. 이중언어 사이트에서 언어를 알리는 장치 두 가지 중 hreflang은 없고 lang은 틀려 있었습니다.
Step 6. 속도 (PageSpeed Insights)
curl -s --max-time 90 "https://www.googleapis.com/pagespeedonline/v5/runPagespeed?url=...&strategy=mobile"
# HTTP 429 Quota exceeded ... 'Queries per day'
API는 키 없이 부르니 하루 할당량 초과(429)였습니다. 강의처럼 pagespeed.web.dev 화면에서 9/11 한국어 글을 돌렸더니, 4개 범주 모두 "페이지가 콘텐츠를 그리지 않았다(NO_FCP)" 오류로 점수가 나오지 않았습니다. 원인이 제 페이지인지 측정 쪽인지 가리지 못했으니 이번 주는 미측정으로 둡니다.
Step 7. AI 검색이 제 블로그를 인용하는가
ChatGPT와 Perplexity는 열지 않았습니다. 확인한 것은 Claude Code에 붙은 웹 검색 도구 세 번입니다.
검색어 | 내 블로그 인용 |
|---|---|
Ka-Kyung Kim bioinformatics drug discovery blog | 0 |
ADMET 데이터 분할 검증 scaffold split 블로그 김가경 | 0 |
kakyungkim.github.io | 0 (비슷한 이름의 다른 사람 사이트가 나옴) |
Step 8. 23기 이후 무엇을 했나
git log origin/main --since=2026-08-13 --format='%s' | wc -l                                 # 89
git log origin/main --since=2026-08-13 --format='%s' | grep -viE 'econ-radar|paper-radar' | wc -l   # 25
git log origin/main --since=2026-08-13 --format='%s' | grep -ciE 'seo|geo|hreflang|schema|sitemap|robots'   # 0
23기 4주차 강의 이후 커밋 89개 중 64개가 자동 발행이고, 사람이 한 25개는 CV와 홈 화면 문구 수정이었습니다. 검색 노출과 관련된 커밋은 0개입니다. _includes는 5/30 이후 손대지 않았습니다.
결과와 배운 점
측정 결과 (2026-10-04, 사이트맵 180개 주소)
항목 | 23기 4주차 | 이번 주 |
|---|---|---|
사이트맵 주소 | 117 | 180 |
구글 | (미측정) | 14건, 전부 econ-radar |
구글에 뜬 블로그 글 | (미측정) | 0 / 23 |
네이버 | (미측정) | 0 |
브레이브 | (미측정) | 1 (홈) |
덕덕고 | (미측정) | 9, 전부 영어판 |
사이트 체크 10항목, 블로그 글 | description, og, canonical 있음, og:image 없음 | 8점 (og:image, 검색로봇 메타태그 없음) |
사이트 체크 10항목, econ-radar | 메타데이터 전체 없음 | 4점 (126개) |
description이 있는 페이지 | (미측정) | 34 / 180 |
hreflang | 0 | 0 |
한국어 페이지의 | (미측정) | 16 / 16이 |
서치콘솔, GA 흔적 | 0 | 0 |
AI 웹 검색 인용 | (미측정) | 0 / 3회 |
검색 노출 관련 커밋 | 0 | 0 (89개 중) |
배운 점
메뉴판을 건 쪽이 안 뜨고 메뉴판 없는 쪽이 떴습니다. 블로그 글은 사이트 체크 8점이고 econ-radar는 4점인데, 구글에는 4점짜리 14개만 있고 8점짜리 23편은 하나도 없습니다. 강의의 식당 비유는 "봇이 문 앞에서 들어갈지 정한다"였는데, 제 경우는 봇이 아직 그 골목에 들어오지 않은 것으로 보입니다. 메타데이터를 갖춰도 봇이 찾아오지 않으면 소용이 없다는 점을 숫자로 확인했습니다. econ-radar만 나온 이유가 매일 새로 생기는 주소라서인지는 서치콘솔이 없어 확인하지 못했습니다.
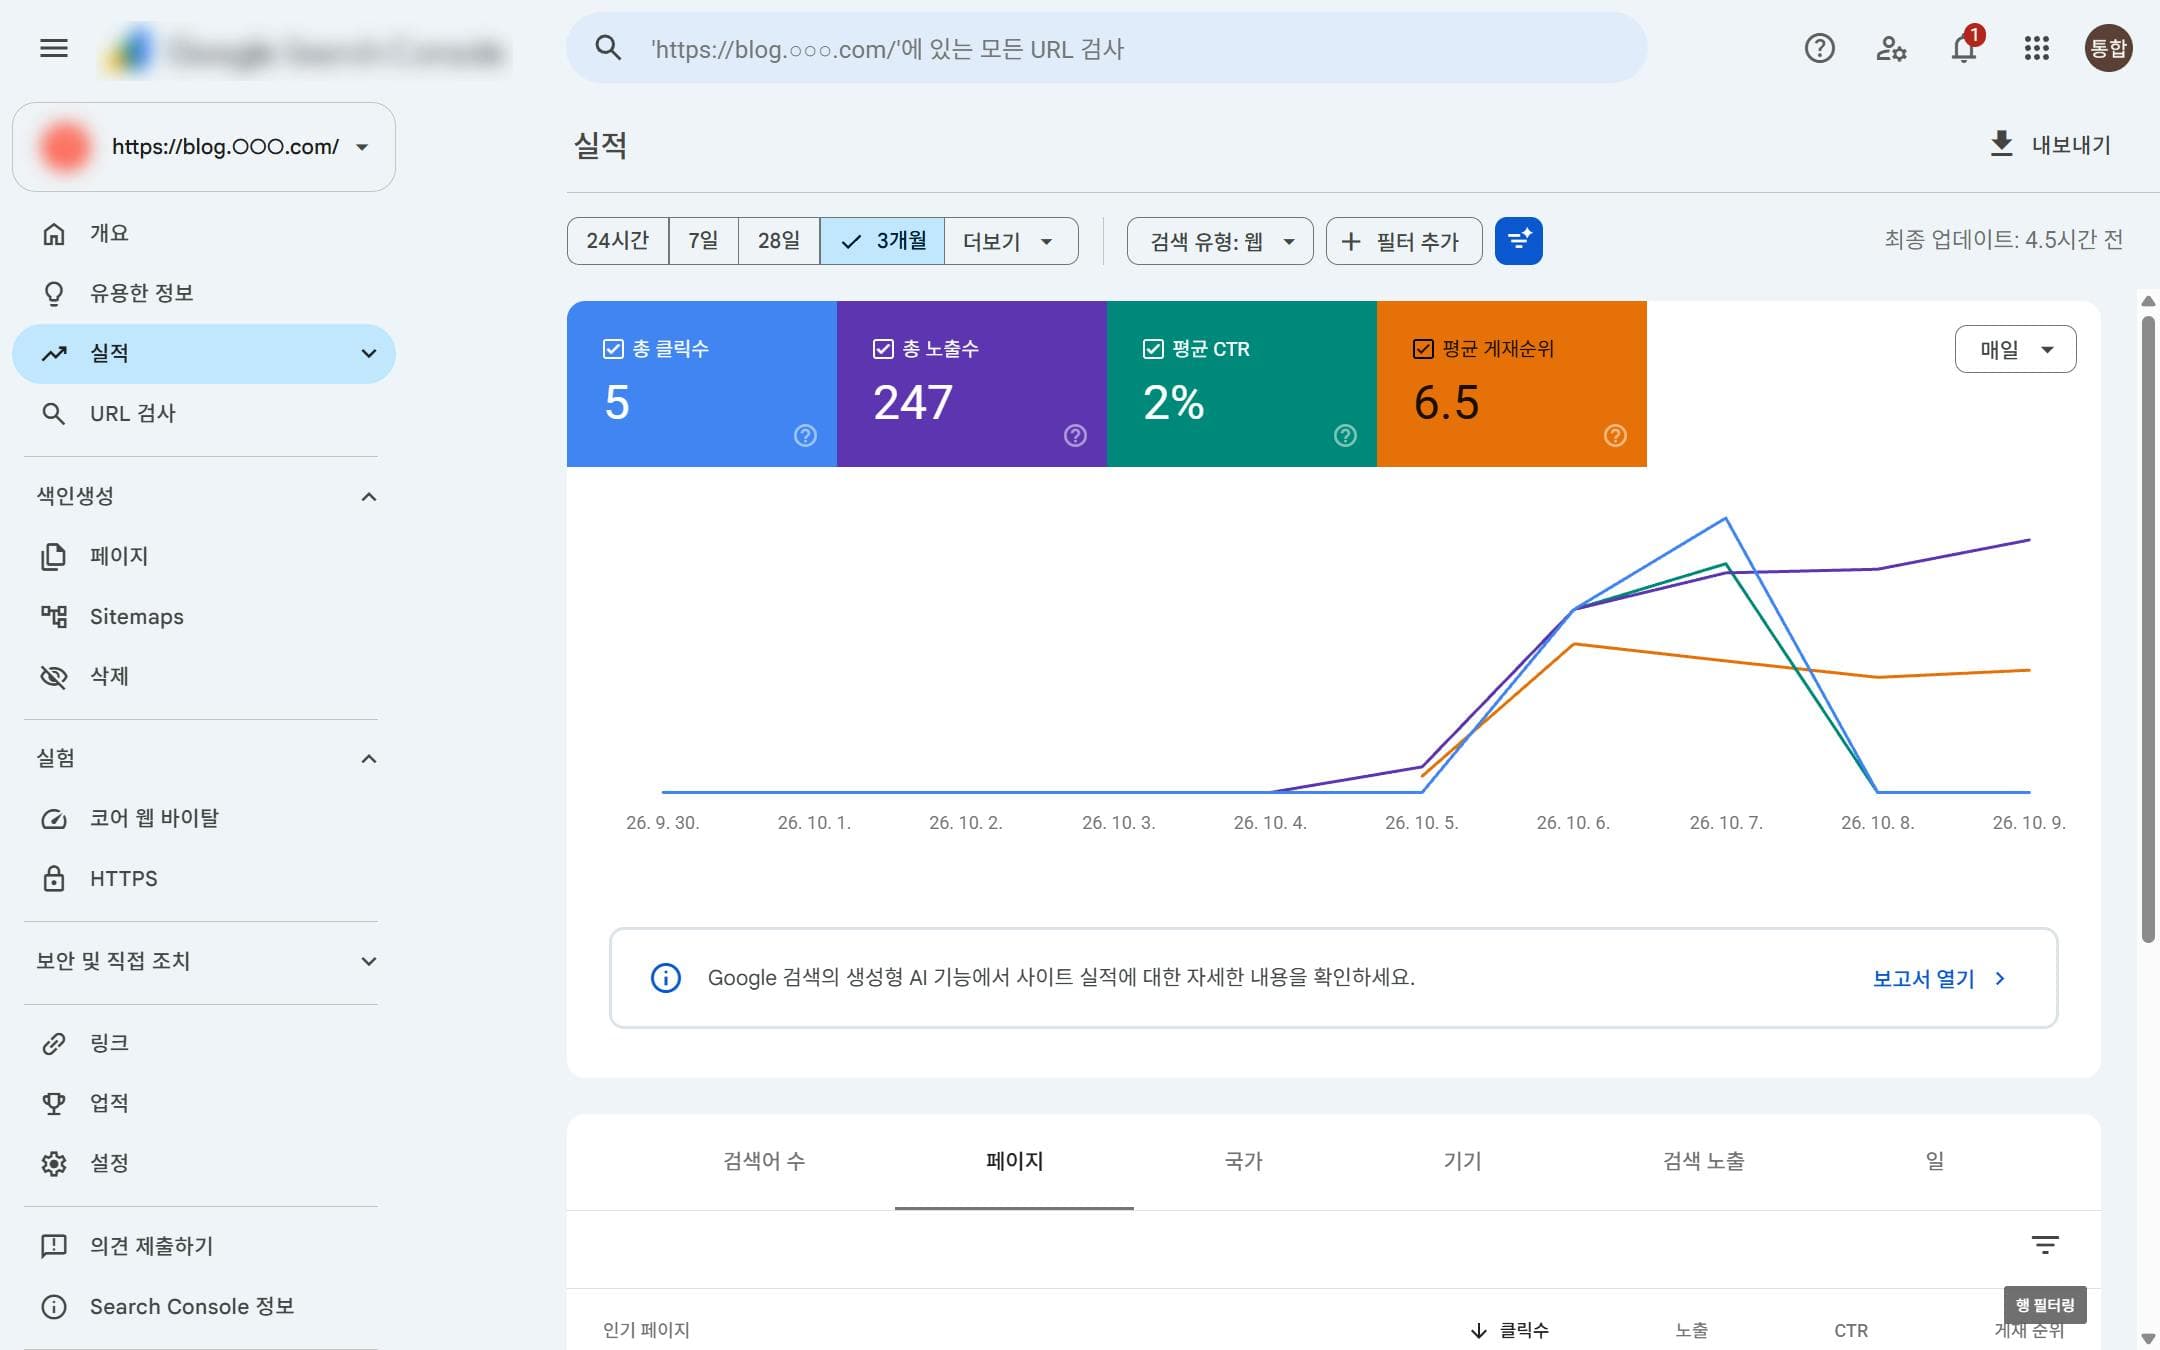
서치콘솔이 없으니 "왜 안 뜨는지"를 물을 곳이 없습니다. 이번 주 숫자는 전부 바깥에서 검색해 본 결과입니다. 구글이 블로그 글을 수집했는데 색인을 거절한 것인지, 아예 수집하지 않은 것인지는 서치콘솔의 색인 보고서로만 알 수 있습니다. 23기에 이걸 1순위로 적은 이유가 이번에 숫자로 돌아왔습니다.
이중언어 사이트는 언어 신호가 두 겹으로 어긋나 있었습니다. hreflang 0에 더해 한국어 글 16개가
en-US로 선언돼 있습니다. 덕덕고가 영어판 8편만 찾고 한국어판은 하나도 찾지 못한 것과 맞물려 보이지만, 인과는 아직 추정입니다. 설정 한 줄(locale)이 사이트 전체에 들어가는 Jekyll 구조라 고치는 범위도 한 곳입니다.구글이 제 사이트를 "GitHub Pages documentation"으로 부릅니다. 구글에 나온 econ-radar 페이지에는 사이트 이름을 알리는
og:site_name도 구조화 데이터도 없습니다. 이름을 모르니 상위 도메인의 이름을 빌려 쓴 것으로 추정합니다. AI가 저를 추천하려면 먼저 제 이름과 사이트를 이어 줄 신호가 있어야 하는데, 지금은 검색 결과에서 그 연결이 끊겨 있습니다.자동 발행은 7주 동안 54개를 늘렸고 손으로 할 일은 0이었습니다. 23기 4주차에 적은 "자동 파이프라인은 계속 찍어내고 손으로 하는 두 줄은 0"이 그대로 이어졌습니다. 이번에는 그 자동 발행분이 구글에 나온 유일한 묶음이라는 점이 달라졌습니다.
시행착오
curl로 구글을 긁으면 자바스크립트 이동 페이지만 와서 0건으로 오판할 뻔했습니다. 본문을 열어 보니 검색 결과 대신 "몇 초 안에 이동하지 않으면 여기를 클릭"이라는 안내문만 있었습니다. 구글, 빙, 브레이브는 크롬에서 다시 확인했습니다.
빙은
site:연산자에 무관한 중국어 사이트를 돌려줬습니다. 연산자를 빼고 도메인만 검색하니 제 페이지 6개가 나왔습니다. 빙의site:결과로 "빙 0건"이라 적으면 틀립니다.처음
<html lang>을 정규식으로 뽑았을 때 루트가kr로 나왔습니다. 정규식이data-lang="kr"을 읽어 낸 것이었고 실제 값은ko입니다.저장소에는 한국어 글 14편, 영어 13편이 있는데 사이트맵에는 12편, 11편입니다. 병리 파운데이션 모델 글이
published: false라 빠진 것을 확인하고 공개된 23편을 분모로 썼습니다.
이 측정은 2026년 10월 4일 오후(KST) kakyungkim.github.io의 사이트맵 주소 180개, 구글, 네이버, 빙, 브레이브, 덕덕고의 검색 결과, Claude Code 웹 검색 3회, 저장소 origin/main을 대상으로 했습니다. 검색 결과는 제 크롬 환경에서 본 것이라 다른 지역이나 계정에서는 다를 수 있고, ChatGPT와 Perplexity, PageSpeed 점수는 확인하지 못했습니다.
도움 받은 글 (옵션)
24기 GEO실험실 1주차 강의 (체크, 엔지): 구글, 네이버, 빙, 브레이브
site:점검 순서, 빙과 브레이브를 AI 검색 관점에서 보는 이유, PageSpeed는 세부 페이지를 보라는 조언, GEO LAB 사이트 체크 10항목, 식당 메뉴판 비유, 서치콘솔 등록 범위(브레이브는 인증 없이 제출)23기 GEO노출전략 1~4주차 사례글 (본인): 사이트맵 88, 92, 117개와 hreflang 0을 잰 기록. 이번 글의 비교 기준입니다
23기 글로벌현지화 사례글 (본인): 같은 블로그의 한/영 짝과 hreflang을 현지화 관점에서 다룬 글
로그인하고 댓글을 남겨 주세요

체계적으로 측정을 하셨네요 ㅎㅎ 한페이지만 보지 않고 180개 페이지를 모두 고려하신건 잘 하신것 같습니다. 올려주신 사이트가 구글에서 검색되는지 직접살펴봤는데 지금도 econ-radar만 나오고 있네요. 혹시 서치콘솔에서 개별 페이지에 대한 인덱싱 요청을 안하셨다면 몇개 해보셔도 좋을것 같아요. 메인페이지와 topics, 그리고 그 안에 있는 개별 글들 모두 해보셔도 좋을 것 같습니다!

서치콘솔 상단 검색창처럼 생긴 곳에 url 입력하고 엔터 누르면 개별페이지 인덱싱을 하실 수 있습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

Fri-mer님, 사이트맵 주소 180개 전체를 재고 나서 "구글에 뜬 블로그 글 23편 중 0편"이라는 숫자를 정면으로 적어주신 점이 좋았어요. 23기 때 사례글마다 1순위로 적었던 서치콘솔 등록과 hreflang이 7주 뒤 지금 어떤 상태인지 같은 기준으로 다시 본 연결이 설득력 있습니다.
빙에서 site: 결과가 중국어 사이트로 새서 연산자를 빼고 다시 검색해 6개를 찾으신 부분, 정규식이 data-lang="kr"을 읽어 lang이 kr로 나온 것을 ko로 바로잡은 부분처럼 측정 도구의 오류를 하나씩 걸러낸 과정이 신뢰를 높여줘요. 발행 안 된 글을 빼고 23편을 분모로 쓴 것도요.
이번 주는 고치지 않고 재기만 하고 계획으로 남기셨으니, 다음 주 변화가 더 선명하게 보일 것 같아요. 고롱고롱… 이런 꼼꼼한 기록 보면 기분 좋아져요 ✨