강의 점검 기준으로 내 블로그 검색 노출 재측정하기
2026.10.15
소개
2주차 강의에서 스터디장이 짚은 점검 기준 일곱 가지로 제 한/영 블로그를 다시 재 보고, 1주차에 적은 계획 네 가지가 실행되었는지 같은 명령으로 확인했습니다. 블로그나 개인 사이트를 운영하면서 지난 점검 이후 숫자가 실제로 움직였는지 확인하고 싶은 분, 그리고 강의의 점검 기준을 자기 사이트에 대 보고 싶은 분께 도움이 될 것 같습니다.
제 블로그(kakyungkim.github.io)는 Jekyll로 만든 한/영 이중언어 사이트입니다. 연구 노트를 한국어와 영어로 한 쌍씩 쓰고, 경제 브리핑(econ-radar)과 논문 다이제스트(paper-radar)가 매일 자동으로 올라갑니다. 저는 이 스터디를 청강하며 1주차에 이 사이트의 현재 상태를 재 보았고, 그때는 고치지 않고 재기만 했습니다.
이번 2주차는 목요일 수업이 아니라 10월 10일 토요일에 오프라인으로 모여, 수강생 여섯 분의 사이트를 화면에 띄워 놓고 스터디장이 즉석에서 피드백하는 시간이었습니다. 여섯 사이트에서 같은 지적이 되풀이되었습니다. 메뉴를 눌러도 주소가 바뀌지 않고 #만 붙는 구조, 제목 태그가 글의 구조를 나타내지 못하는 글, 한 페이지에 주제가 뭉친 구조, 옛 이름이나 상위 브랜드와의 관계가 어디에도 적혀 있지 않은 상태입니다. 후반에는 AI 노출을 재는 방법(질문을 정해 두고 같은 질문을 반복해서 묻기)과 서치콘솔과 GA(구글 애널리틱스)의 차이도 다루었습니다. 녹화에서 과제 안내는 확인되지 않아, 이 글은 강의가 짚은 기준을 제 사이트에 직접 대 본 기록입니다.
측정은 2026년 10월 14일에 했고, 이번에도 블로그 설정은 고치지 않았습니다. 분모는 1주차와 같이 사이트맵의 공개 주소 기준입니다.
24
진행 방법
사용 도구: Claude Code, curl, Python 3, git, 크롬(검색엔진 화면 확인), Claude Code의 웹 검색 도구
Step 1. 강의 기준의 측정 항목 정리
강의에서 나온 지적 가운데 제 사이트에 잴 수 있는 것을 골랐습니다. 서치콘솔 계정 안은 볼 수 없으므로, 공개된 페이지와 저장소에서 확인되는 흔적만 셉니다.
강의에서 나온 기준 | 처음 나온 사이트 | 이 글에서 재는 것 |
|---|---|---|
메뉴가 | 캐시군, 전해수 | 홈의 |
제목 태그는 데이터에서 제목으로 읽힌다 | asap, 캐시군 | 글마다 H1이 한 개인가, 본문에 H2가 있는가 |
글 스키마는 구조로 자동 생성한다 | 캐시군 | 글에 Article 계열 스키마가 들어가는가 |
사이트맵 수정 시각이 갱신되어야 한다 | 벨라 |
|
언어마다 URL이 따로 있어야 한다 | 벨라 | 한/영 주소 분리, lang 선언, hreflang |
검색엔진 등록은 가능한 곳 모두 | 문숙 | 확인 태그, 인증 파일, 설정 키 |
AI 노출은 같은 질문을 반복해서 잰다 | 스터디장 | 질문 세트를 정해 인용 여부 보기 |
Step 2. 사이트맵 주소 재집계
로컬 저장소가 원격보다 늦어 먼저 받아 왔고, 저장소 쪽 확인은 모두 origin/main 기준으로 했습니다.
cd ~/kakyungkim.github.io && git fetch -q origin
git rev-list --left-right --count HEAD...origin/main      # 0  7
curl -s https://kakyungkim.github.io/sitemap.xml | grep -o "<loc>[^<]*" | wc -l   # 192
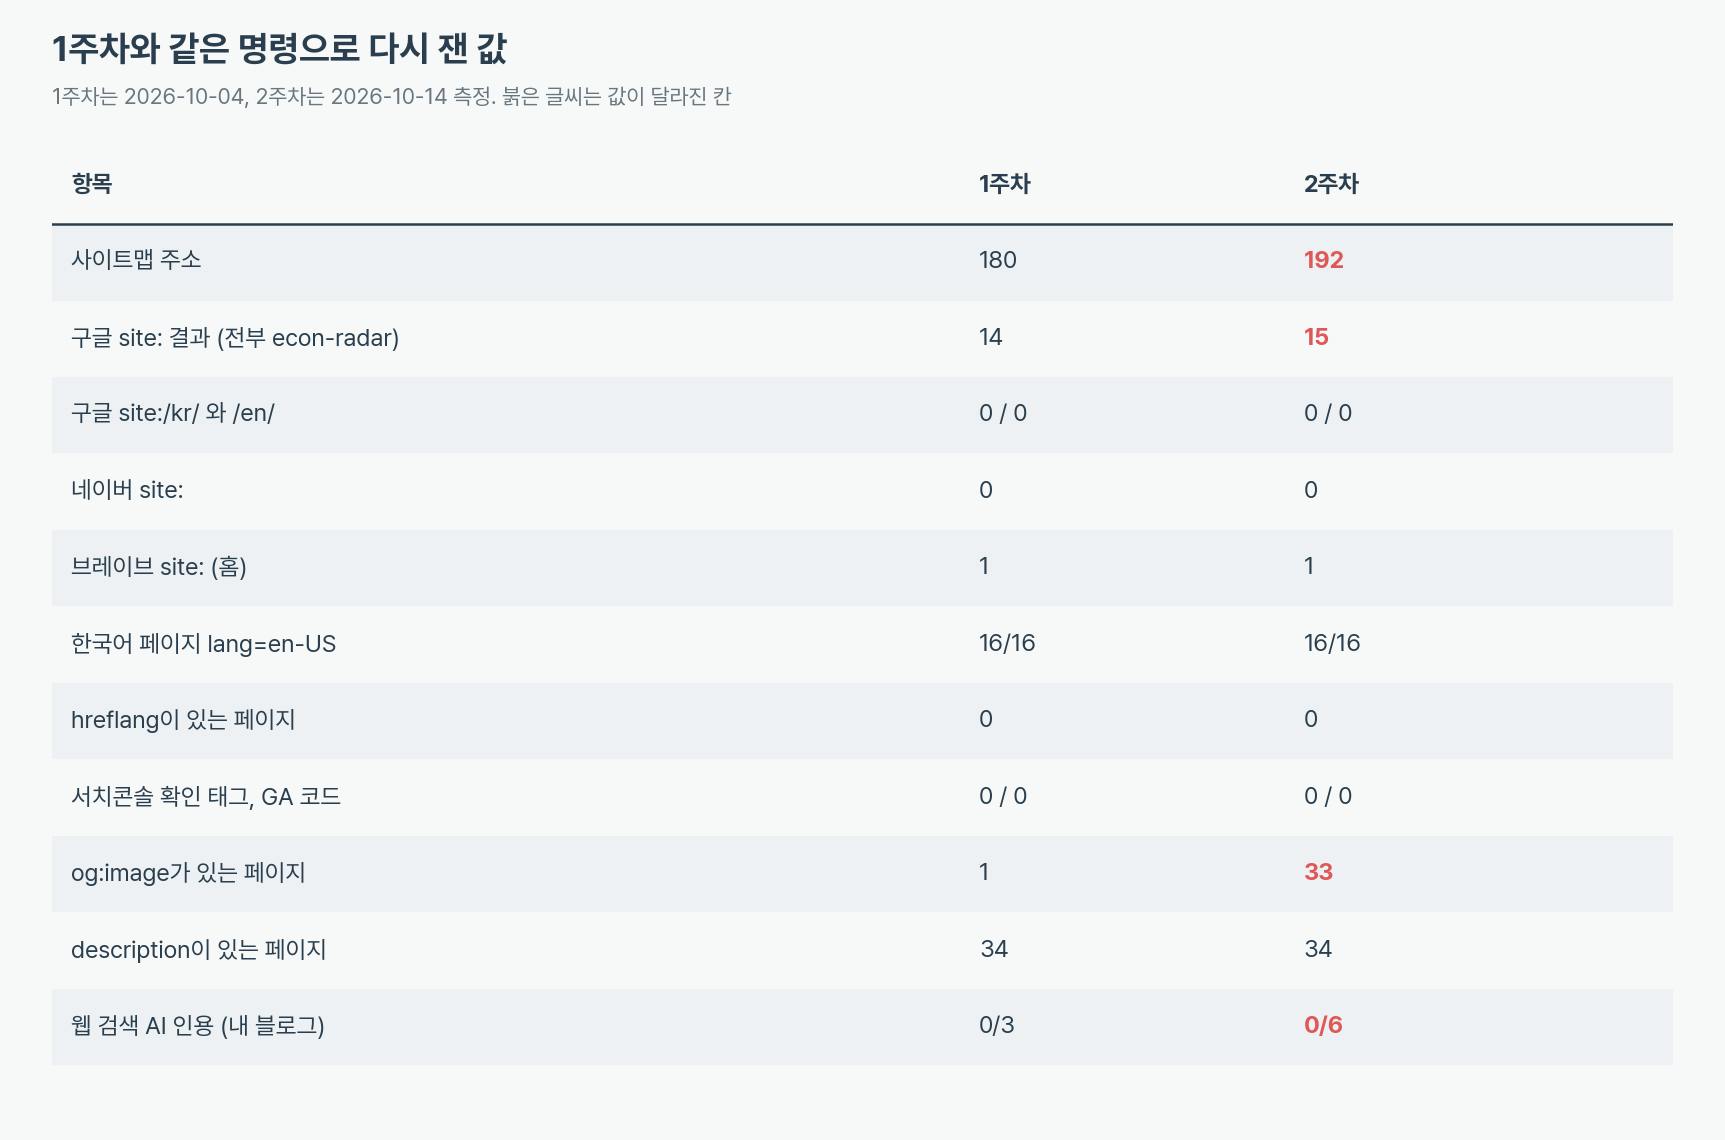
주소는 1주차 180개에서 192개로 12개 늘었고, 늘어난 것은 모두 econ-radar입니다(일간 10개, 주간 동향 2개). 같은 스크립트로 모든 주소의 <head>를 내려받아 세었습니다.
구성 | 1주차 (10/4) | 이번 주 (10/14) |
|---|---|---|
econ-radar 리포트 | 127 | 139 |
paper-radar 리포트 | 17 | 17 |
한국어 페이지( | 16 | 16 |
영어 페이지( | 15 | 15 |
발표 자료, 기타 | 5 | 5 |
합계 | 180 | 192 |
여기서 1주차 글의 정정이 하나 있습니다. 1주차에 공개 글을 "한국어 12편, 영어 11편, 합쳐 23편"이라고 적었는데, /kr/ 16개에서 홈, 소개, 주제 세 쪽을 빼면 13편이고 /en/ 15개에서 빼면 12편입니다. 합치면 25편이 맞습니다. 2025년 9월 2일에 쓴 글의 한/영 한 쌍을 1주차 집계에서 빠뜨렸고, 한/영 짝은 11쌍이 아니라 12쌍(9월 8일 ADMET 글은 한국어판뿐)입니다. 1주차의 "구글에 뜬 블로그 글 0편"은 그대로 유효하고, 이번에는 분모를 25편으로 씁니다.
Step 3. 1주차 계획 네 가지의 실행 여부
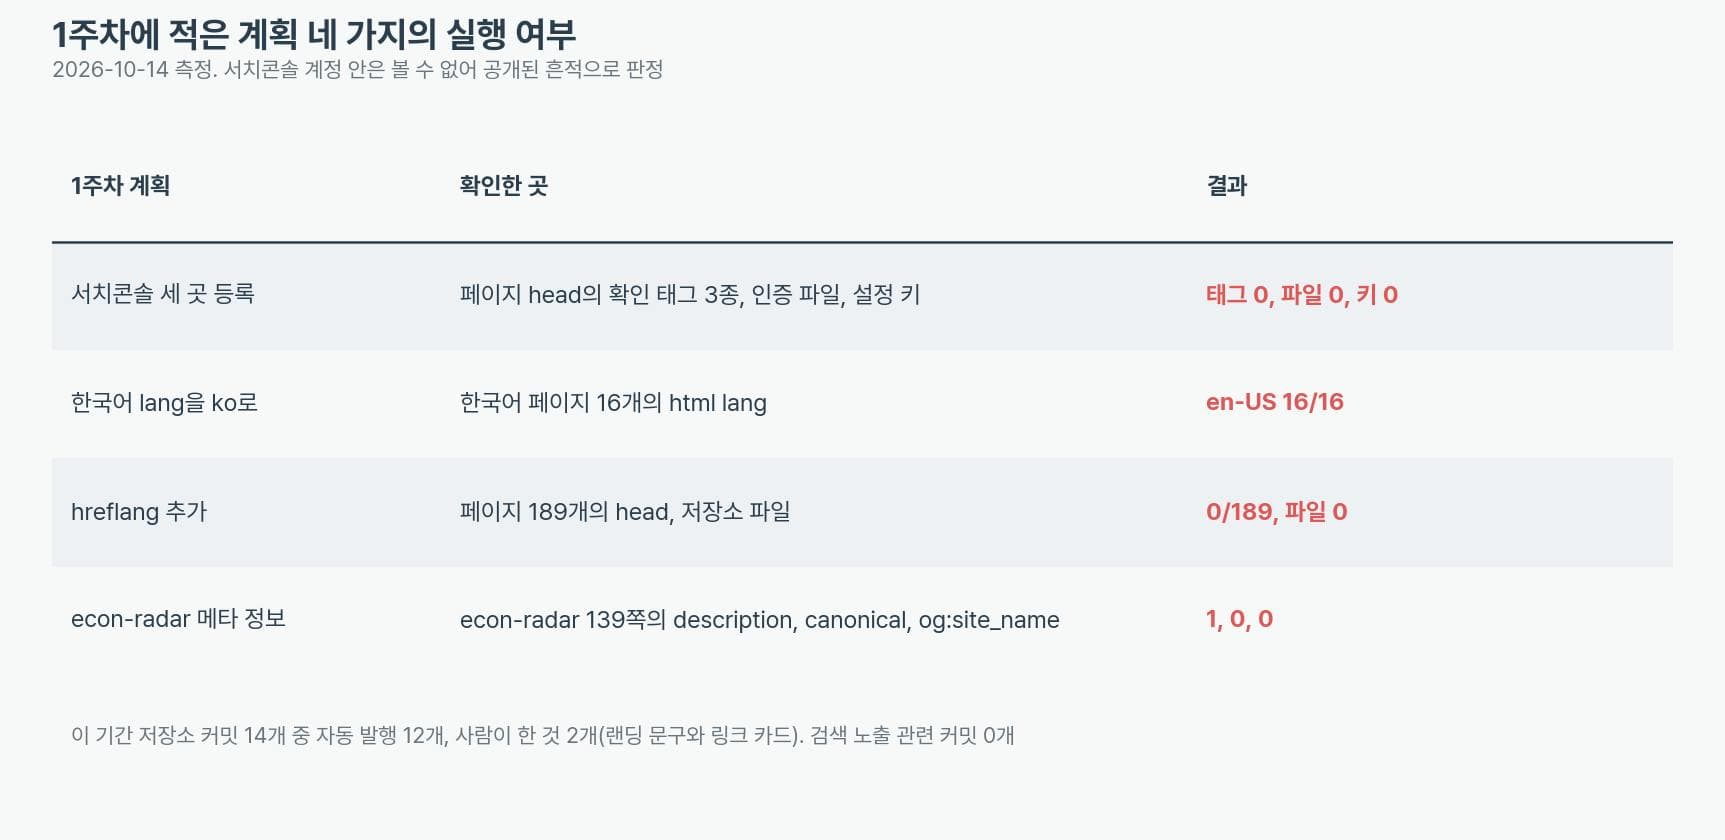
1주차 계획이 실제로 저장소에 반영되었는지 같은 명령으로 확인했습니다.
git ls-tree -r --name-only origin/main | grep -iE 'google[0-9a-f]+\.html|naver[0-9a-f]+\.html|BingSiteAuth'   # 없음
git show origin/main:_config.yml | grep -nE 'site_verification|^locale'      # locale: "en-US" 한 줄뿐
git grep -l -i hreflang origin/main | grep -v _site | wc -l                  # 0
git log origin/main --since=2026-10-04T12:00:00+09:00 --format='%s' | wc -l   # 14
curl -s https://kakyungkim.github.io/kr/2026/09/11/gen-ai-drug-discovery-evidence/ | grep -o '<html[^>]*>'
# <html lang="en-US" class="no-js">
1주차 계획 | 결과 |
|---|---|
서치콘솔 구글, 빙, 네이버 등록 | 페이지의 확인 태그 0개, 인증 파일 0개, 설정 키 0개. 공개된 흔적이 없음 |
한국어 | 한국어 페이지 16개 전부 |
hreflang 추가 | 페이지 189개 중 0개, 저장소 파일 0개 |
econ-radar에 description, canonical, | econ-radar 139쪽 중 description 1(목록 페이지), canonical 0, |
14개 커밋 가운데 12개는 econ-radar 자동 발행이고, 사람이 한 2개는 랜딩 화면의 문구와 링크 카드 수정입니다. 제목이나 내용에 SEO, 사이트맵, 언어, 검색 관련 단어가 들어간 커밋은 0개입니다. 브레이브 제출은 공개된 흔적이 남지 않아 판정하지 않았습니다.
Step 4. 검색엔진 네 곳의 site: 결과
1주차와 같은 검색어를 다시 넣었습니다. 구글, 빙, 브레이브는 크롬에서 직접 열었고 네이버는 curl로 받았습니다.
curl -s -A "$UA" --max-time 20 "https://search.naver.com/search.naver?query=site%3Akakyungkim.github.io" | grep -c "검색결과가 없습니다" # 1
검색엔진 | 검색어 | 1주차 | 이번 주 |
|---|---|---|---|
구글 |
| 14건, 전부 econ-radar | 15건 (2쪽), 전부 econ-radar |
구글 |
| 0건 | 0건 |
구글 |
| 0건 | 0건 |
네이버 |
| 0건 | 0건 |
빙 |
| 무관한 결과만 | 무관한 결과만(zhihu, baidu 등) |
빙 |
| 고유 주소 6개 | 고유 주소 6개 |
브레이브 |
| 1건(홈) | 1건(홈) |
구글에 나온 15건의 사이트 이름은 이번에도 모두 "GitHub Pages documentation"이었고, 가장 최근 리포트가 9월 23일자입니다. 9월 24일 이후 발행한 리포트는 목록에 없었습니다. 빙은 도메인만 검색했을 때 홈, 한국어 소개, 2025년 9월 글의 한/영 한 쌍, econ-radar 2개, 깃허브 3개가 나왔습니다. 블로그 글이 검색엔진에 잡힌 것은 이 한 쌍이 전부입니다. 덕덕고는 이번에 결과 목록이 늦게 불러와져 읽지 못해 표에서 뺐습니다.
Step 5. 강의 기준 일곱 가지의 적용 결과
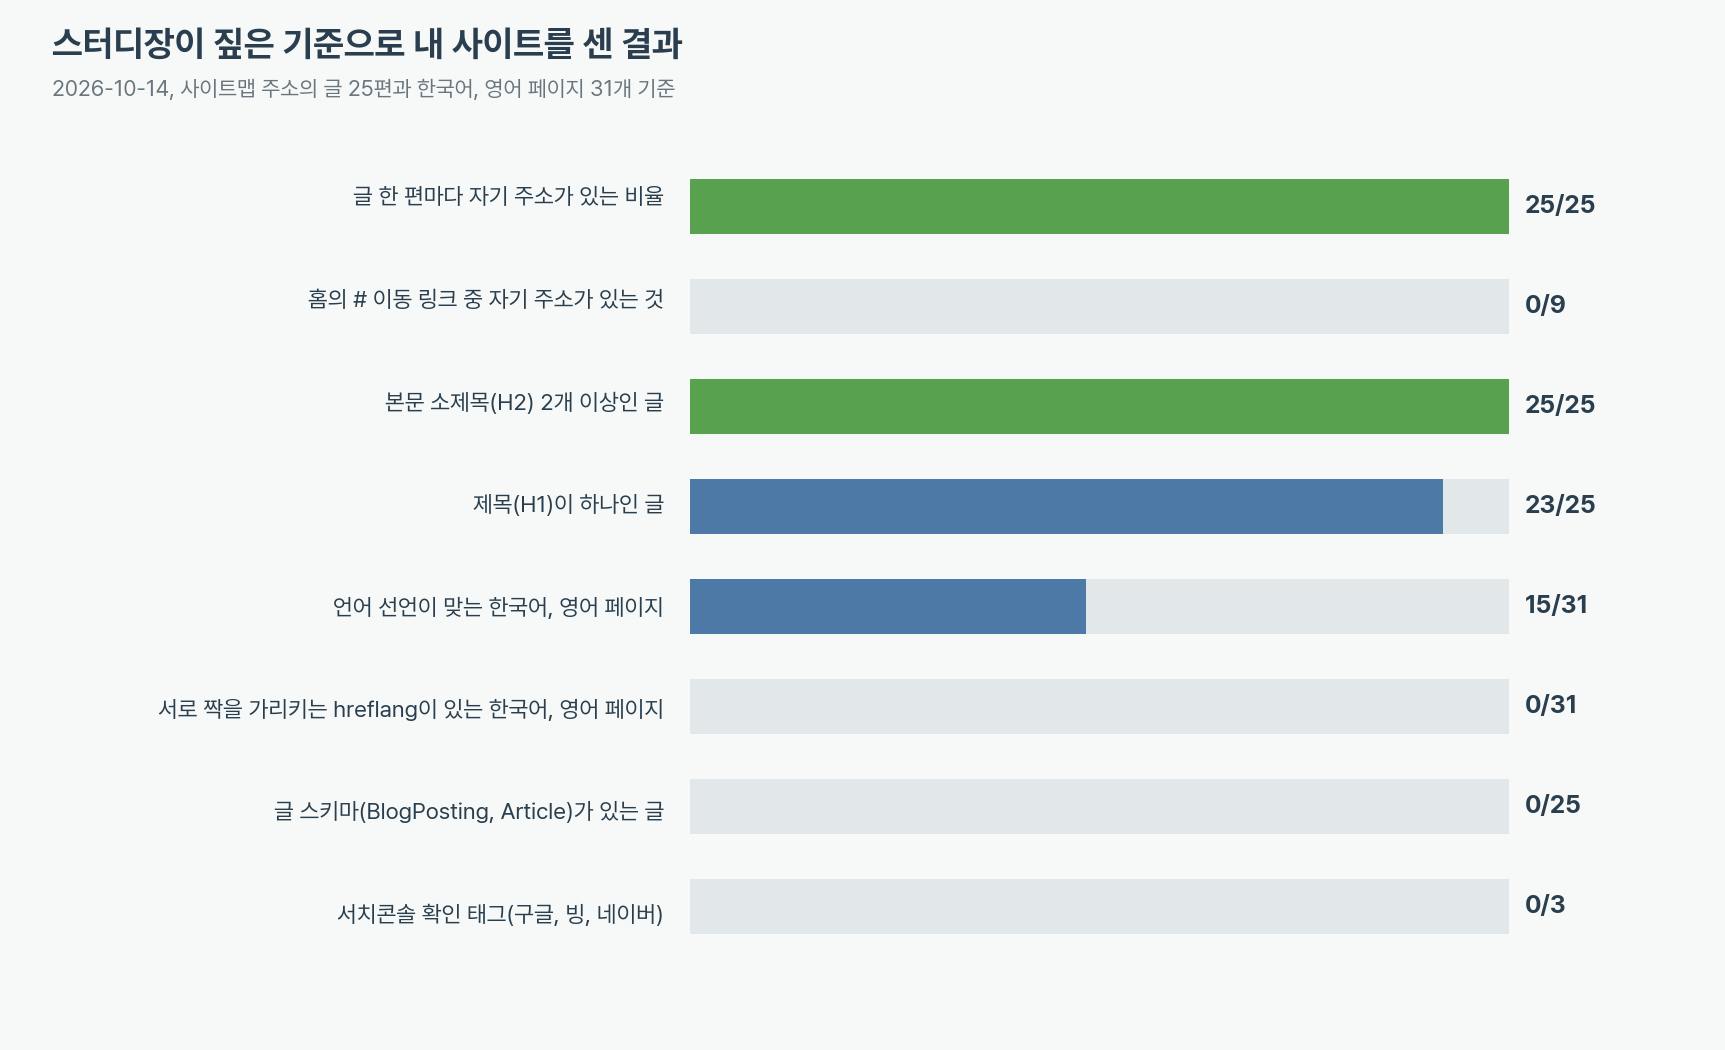
스터디장은 메뉴를 눌렀을 때 주소 뒤에 #만 붙는 구조는 별개 페이지로 인정되지 않는다고 했습니다. 제 홈은 이력서형 한 페이지 사이트라 메뉴가 전부 #입니다.
curl -s https://kakyungkim.github.io/ | grep -oE '<a [^>]*href="#[^"]*"' | wc -l      # 9
curl -s https://kakyungkim.github.io/ | grep -oE 'href="#[a-z]+"' | tr '\n' ' '
# #top #about #experience #publications #built #talks #community #writing #contact
홈의 # 이동 링크 9개는 어느 것도 자기 주소를 갖지 않습니다. 반면 글은 한국어, 영어 25편이 모두 자기 주소를 가지고 있습니다. 제목 구조는 글 25편의 <h1>과 본문 안의 <h2>를 셌습니다.
posts = [p for p in pages if re.match(r".*/(kr|en)/\d{4}/\d\d/\d\d/", p["url"])]
sum(p["h1"] == 1 for p in posts)                     # 23
sum(p["content_h2"] >= 2 for p in posts)             # 25  (본문 H2 4개에서 12개)
본문 H2는 25편 모두 4개 이상이고, H1이 하나인 글은 23편입니다. 나머지 2편은 2025년 9월 2일 글의 한/영 쌍으로, 본문 안에 H1이 하나 더 있어 한 페이지에 H1이 2개입니다. 스키마는 application/ld+json을 셌고, 있는 페이지는 홈 하나(Person, 소속 기관, sameAs 4개)뿐입니다. 글에는 BlogPosting이나 Article 스키마가 0/25입니다.
사이트맵은 192개 중 185개에 lastmod가 있습니다. 25개는 각 글의 작성일이고 나머지 160개가 모두 2026-10-13 10:44(UTC)로 같은 시각입니다. 마지막 배포 시각과 같다는 사실까지만 확인했고, 이 값이 배포 때마다 바뀌는지는 한 번의 스냅샷으로는 알 수 없습니다. 언어는 한/영 글이 /kr/와 /en/로 주소가 갈라져 있고 쌍이 12개입니다. 그러나 한국어 페이지 16개의 lang은 en-US이고 영어 페이지 15개는 맞으며, hreflang은 0입니다. 그림은 이 일곱 가지 가운데 분수로 셀 수 있는 것을 모았습니다.
Step 6. 사이트 체크 10항목 점수
1주차와 같은 10항목(title, description, canonical, og:title, og:description, og:image, viewport, 검색로봇 메타태그, 사이트맵, robots.txt)을 189개 페이지의 <head>에서 세었습니다. PDF 3개는 <head>가 없어 제외했습니다.
묶음 | 쪽수 | 평균 점수 (1주차 → 이번 주) | 달라진 이유 |
|---|---|---|---|
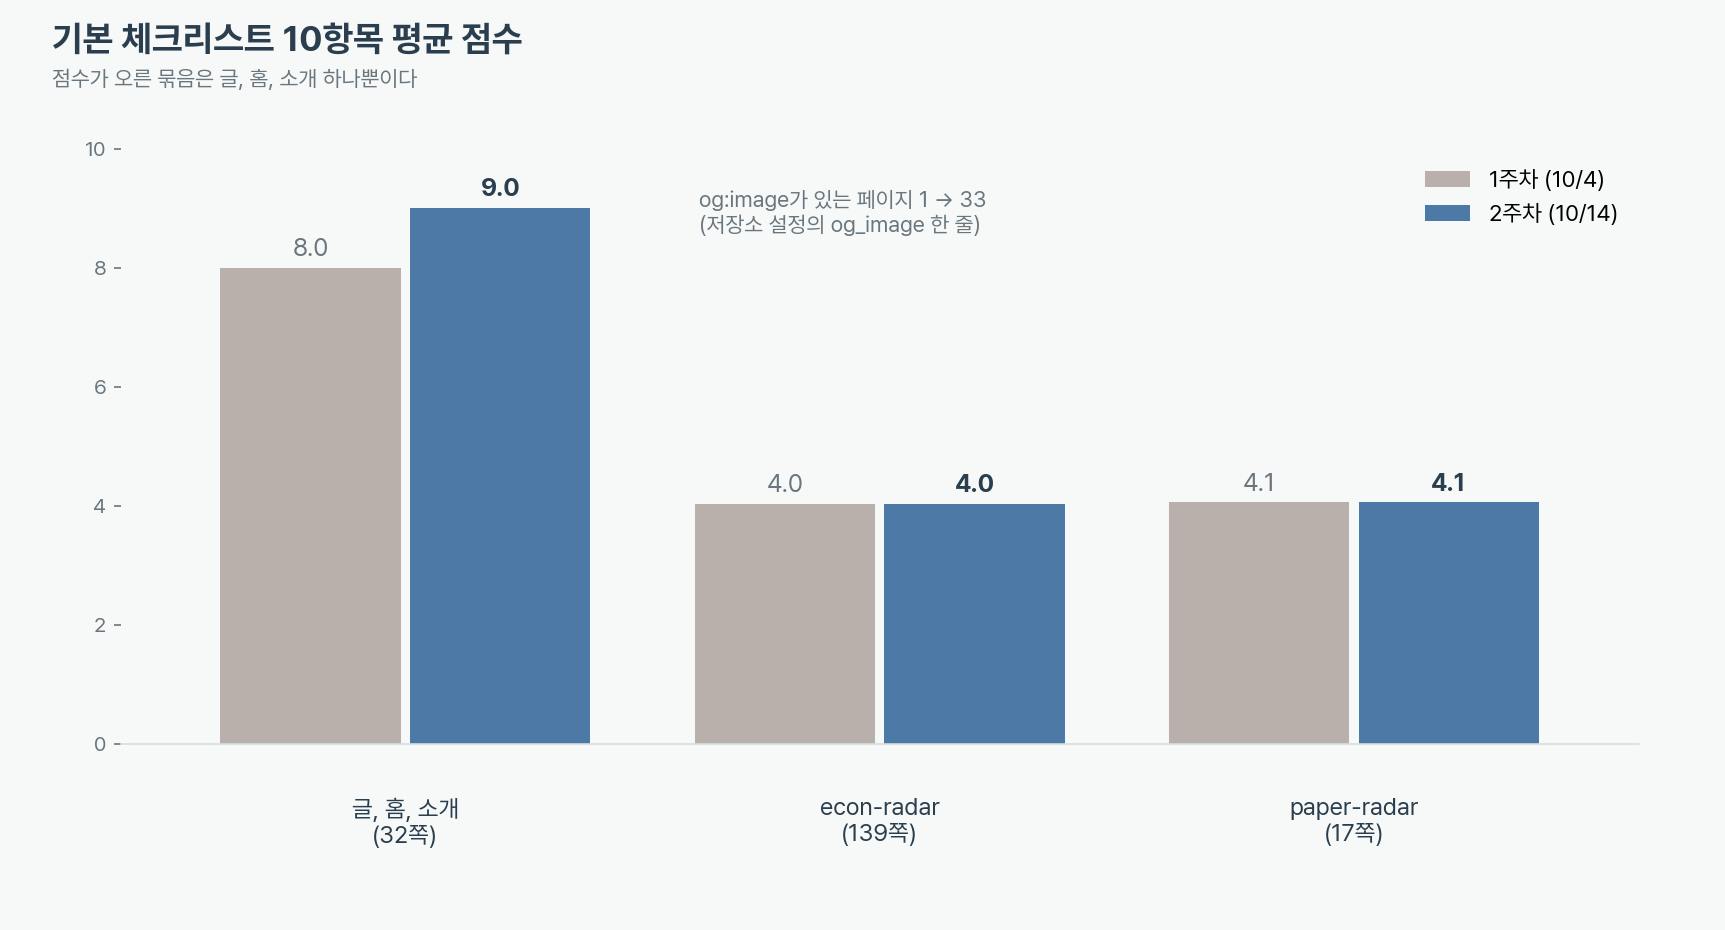
글, 홈, 소개 | 32 | 8.0 → 9.0 | og:image가 생김 |
econ-radar | 139 | 4.0 → 4.0 | 변화 없음 |
paper-radar | 17 | 4.1 → 4.1 | 변화 없음 |
글, 홈, 소개가 9점으로 오른 것은 10월 5일 랜딩 개편 커밋이 _config.yml에 og_image 한 줄을 넣어서입니다. 설정의 주석에는 링크 미리보기 기본 이미지라고 적혀 있고, 검색 노출 계획과는 관계가 없습니다. og:image가 있는 페이지는 1개에서 33개가 되었고, 전체 평균은 4.71에서 4.88입니다. 검색로봇 메타태그는 여전히 0쪽입니다.
Step 7. AI 노출 질문 세트의 예비 측정
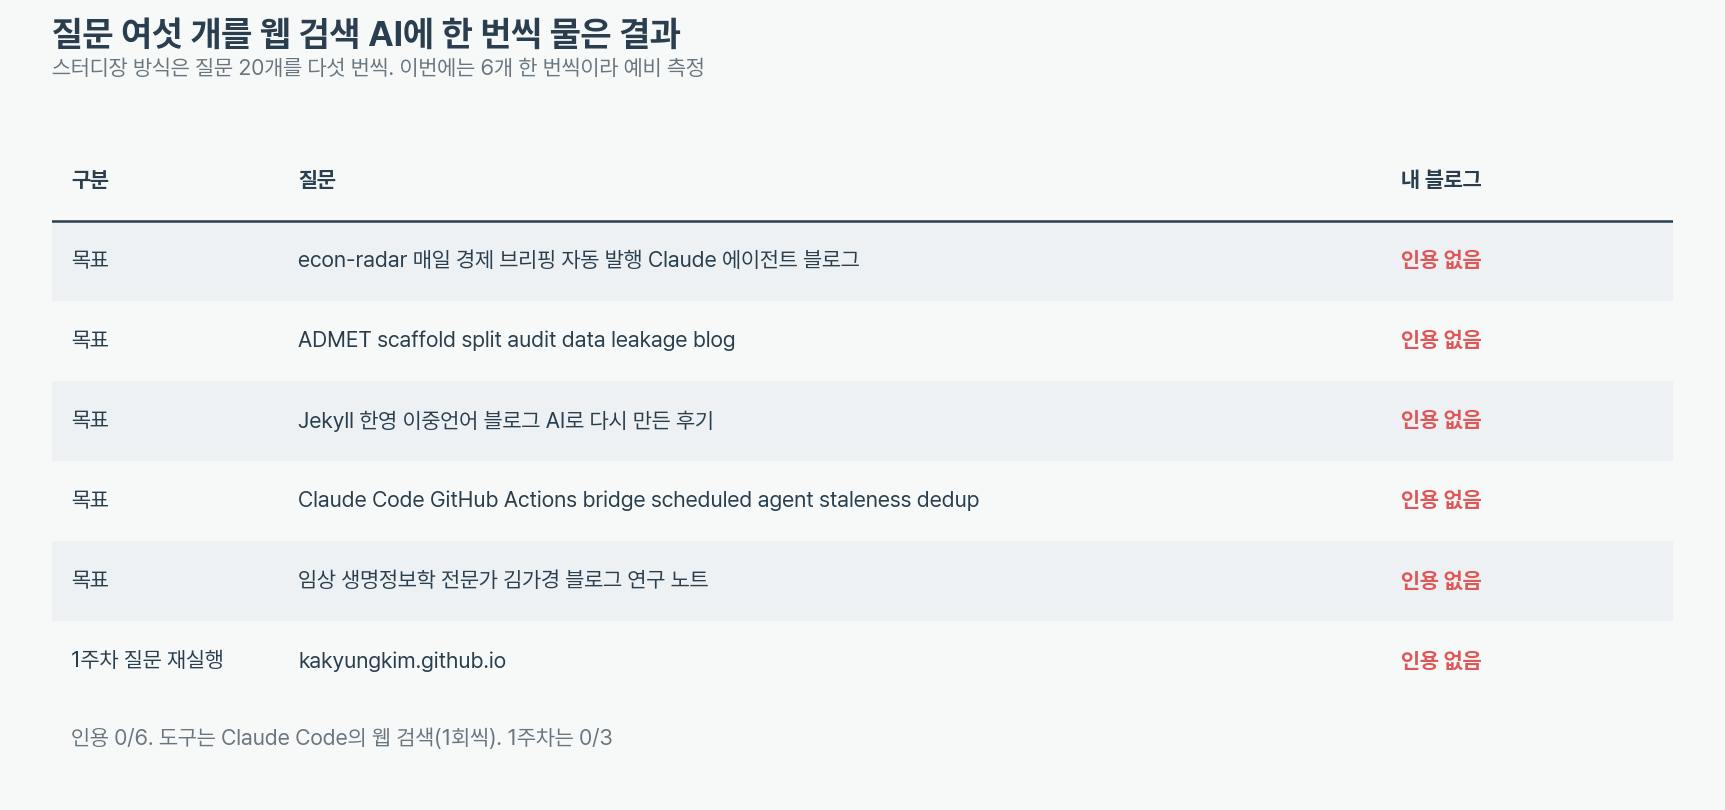
스터디장의 방식은 질문 20개를 정해 놓고 다섯 번씩 물어, 내 사이트가 링크로 인용되는지, 이름만 언급되는지, 언급이 긍정인지 중립인지 세는 것입니다. 저는 질문 여섯 개를 한 번씩만 물었으므로 예비 측정입니다. 도구는 1주차와 같은 Claude Code의 웹 검색입니다. 질문 다섯 개는 제 블로그 글의 주제에서 뽑았고, 하나는 1주차에 쓴 질문(kakyungkim.github.io)을 다시 썼습니다.
질문 | 내 블로그 인용 |
|---|---|
econ-radar 매일 경제 브리핑 자동 발행 Claude 에이전트 블로그 | 없음 |
ADMET scaffold split audit data leakage blog | 없음 |
Jekyll 한영 이중언어 블로그 AI로 다시 만든 후기 | 없음 |
Claude Code GitHub Actions bridge scheduled agent staleness dedup | 없음 |
임상 생명정보학 전문가 김가경 블로그 연구 노트 | 없음 |
kakyungkim.github.io | 없음 (비슷한 이름의 다른 사이트가 나옴) |
세 번째 질문의 결과에는 제 블로그 대신 제가 23기에 지피터스에 올린 사례글이 나왔습니다. 한/영 이중언어 블로그의 현지화를 다룬 글입니다. 질문 여섯 개 가운데 AI 답변에 제 이름으로 오른 것은 블로그가 아니라 이 지피터스 글 하나였습니다.
결과와 배운 점
측정 결과 (2026-10-14, 사이트맵 192개 주소와 그중 글 25편)
항목 | 1주차 (10/4) | 이번 주 |
|---|---|---|
사이트맵 주소 | 180 | 192 |
공개 글 | 23편으로 집계(정정: 25편) | 25편 |
구글 | 14건, 전부 econ-radar | 15건, 전부 econ-radar |
구글에 뜬 블로그 글 | 0 | 0 / 25 |
한국어 페이지의 | 16/16이 | 16/16이 |
hreflang | 0 | 0 |
서치콘솔 확인 태그, GA 코드 | 0, 0 | 0, 0 |
사이트 체크 10항목, 글과 홈, 소개 | 8점 | 9점 (og:image) |
글의 스키마(BlogPosting, Article) | (미측정) | 0 / 25 |
AI 웹 검색 인용 | 0/3 | 0/6 |
1주차의 계획 네 가지가 저장소에 반영되지 않은 상태에서, 구글 site:의 15건이 전부 econ-radar이고 블로그 글은 25편 중 0편이었습니다. 이 결과는 2026-10-14 kakyungkim.github.io 사이트맵 주소 192개, 구글, 네이버, 빙, 브레이브의 site: 검색 한 번씩, 웹 검색 질문 6개 한 번씩을 기준으로 합니다.
배운 점
고치지 않으면 숫자가 그대로입니다. 10일 사이 주소는 12개 늘었는데 lang, hreflang, 서치콘솔 태그, econ-radar 메타 정보는 모두 1주차와 같았습니다. 점수가 오른 것은 계획에 없던
og_image한 줄 때문이었습니다. 측정만 반복해서는 숫자가 움직이지 않는다는 것을 같은 명령으로 확인했습니다.자동으로 늘어나는 쪽만 검색 결과에 남았습니다. 구글에는 econ-radar 15건이 있는데 가장 최근 것이 9월 23일이라 9월 24일 이후 리포트는 아직 색인되지 않은 것으로 보입니다. 서치콘솔이 없어 색인 요청 여부와 수집 상태는 볼 수 없습니다. 노출을 가르는 것은 내용을 어떻게 발견하게 하느냐라는 스터디장의 말을 제 사이트에 대 보면, 발견되는 길이 econ-radar 쪽에만 열려 있습니다.
한 페이지짜리 홈은
#링크 9개가 전부입니다. 제 홈은 이력서형이라#about,#publications,#talks가 별도 주소가 아닙니다. 논문, 만든 것, 발표가 각각 자기 주소를 가졌다면 강의의 기준으로는 페이지가 늘어나는 것이고, 반대로 이력서 한 장짜리 사이트에는 한 페이지가 자연스럽기도 합니다. 이 기준이 제 홈에도 맞는지는 서치콘솔에서 홈과 소개 페이지의 클릭을 본 뒤에 정할 일입니다.글은 구조가 갖춰져 있는데 스키마가 없습니다. 본문 H2가 모든 글에 4개 이상 있고 H1도 23편이 하나인데, 글 스키마는 0편입니다. 스터디장은 글을 올릴 때 기본으로 아티클 스키마가 들어가게 구조를 셋업한다고 했습니다. 제 사이트에서는 홈에만 Person 스키마가 있어, 글과 저자를 이어 주는 정보가 홈에서 끊깁니다.
AI가 인용한 곳은 블로그가 아니라 지피터스였습니다. 스터디장 시연에서 AI가 추천 근거로 가져온 곳이 가게의 자체 사이트가 아니라 제3의 플랫폼이었습니다. 제 질문 6개에서도 제 이름이 오른 것은 지피터스 글 하나였습니다. 한 번씩만 물은 예비 측정이라 반복하면 달라질 수 있습니다.
시행착오
처음 집계한 1주차 공개 글 23편이 틀렸습니다. 사이트맵에서
/kr/아래 주소를 세다가 "16개 중 글 12개"가 맞지 않는 것을 보고 25편으로 바로잡았습니다. 분모가 틀리면 "0편"이라는 결론은 같아도 비율이 틀립니다.제목 구조를 처음 셀 때 페이지 전체의
<h2>를 세었더니, 모든 글에서 소제목 단계가 건너뛴 것으로 나왔습니다. 사이드바와 "관련 글" 목록의 제목 태그까지 센 탓이었습니다. 본문 영역(page__content)만 세도록 고치니 건너뜀이 0이 되었습니다.덕덕고는 결과 목록이 늦게 불러와져 첫 항목밖에 읽히지 않았습니다. 일부만 읽은 값을 쓰지 않고 표에서 뺐습니다.
구글 검색 결과 텍스트에는 서치콘솔 안내 문구("웹마스터이십니까?")가 붙어 있었습니다. 소유권 인증의 증거로 읽을 수 없어 판정에 쓰지 않았습니다.
도움 받은 글
24기 GEO실험실 2주차 강의 (스터디장 체크, 버디 엔지): 샵(#) 주소와 URL 분리, H1과 H2 구조, 아티클 스키마 자동 셋업, 사이트맵 수정 시각, 언어별 페이지, 검색엔진 등록 범위, 같은 질문을 반복해서 재는 AI 노출 측정, 서치콘솔과 GA의 차이
24기 GEO실험실 1주차 사례글 (본인): 이번 글의 비교 기준이 된 측정 방법과 값, 1주차 계획
23기 글로벌현지화 사례글 (본인): 이번 질문 3의 검색 결과에 나온 글
지피터스 뽀짝이 요약본 (24기 GEO실험실 2주차): 강의 자막의 오인식을 바로잡고 사이트별 흐름을 확인하는 데 참고

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요