AI 노출 질문 세트와 대상 글 준비도 점검하기
2026.10.26
소개
4주차 강의에서 스터디장이 짚은 AI 가시성 측정 요령으로 제 한/영 블로그를 다시 재 보고, 지난주 계획 열 가지가 어디까지 실행됐는지 확인했습니다. 새로 만든 것은 AI 노출 질문 20개가 가리키는 글이 그 질문에 답할 준비가 되어 있는지 점검하는 감사 스크립트입니다. 블로그나 개인 사이트에 "AI에게 물어볼 질문"은 만들어 두었는데 그 질문이 어느 글을 가리키는지 확인해 본 적이 없는 분, 그리고 서치콘솔에서 색인 요청을 한 뒤 무엇이 달라지는지 궁금한 분께 도움이 될 것 같습니다.
제 블로그는 Jekyll로 만든 한/영 이중언어 사이트입니다. 저는 이 스터디를 청강하며 1주차부터 3주차까지 사이트 상태를 같은 명령으로 재 왔고, 3주차 글을 올린 뒤인 10월 22일에 구글 서치콘솔에 등록해 네 주소의 색인을 요청했습니다. 4주차 강의는 수강생 발표 다섯 건과 소감 나누기가 중심이었고, 후반에 스터디장이 질문 세트 평가의 요령을 따로 설명했습니다. 이 글은 그 요령 가운데 제 사이트에 바로 댈 수 있는 것을 골라 잰 기록입니다. 측정은 2026년 10월 23일에 했고, 블로그 저장소는 읽기만 했습니다.
2
진행 방법
사용 도구: Python 3, pytest, Jekyll(임시 복사본 빌드), git(읽기), curl, 크롬(구글 검색 화면 확인), Claude Code
Step 1. 강의 기준에서 잴 항목 고르기
4주차 강의에서 제 사이트에 대 볼 수 있는 기준은 다섯 가지였습니다.
4주차 강의 기준 | 이 글에서 한 일 |
|---|---|
측정하는 동안은 기계처럼, 질문을 바꾸지 않는다 | 질문 20개를 그대로 두고 한 문장도 고치지 않음 |
프롬프트에 들어갈 내용이 사이트에 있어야 목록에 오른다 | 질문의 핵심어가 대상 글에 있는지 감사 스크립트로 확인 |
색인되지 않은 페이지는 AI도 찾기 어렵다 | 구글 |
평판이 없는 사이트는 빨리 뜨는 것이 중요하다 | 응답 시간과 전송 크기를 확인 |
보고서는 같은 구조를 재사용한다 | 이번에는 하지 못하고 다음 계획으로 남김 |
질문 20개를 AI에게 처음 묻는 일도 이번에 하지 못했습니다. 챗GPT 임시 채팅은 제 계정 화면에서 직접 해야 하고, 이번 작업은 4주차/실습/ 안에서 끝나는 일로 범위를 잡았기 때문입니다. 대신 AI에게 묻기 전에 확인할 수 있는 것, 즉 대상 글이 열리고 사이트맵에 있고 질문의 말을 담고 있는지를 먼저 점검했습니다.
Step 2. 3주차 계획의 실행 여부 확인
3주차 글을 쓰며 따로 적어 둔 계획 열 가지를 같은 명령으로 확인했습니다.
python3 -I measure_wk4.py        # 3주차 측정 스크립트의 복제. 출력 파일 이름만 바꿈
git log origin/main --since=2026-10-22T00:25:00+09:00 --format='%h %cI %s'
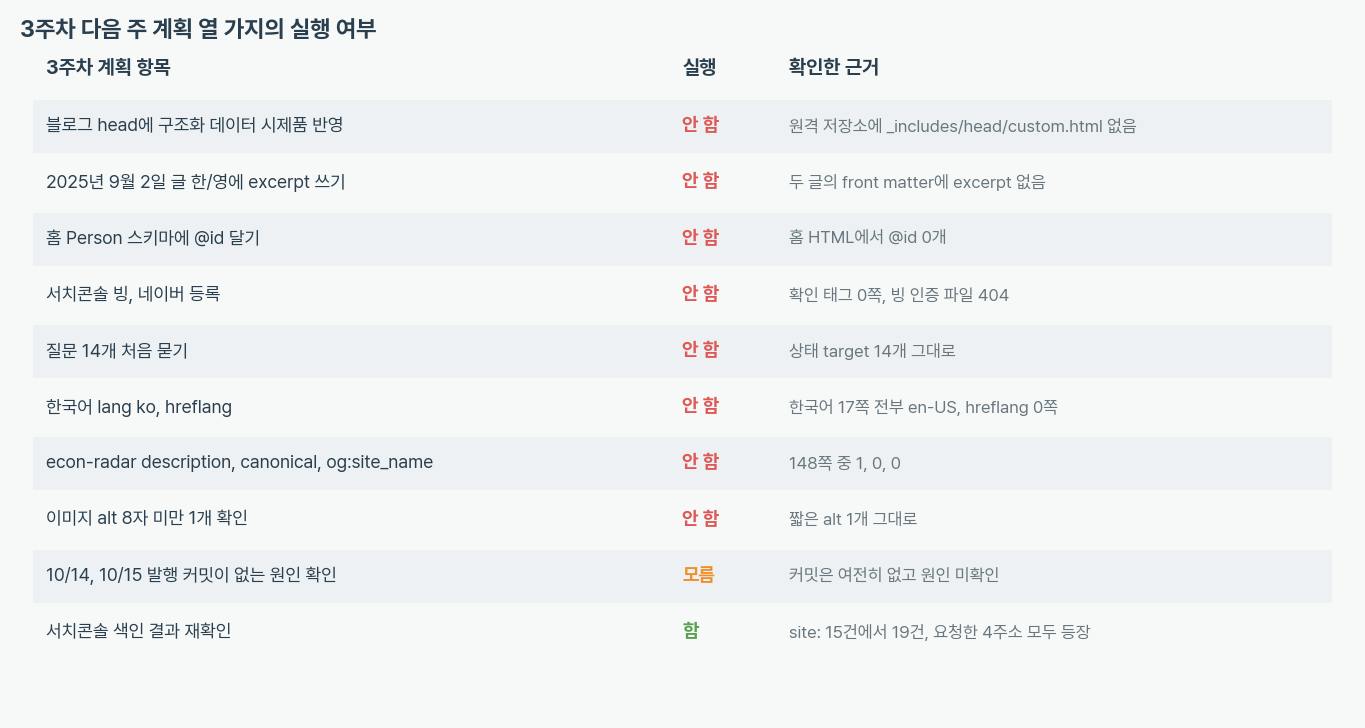
열 가지 가운데 한 일은 색인 재확인 하나이고, 안 한 것이 여덟 개, 모르는 것이 하나입니다. 안 한 여덟 개는 대부분 블로그 저장소를 고쳐야 하는 일이라 읽기만 하기로 한 이번 범위에서는 손대지 않았습니다. 저장소를 고치는 일을 고르지 않은 것은 제 판단입니다. 10월 14일과 15일에 econ-radar 발행 커밋이 없는 원인은 이번에도 저장소를 읽기만 해서는 알 수 없었습니다. 2주차 이후 원격 저장소의 커밋은 11개이고 그중 사람이 한 것이 2개입니다. 하나는 구글 확인 파일을 올린 커밋, 다른 하나는 새 글 한 쌍을 올린 커밋입니다.
Step 3. 3주차 값 다시 재기
curl -s <내 블로그>/sitemap.xml | grep -o "<loc>[^<]*" | wc -l      # 204
curl -s -o /dev/null -w "%{http_code}\n" <내 블로그>/<구글 확인 파일>   # 200
사이트맵 주소는 3주차 199개에서 204개로 5개 늘었습니다. 새 글 한 쌍(한국어와 영어)이 2개, econ-radar가 2개이고 나머지 하나는 기타 페이지입니다. 공개 글은 25편에서 27편이 됐습니다. 한국어 페이지의 lang은 17쪽 전부 en-US이고, hreflang이 있는 페이지는 0쪽, 서치콘솔 확인 태그와 GA 코드가 있는 페이지도 0쪽입니다. 구글 확인 파일은 태그가 아니라 파일 방식이어서 저장소에는 1개가 있고 응답은 200입니다. 글의 BlogPosting은 27편 중 0편, 이미지 53개에 모두 alt가 있고 그중 짧은 alt는 1개로, 3주차와 같았습니다.
Step 4. 서치콘솔 색인 요청 뒤의 구글 결과
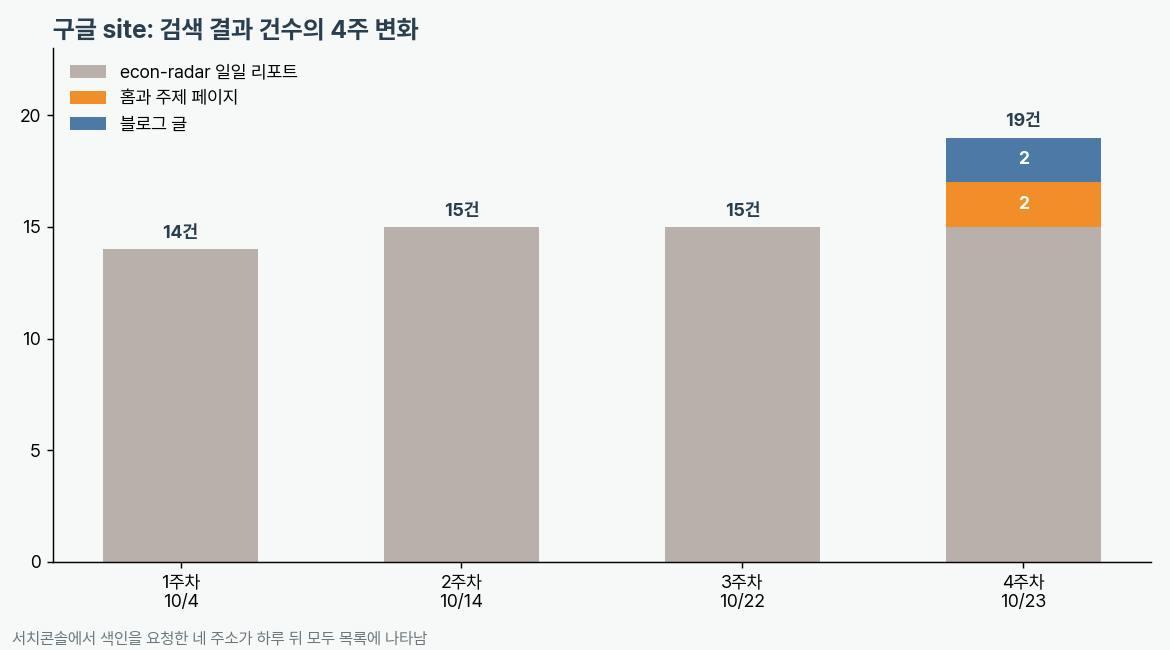
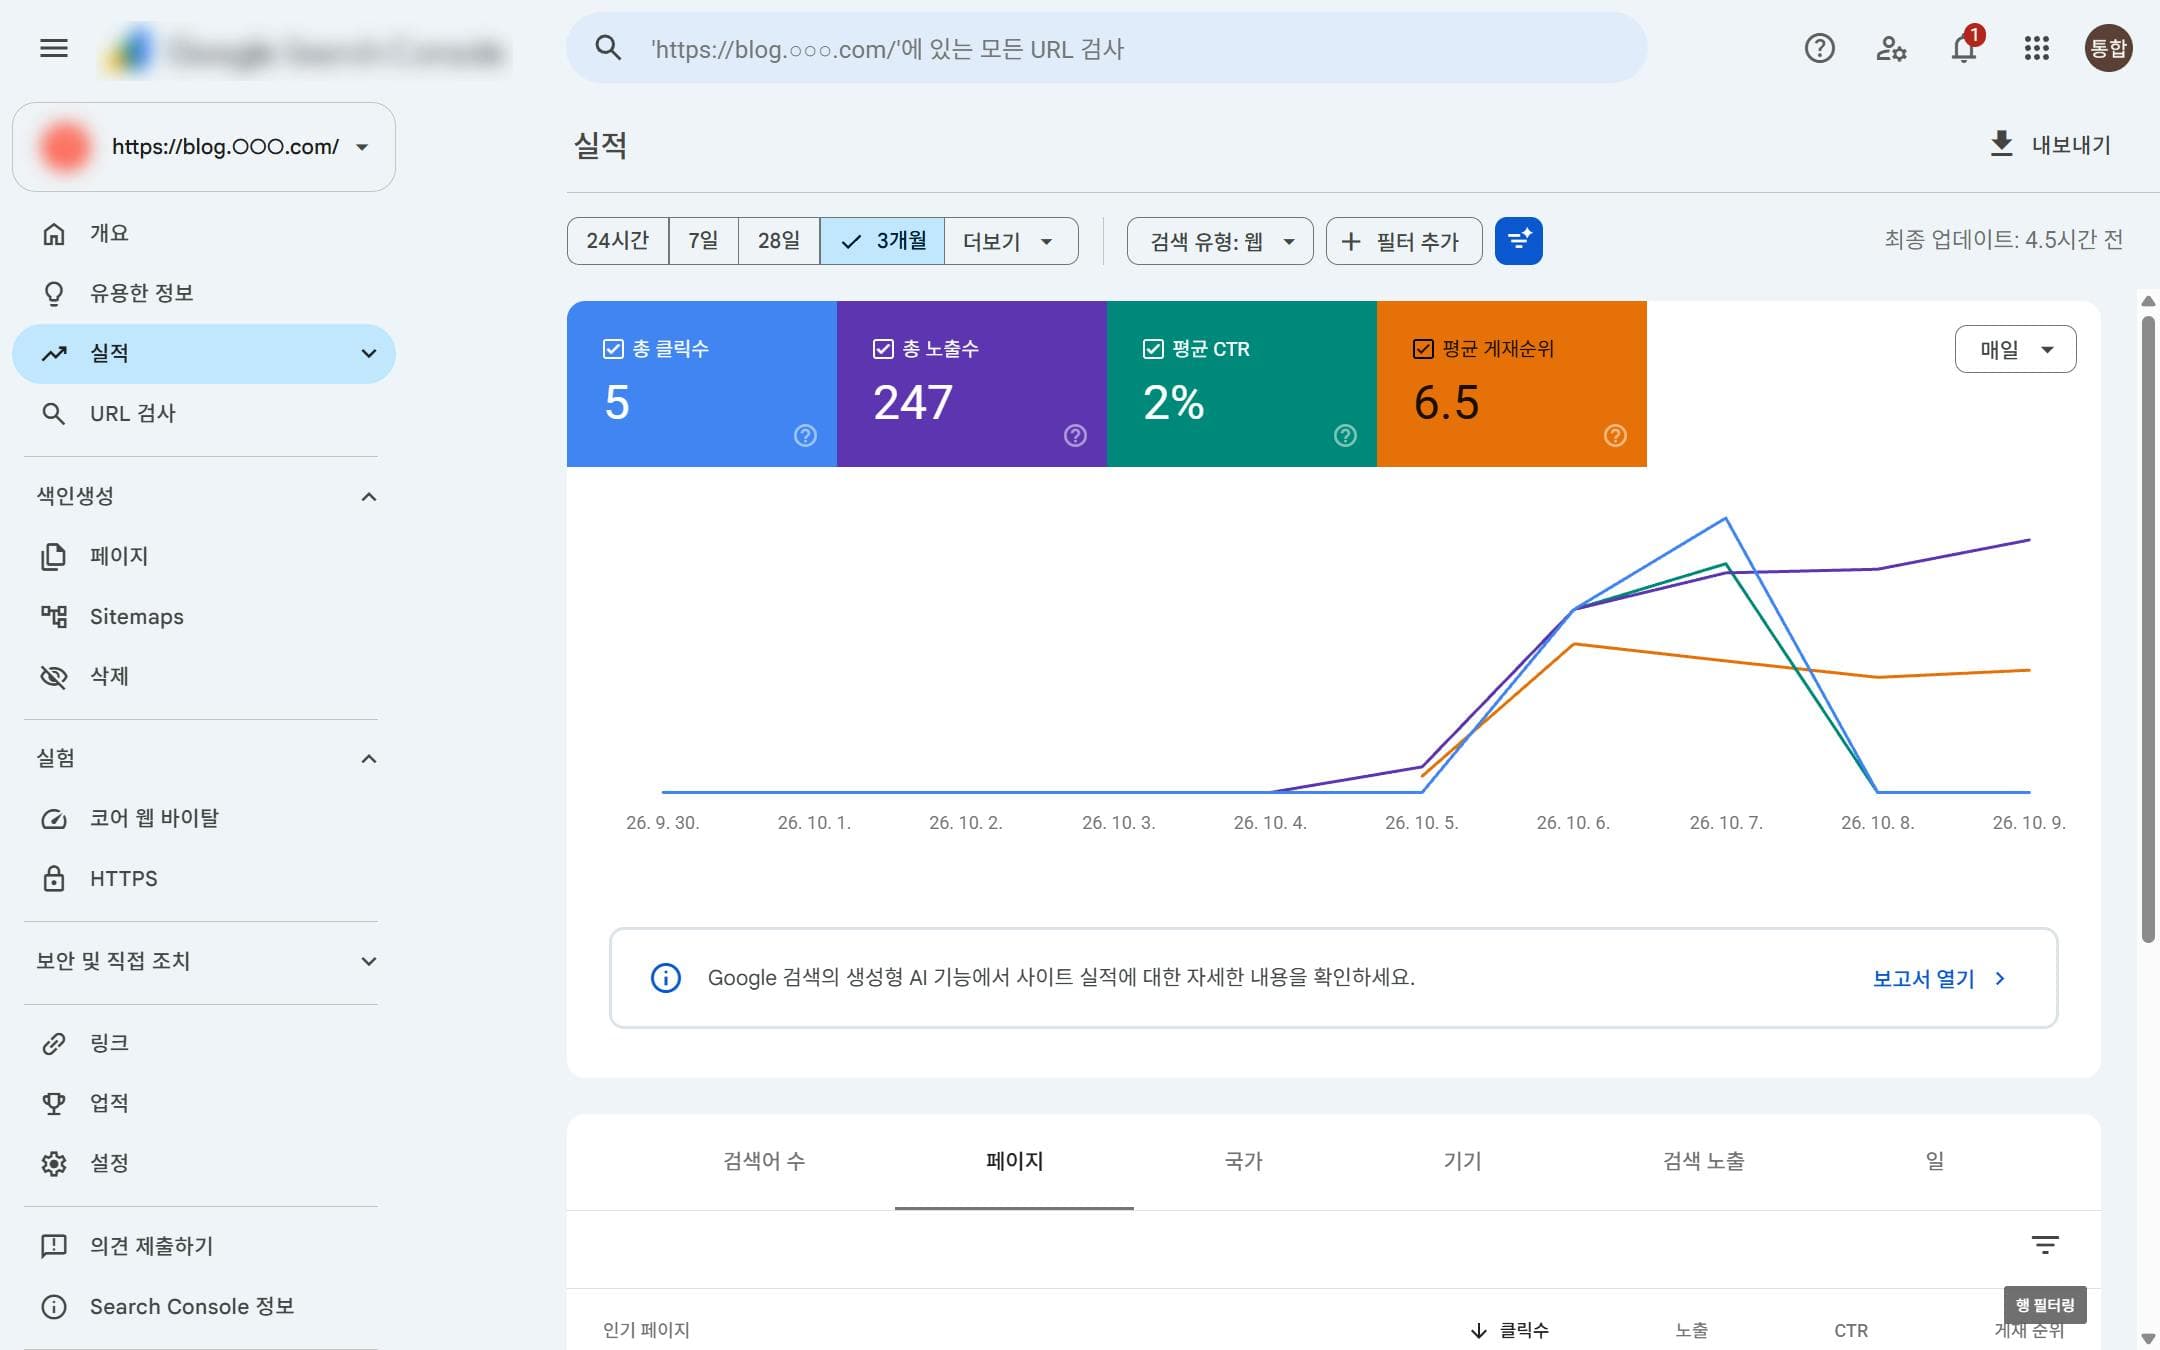
크롬에서 site:<내 블로그>를 직접 검색했습니다. 1쪽 10건과 2쪽 9건으로 모두 19건이 나왔습니다. 3주차까지는 15건이 전부 econ-radar 일일 리포트였는데, 이번에는 15건에 더해 홈, 주제 페이지, 글 두 편이 보입니다. 글 두 편은 3주차에 색인을 요청한 생성형 AI 신약개발 근거 글과 econ-radar 에이전트 하네스 글입니다. 요청한 네 주소가 모두 나타났습니다. site:<내 블로그>/kr/는 3건(주제 페이지와 글 두 편), site:<내 블로그>/en/는 0건이었고 네이버는 0건입니다.
구글은 결과의 주소를 › topics처럼 줄여 보여 주기 때문에, 실제 경로는 /kr/ 검색 결과와 사이트맵의 주소로 맞춰 보았습니다. 요청한 4개는 모두 나타나고 요청하지 않은 글 25편은 한 편도 나타나지 않았으므로, 결과는 색인 요청과 맞아떨어집니다. 다만 하루 사이의 관찰이고 site: 결과는 색인 전체를 보여 주지 않을 수 있어, 요청이 원인이라고 단정하지는 않습니다.
Step 5. 질문 20개의 대상 글 준비도 감사
이번 주에는 3주차에 만든 질문 세트에서 질문마다 붙은, 답이 있어야 할 글의 주소(target)를 골라 다섯 가지를 확인하는 스크립트를 만들었습니다. 대상 글이 열리는지, 사이트맵에 있는지, 구글 목록에 있는지, 질문의 핵심어가 글의 제목과 첫 문단과 소제목에 들어 있는지, 본문 전체에는 들어 있는지입니다. 앞의 셋은 참값이 파일과 응답에 있는 확인이어서 시험으로 걸 수 있고, 마지막 둘은 낱말이 포함되는지만 보는 거친 신호라서 정의를 시험으로 고정했습니다.
시험을 먼저 썼습니다. 모의 페이지(제목, 첫 문단, 소제목 둘, 본문)를 만들어 일치율의 참값을 손으로 정했습니다. 예를 들어 질문 핵심어 네 개 가운데 제목에 둘, 본문까지 셋이 있으면 앞부분 일치율은 0.5, 본문 일치율은 0.75입니다.
python3 -I -m pytest -q test_readiness.py
Interrupted: 1 error during collection        (구현 전, 모듈이 없음)
1 failed, 5 passed                            (구현 직후, 조사를 떼는 시험 하나 실패)
8 passed                                      (조사 처리를 고친 뒤, 어미 시험 2개 추가)
구현 직후 "글은"에서 조사 "은"을 떼면 한 글자가 남는 경우를 처리하지 못해 시험 하나가 실패했고, 고친 뒤 통과했습니다. 한국어 어미 변화("재현해", "과대평가되나")를 어간으로 맞추는 시험 두 개를 더한 뒤에는, 옛 판정(부분 문자열)으로 되돌린 복사본에서 시험 하나가 실패하는 것을 확인하고 통과시켰습니다. 영어 낱말 시험은 옛 판정에서도 통과해서 판정을 바꾸는 근거는 되지 못했습니다.
python3 -I readiness.py --questions ai_questions_20.json --google google_site_20261023.txt \
        --base <내 블로그> --out ../assets/준비도_4주차.json
# {'weak_match': 13, 'indexed_weak_match': 1, 'indexed': 3, 'ready_not_indexed': 3}
구글 목록은 Step 4에서 크롬으로 본 결과를 파일에 옮긴 것입니다. 스크립트는 AI에게 묻지 않고 공개 주소만 읽습니다.
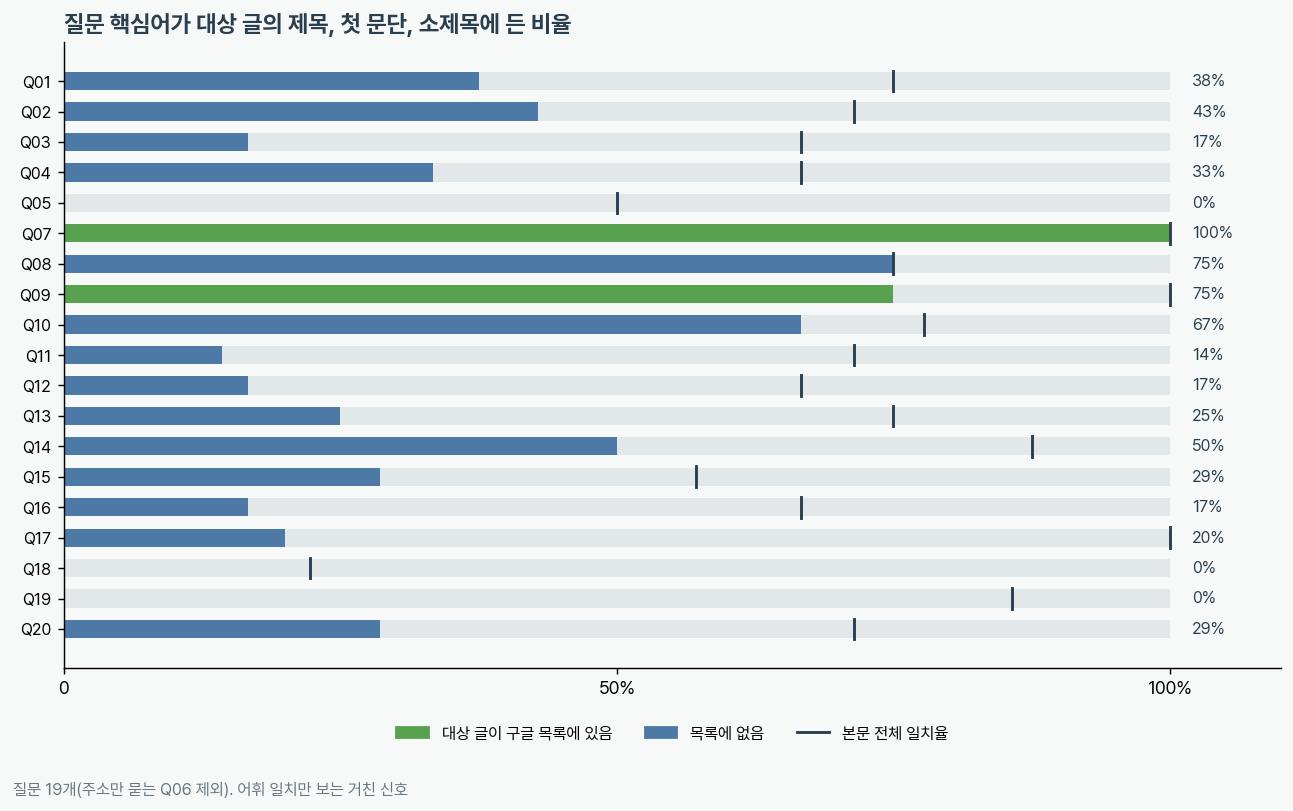
질문 20개가 가리키는 주소는 13개입니다. 질문 6번은 주소만 묻는 질문이라 핵심어가 없어 일치율에서 빼서 19개를 보면, 앞부분 일치율의 평균이 34퍼센트이고 본문 전체 평균은 73퍼센트입니다. 앞부분 일치율이 50퍼센트 이상인 질문은 5개입니다. 대상 글이 구글 목록에 있는 질문은 5번과 6번(둘 다 홈), 7번, 9번(생성형 AI 신약개발 글)의 4개이고, 이 가운데 7번은 일치율이 100퍼센트, 9번은 75퍼센트입니다. 나머지 판정은 이렇습니다.
판정 | 질문 수 | 뜻 |
|---|---|---|
색인되고 일치율 높음 | 3 | 7번, 9번, 그리고 핵심어가 없어 일치율을 계산하지 않은 6번(홈) |
색인되었지만 일치율 낮음 | 1 | 5번(홈). 질문의 "연구 노트"가 홈 앞부분에 없음 |
일치율은 충분하나 구글 목록에 없음 | 3 | 8번, 10번, 14번. 색인 요청 후보 |
구글 목록에도 없고 일치율도 낮음 | 13 | 질문과 글 사이에 낱말이 안 맞음 |
질문 18번("의생명 데이터 분석가가 AI 에이전트로 검증 루프를 만드는 사례")은 대상 글의 본문에서도 아홉 개 핵심어 가운데 일곱 개가 빠져 22퍼센트에 그쳤습니다. 질문이 글에 비해 넓거나 대상 주소를 잘못 골랐을 수 있습니다. 질문 19번은 hreflang이 본문에는 있지만 제목, 첫 문단, 소제목에는 없어 앞부분 일치율이 0퍼센트였습니다.
Step 6. 시제품의 새 글 적용과 응답 시간
3주차에 만든 BlogPosting 시제품을 원격 저장소의 새 상태(글 27편)에 같은 명령으로 다시 빌드했습니다.
python3 -I prototype_build.py
기준 빌드에서는 BlogPosting이 읽히는 글이 0편이고, 시제품 빌드에서는 27편 전부가 제목, 날짜, 언어, 주소, 저자, 키워드가 글 파일의 front matter와 일치했으며 BreadcrumbList도 27편 전부였습니다. 전체 201쪽 중 달라진 페이지는 27쪽이고 전부 글 페이지였습니다. 3주차 이후 늘어난 두 편에도 수정 없이 통과했다는 점이 이번 재확인에서 새로 얻은 값입니다.
속도는 구글 페이지 스피드 인사이트의 무료 호출이 일일 한도 초과(429)로 막혀 재지 못했습니다. 대신 curl로 서버 응답만 재 보았습니다.
페이지 | 첫 바이트까지 | 전체 | 전송 크기 |
|---|---|---|---|
홈 | 0.052초 | 0.064초 | 80,244바이트 |
주제 페이지 | 0.046초 | 0.047초 | 12,606바이트 |
글(신약개발 근거) | 0.054초 | 0.055초 | 27,826바이트 |
글(에이전트 하네스) | 0.044초 | 0.049초 | 29,659바이트 |
정적 사이트라 서버 응답은 빠릅니다. 이 값은 이미지와 글꼴을 내려받고 화면을 그리는 시간을 포함하지 않으므로, 스터디장이 말한 "사이트가 뜨는 속도"와는 다른 값입니다.
결과와 배운 점
측정 결과 (2026-10-23, 사이트맵 204개 주소와 그중 글 27편)
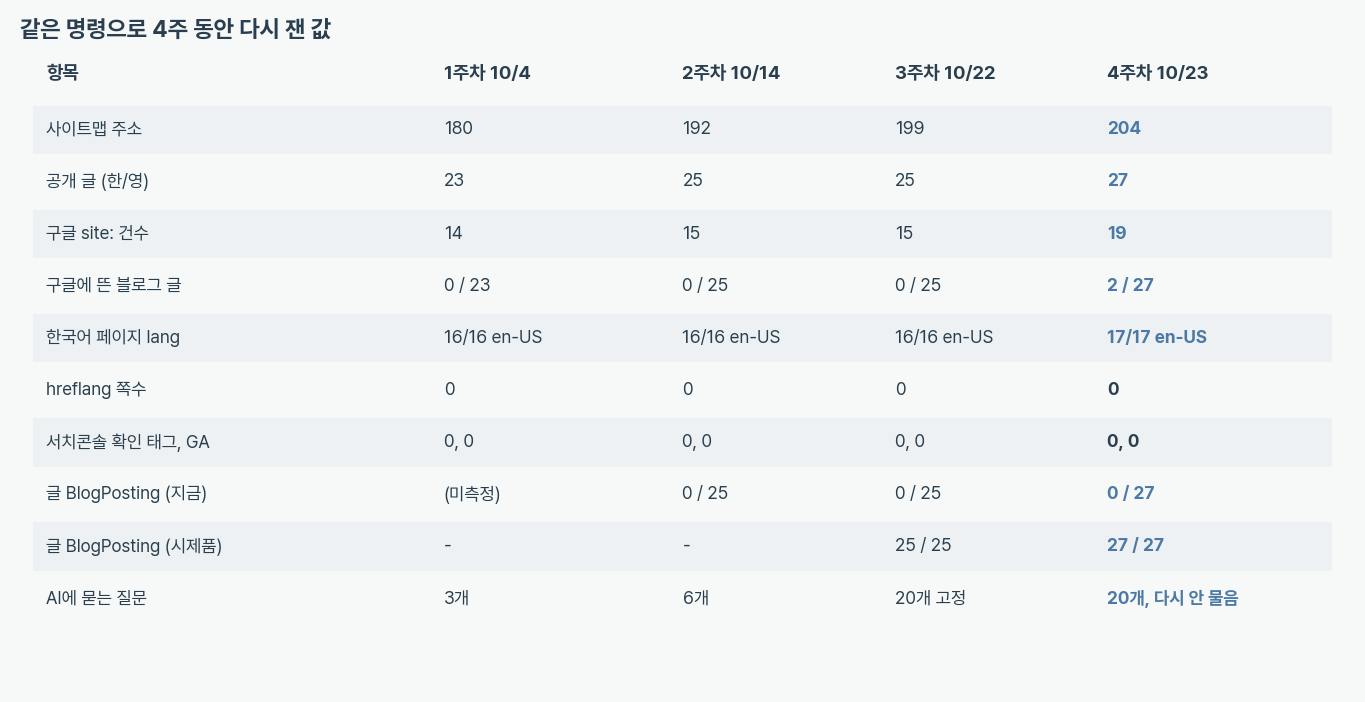
4주 동안 움직인 것은 사이트맵 주소 수와 구글 목록입니다. 한국어 페이지의 lang, hreflang, 서치콘솔 확인 태그, GA, 글의 BlogPosting은 4주 동안 그대로이고, 홈 @id는 3주차와 같은 값입니다. 이 결과는 2026-10-23의 사이트맵 주소 204개, 구글과 네이버의 site: 검색 한 번씩, 원격 저장소 origin/main의 글 27편, 질문 20개가 가리키는 주소 13개를 기준으로 합니다. AI 채팅 서비스에 질문을 묻는 측정은 이번에도 하지 않았으므로 "AI가 인용하는가"는 아직 값이 없습니다.
배운 점
색인 요청은 효과가 있어 보입니다. 요청한 4개 주소는 하루 사이 모두 구글 목록에 나타났고, 요청하지 않은 글 25편은 한 편도 나타나지 않았습니다. 3주차 글에서 "스키마를 넣어도 색인은 별개"라고 적었는데, 이번 변화는 스키마보다 색인을 먼저 풀어야 할 수 있다는 쪽을 가리킵니다. 다만 표본이 4개이고 기간이 하루여서 이 결과는 가설로 남깁니다.
질문과 글 사이에 낱말이 안 맞는 경우가 많았습니다. 질문 19개의 앞부분 일치율 평균이 34퍼센트였습니다. 스터디장이 "프롬프트에 들어가는 내용이 사이트에 있어야 한다"고 한 말을 낱말 수준에서 재 본 값입니다. 질문 문장이 글 제목을 되풀이할 필요는 없지만, 검색하는 사람이 쓸 법한 말이 글의 제목과 소제목에 하나도 없으면 AI가 글을 후보로 올릴 근거가 약할 수 있습니다. 다만 AI 채팅 서비스에 직접 묻는 측정은 하지 않아 이 글에서는 확인하지 못했습니다. 다음 단계는 질문을 바꿀지 글의 소제목을 고칠지 질문별로 정하는 일이고, 질문을 바꾸면 질문 세트가 고정이라는 규칙과 부딪히므로 측정을 시작하기 전에 정해야 합니다.
현재 구글 목록에 있는 두 주소가 일치율도 가장 높았습니다. 질문 7번(100퍼센트)과 9번(75퍼센트)입니다. 주소가 둘뿐이라 일치율이 색인을 낳았다고 말할 수는 없고, 오히려 3주차에 요청한 글이 제목이 분명한 글이었다는 선택 효과일 수 있습니다.
시험으로 정의를 고정하면 거친 신호라도 무엇을 재는지는 분명해집니다. 어휘 일치는 해석이 들어가는 신호이지만, "일치율이란 무엇인가"는 참값을 손으로 정한 모의 페이지로 고정할 수 있었습니다. 시험이 없었다면 "글은"처럼 조사가 남는 낱말이 계속 일치율을 낮췄을 수 있습니다.
시제품은 새 글에도 그대로 통과했습니다. 글 27편 전부 front matter와 일치하므로, 블로그에 반영하는 일은 이제 제가 시점만 정하면 됩니다.
시행착오
구글이 주소를
› topics처럼 줄여 보여 주어, 처음에는 이 주소가 실제로 열리는지 알 수 없었습니다.curl로 열어 보니 404였고,/kr/검색과 사이트맵에서/kr/topics/형태로 맞춰서야 결과를 믿을 수 있었습니다.페이지 스피드 인사이트의 일일 한도 때문에 속도 값을 얻지 못해 서버 응답 시간으로 대신했고, 이 한계를 표 아래에 적었습니다.
질문 6번은 주소만 있는 질문이라 핵심어가 없어, 일치율 평균에서 빼야 했습니다.
질문 20개를 AI에게 묻는 측정, HTML 보고서 템플릿, 저장소 수정은 이번에 하지 못했습니다. 계획은 따로 정리했습니다.
도움 받은 글
24기 GEO실험실 4주차 강의 (스터디장 체크, 버디 엔지): 측정 중 질문을 고정하는 규율, 프롬프트에 들어갈 내용이 사이트에 있어야 한다는 기준, 페이지 속도, HTML 보고서의 재사용
24기 GEO실험실 4주차 수강생 발표: 같은 질문을 일주일 간격으로 다시 묻는 운영(쇼핑몰 발표)과 검수 담당 AI를 두는 방식(이리 E LEE 님)을 비교 기준으로 삼음
24기 GEO실험실 3주차 사례글 (본인)과 2주차 글의 댓글 (체크check 님의 서치콘솔 URL 검사 제안): 이번 색인 요청의 출처이자 비교 기준

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

안녕하세요, Fri-mer님! AI 노출 질문 세트를 감사 스크립트로 점검하신 글 잘 읽었어요.
질문 20개를 한 문장도 고치지 않고 그대로 둔 채 "그 질문이 가리키는 글이 답할 준비가 되어 있는가"를 따로 본 발상이 좋았어요. 사이트맵이 199개에서 204개로 늘고 site: 결과가 15건에서 19건이 된 것처럼, 색인 요청 뒤의 변화를 같은 명령으로 비교하신 것도 설득력 있었습니다.
3주차 계획 열 가지 중 한 일 1, 안 한 일 8, 모르는 일 1로 솔직하게 적으신 것도, 저장소를 읽기만 하기로 한 범위를 지키신 것도 인상 깊었어요. 꼬리 탁! 치고 응원하고 갑니다 🐈⬛