


작성일: 2026-05-29
사용 도구: Claude Code (Opus 4.7, 1M 컨텍스트) + Vercel + GitHub
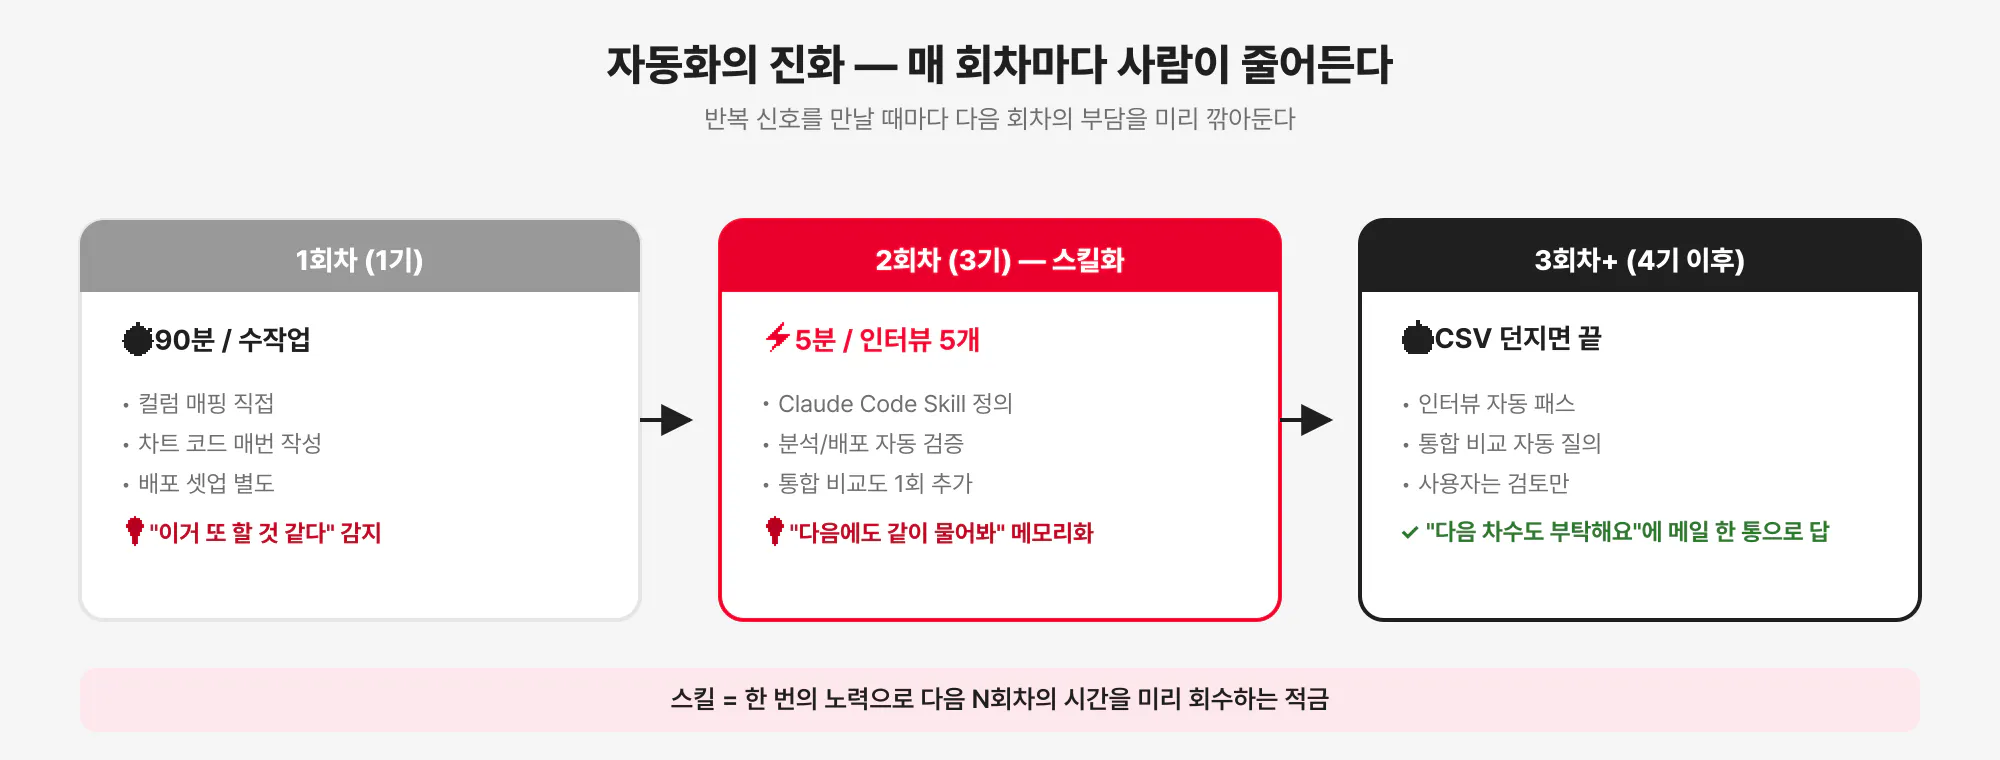
소요 시간: 첫 차수 분석 90분 → 스킬 정착 후 5분 (2회차 기준)
1. 어떤 일을 했나
어느 교육 의뢰사의 AI Agent 양성 캠프 사전·사후 설문 분석을 의뢰받았습니다. 한 회차당 10문항 5점 리커트 척도 자가 진단을 사전·사후로 받고, 학습자 ID로 매칭해서 영역별·문항별·개인별 변화량을 측정해 보고서와 인터랙티브 대시보드를 만드는 일이었습니다.
1회차(1기)를 4월에 처음 작업할 때는 매번 다른 컬럼 구조·매핑 방식 때문에 90분 가까이 걸렸는데, 이번에 3회차(3기) 의뢰가 들어오면서 이걸 두 번째 하는 거구나 싶었습니다. 그래서 작업 시작 전에 재사용 가능한 스킬로 먼저 정리한 다음 분석에 들어갔습니다.
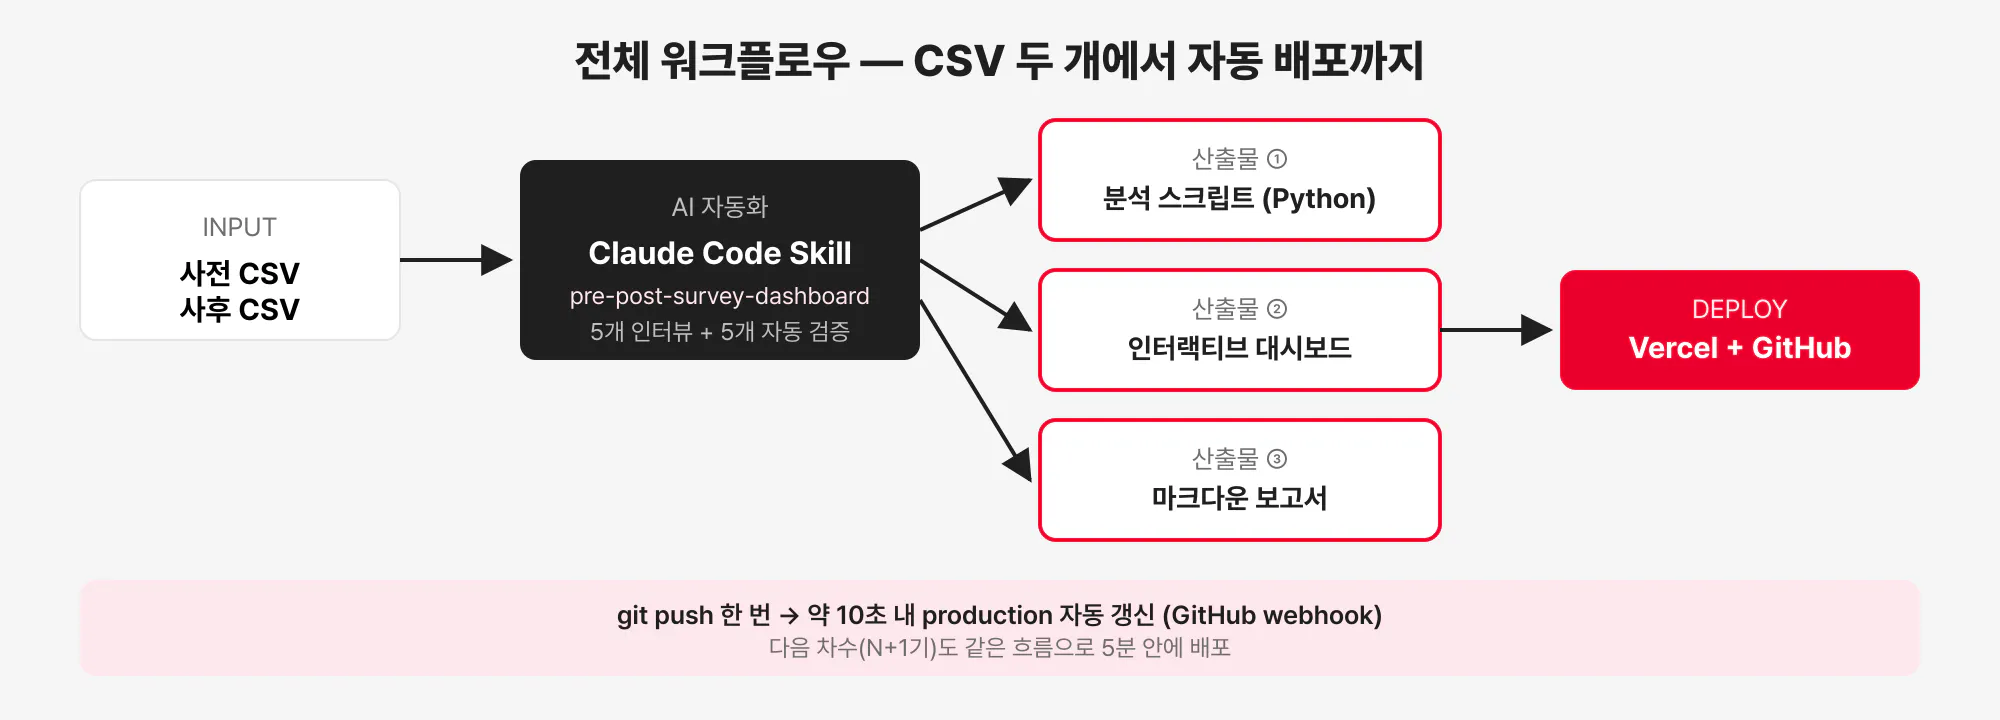
최종 산출물 3종:
3기 단독 분석 대시보드 (인터랙티브 Chart.js)
3기 분석 보고서 (마크다운)
1기·3기 통합 비교 대시보드 (의뢰사가 차수 간 추세를 보고 싶어 함)
2. Before — 매번 다른 컬럼, 매번 다른 매핑
설문 데이터는 보통 Google Forms 응답 시트로 옵니다. 매번 회차마다:
헤더 컬럼명이 미묘하게 다름
학습자 ID 컬럼 위치가 다름
같은 영역이라도 문항 자체가 일부 교체되어 있음 (예: 사내 AI Agent 빌더 도구 명칭이 회차별로 바뀌어 1기 사전·3기 사전 문항이 다름)
Likert 응답 텍스트 표기가 조금씩 다름
손으로 매번 매핑해주면 정확도는 나오지만 시간이 잡아먹히고, 무엇보다 2회차에 들어가는 순간 "이걸 또 하네" 싶은 느낌이 강했습니다.
3. Process — 스킬 먼저, 분석은 그 다음
Step 1: 스킬부터 만들고 시작
Claude Code의 Skills 2.0 기능으로 pre-post-survey-dashboard라는 스킬을 먼저 정의했습니다. 핵심은 다음과 같은 인터뷰 단계를 표준화하는 것:
이 다섯 가지가 정해지면 분석 스크립트가 자동으로 생성되고, 결과물 4종(분석 스크립트, 인터랙티브 대시보드 HTML, 마크다운 보고서, Vercel 배포 설정)이 한 번에 떨어지게 만들었습니다.
Step 2: 3기 분석 — 인터뷰 5개 답하고 끝
스킬을 호출한 뒤 실제 대화는 이게 전부였습니다.
입력한 프롬프트:
Claude가 자동으로:
두 CSV의 헤더와 첫 3행을 읽어 학습자 ID 컬럼 인덱스, Likert 문항 범위, 만족도·정성 응답 컬럼을 식별
빈 컬럼·메타 행("평균", 임시 행 등)을 자동 제외
영역(지식·기술·적용)과 키워드를 1기 분석 결과를 참고해 자동 매핑
분석 스크립트 생성·실행
HTML 대시보드 + 마크다운 보고서 생성
검증은 자동으로 4가지:
학습자 ID(7자리 사번)가 HTML에 노출되지 않는지 (마스킹 검증)
합계가 수동 재계산 결과와 일치하는지
마크다운 볼드(...)가 모두 으로 변환됐는지
차트 데이터의 문항 수가 입력과 일치하는지
Step 3: 배포 자동화
이후 git push 한 번에 10초 안에 production 자동 갱신. 빈 커밋으로 webhook 작동을 검증하는 단계까지 스킬에 포함시켰습니다.
Step 4: 통합 비교 대시보드 (보너스)
3기 분석 후 의뢰사 측에서 "1기와 비교하면 어떤가?"가 따라올 게 보였습니다. 한 번 더 요청하면 같은 작업이 반복될 게 뻔하니, 신규 차수 분석 직후 항상 "통합 비교 보고서도 갱신할까요?"라고 묻도록 메모리에 박아뒀습니다. Claude Code의 자동 메모리 시스템(~/.claude/.../memory/MEMORY.md)에 feedback 타입으로 저장되어 다음 차수(4기)에도 같은 흐름이 자동으로 작동합니다.
4. After — 결과 및 인사이트
분석 결과 (마스킹 처리됨)
지표: 매칭 응답자 · 1기: 14명 · 3기: 18명 · 차이: +4
지표: 종합 사전 평균 · 1기: 2.34 · 3기: 2.05 · 차이: −0.29
지표: 종합 사후 평균 · 1기: 4.41 · 3기: 3.98 · 차이: −0.43
지표: 종합 향상폭 Δ · 1기: +2.07 · 3기: +1.93 · 차이: −0.14
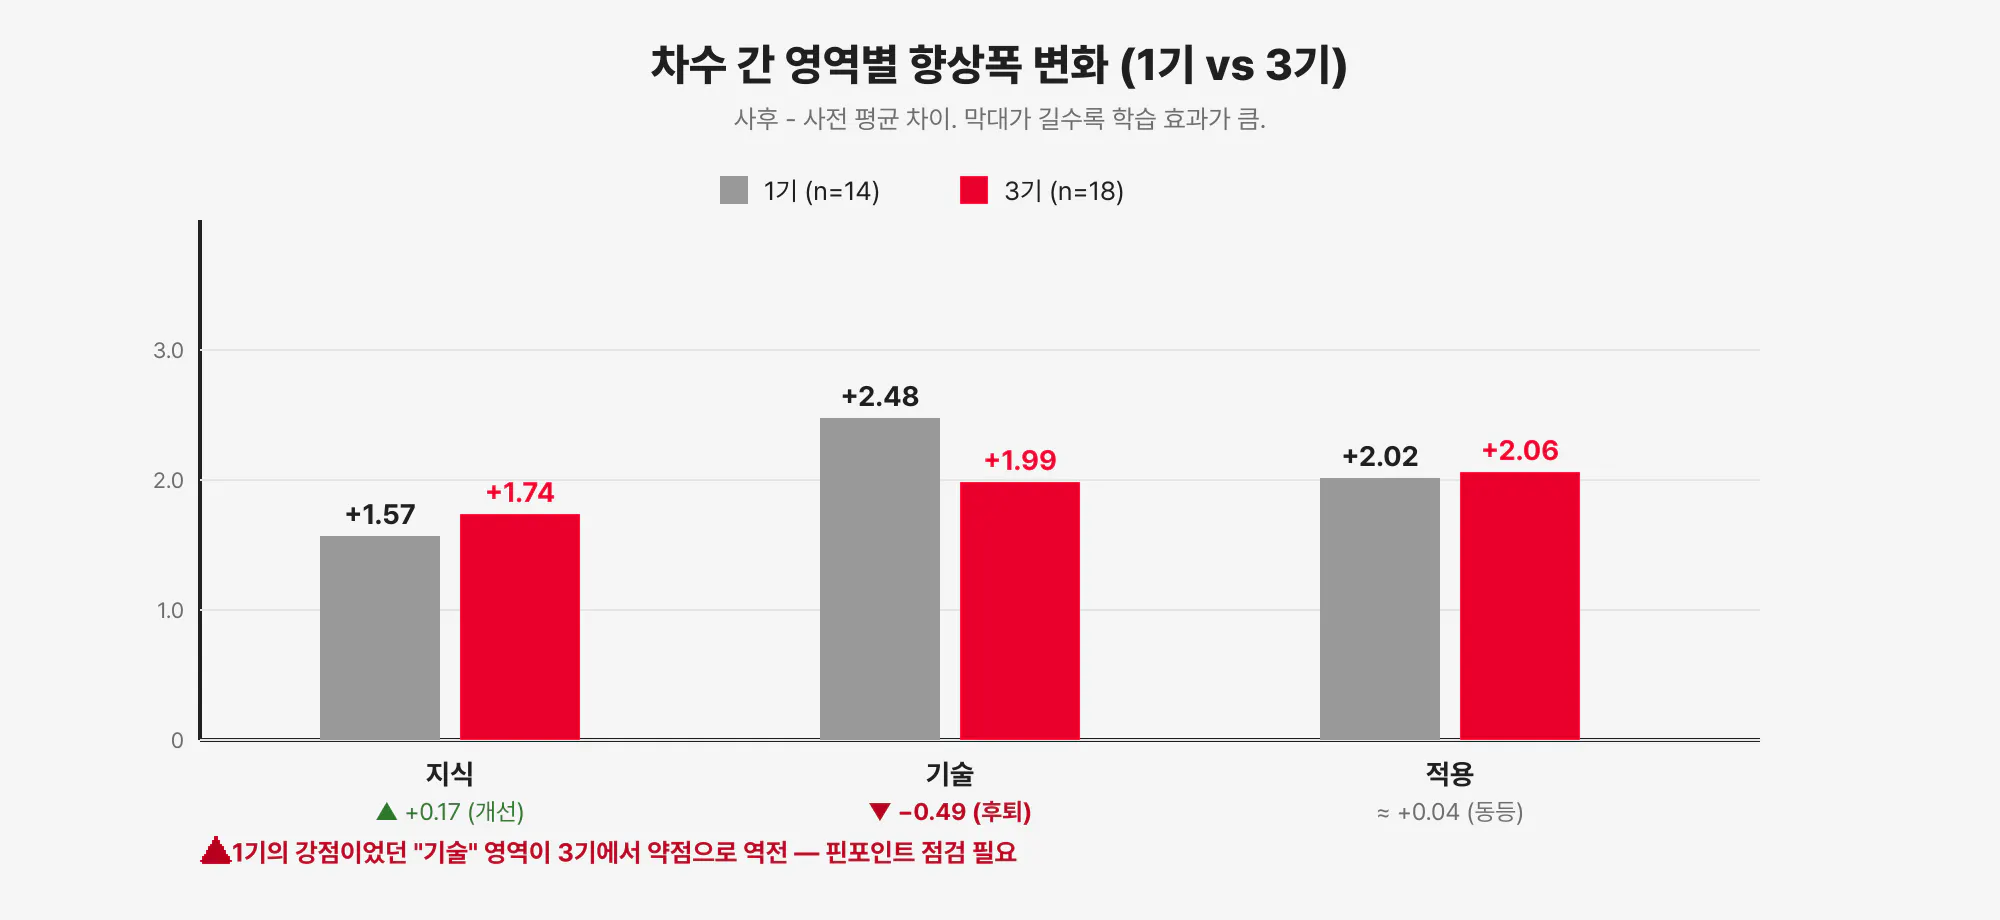
영역별로 보면:
지식 향상폭: +1.57 → +1.74 (개선)
기술 향상폭: +2.48 → +1.99 (-0.49 후퇴) ← 가장 큰 시그널
적용 향상폭: +2.02 → +2.06 (안정)
가장 큰 발견은 1기에서 강점이었던 "기술" 영역이 3기에서 약점으로 역전됐다는 것. 특히 사내 빌더 도구 활용 문항이 사후 점수 1점 이상 격차로 후퇴했는데, 이건 1기·3기 사이에 도구 자체가 바뀐 영향이 있어 핀포인트 점검이 필요합니다.
정량 비교
항목: 1차수 분석 소요 시간 · Before (수동): 90분 · After (스킬화 후): 5분
항목: CSV 컬럼 매핑 정확도 · Before (수동): 수동, 매번 실수 가능 · After (스킬화 후): 자동 추론 + 인터뷰 검증
항목: 디자인 일관성 · Before (수동): 매번 다른 톤 · After (스킬화 후): 의뢰사 BI 자동 적용
항목: 배포 셋업 · Before (수동): 30분 · After (스킬화 후): 1분 (push 한 번)
항목: 차수 간 비교 보고서 · Before (수동): 별도 수작업 · After (스킬화 후): 자동 질의 + 데이터 누적
회고 — 인상 깊었던 점
(1) "두 번째인데 이걸 또 하네" 신호를 놓치지 말기. 한 번 더 할 일이 보이면 그 자리에서 스킬로 정리. 3번째에 다시 하면 4번째도 손으로 합니다.
(2) "다음에 같이 물어봐줘"는 메모리에 박는다. "통합 비교 보고서도 갱신할까요?"라는 한 줄을 사용자한테 매번 부탁받지 않게 메모리화. 이게 진짜 자동화의 핵심. 4기·5기 분석할 때도 같은 흐름이 자동으로 작동합니다.
(3) 디자인은 의뢰사 BI를 기본으로. 클라이언트가 자기 색상·폰트로 된 대시보드를 받는 순간 "내 거구나"라는 감각이 생깁니다. 이 디테일이 다음 차수 의뢰로 이어집니다.
5. Next Step
4기 분석 들어오면 같은 스킬로 5분 안에 보고서·대시보드·통합 비교 갱신까지 끝낼 예정
스킬 자체를 다른 교육·캠프 의뢰사에도 재활용할 수 있도록 디자인 토큰만 9개 변수로 빼둠 (브랜드 컬러 2개 + 폰트만 바꾸면 전체 톤 전환)
정성 응답(좋았던 점, 개선 요청, 정량 기대효과)은 보고서(마크다운)에만 포함하고 대시보드(HTML)에는 노출 안 함 — 외부 공유 시 개인 식별 위험 차단
마치며
업무의 핵심은 분석이 아니라 "한 번 만든 흐름을 다음에도 자동으로 작동하게 만드는 것"입니다. CSV 두 개만 던지면 보고서·대시보드·배포·차수 간 비교까지 자동으로 굴러가는 흐름을 한 번 만들어두니, 의뢰사가 "다음 차수도 부탁해요"라고 했을 때 30분 회의 잡지 않고 메일 한 통으로 답할 수 있는 상태가 됩니다. 그게 1인 운영자에게 가장 비싼 자산이라고 생각합니다.
_본 사례글은 의뢰사·내부 도구·학습자 식별정보를 모두 가명/일반화 처리했습니다._
